

Observabilidade de software é a capacidade de entender o comportamento de uma aplicação e dos serviços que a compõem a partir de traces, métricas e logs ligados por um contexto comum. Ela explica por que algo mudou, e não apenas o que quebrou, o que permite correlacionar uma degradação com a mudança e a chamada que a provocaram.
Comparar horários de deploy com horários de reclamação é um método comum, e ele falha quando dezenas de serviços publicam no mesmo dia. A observabilidade de software é o que substitui essa comparação por evidência de qual serviço e qual chamada degradaram.
Uma aplicação distribuída reúne dezenas de serviços, cada um com seu ciclo de publicações. Quando algo degrada, o time precisa saber qual serviço, qual chamada e qual mudança provocaram o problema, e sem essa resposta a investigação vira palpite.
Cada perfil chega a essa pergunta por um lado. Para o CIO, o CTO e o CEO, o que está em jogo é o risco de cada lançamento em sistemas críticos. Para o gerente de infraestrutura, é como o software consome recursos. Para o profissional DevOps, é decidir se a publicação segue ou volta atrás, e para o Site Reliability Engineer, ou SRE, é achar a causa sem adivinhar.
O que é observabilidade de software e como ela se diferencia do monitoramento
Observabilidade de software é a capacidade de entender o comportamento interno de uma aplicação e dos serviços que a compõem a partir da telemetria que eles emitem. O resultado prático é saber em qual serviço, em qual chamada e por qual mudança uma requisição ficou lenta.
Definição e o papel da telemetria
Segundo a documentação do OpenTelemetry, observabilidade é a capacidade de entender um sistema de fora, fazendo perguntas sobre ele, sem precisar conhecer o seu funcionamento interno. A matéria-prima dessas respostas é a telemetria, ou seja, os dados que um sistema emite sobre o próprio comportamento, na forma de traces, métricas e logs.
Em microsserviços, essa capacidade deixou de ser opcional por um motivo simples de verificar: nenhum engenheiro guarda na cabeça todos os caminhos que uma requisição pode percorrer entre dezenas de serviços, e o código muda com frequência.
Monitoramento diz o que quebrou, observabilidade ajuda a explicar por quê
O livro Site Reliability Engineering, do Google, define o que um bom sistema de monitoramento precisa responder: o que está quebrado, que é o sintoma, e por quê, que é a causa, possivelmente intermediária. As duas perguntas pedem coisas diferentes.
| Aspecto | Monitoramento | Observabilidade |
|---|---|---|
| Pergunta que responde | O que está quebrado, que é o sintoma | Por quê, que é a causa, possivelmente intermediária |
| Como se prepara | Alertas definidos de antemão, sobre sinais conhecidos | Dados ricos e conectados, para perguntas não previstas na configuração |
| Exemplo em pagamentos | Um alerta de latência alta no processamento | A descoberta de que a lentidão começou com uma mudança específica, num serviço específico |
| Quem age com a resposta | O plantão, que sabe que precisa agir | O time de desenvolvimento, que decide se a publicação segue ou volta atrás |
A última linha explica por que as duas capacidades não se substituem. O monitoramento mobiliza quem está de plantão, e a observabilidade mobiliza quem escreveu o código, e um incidente de software precisa dos dois.
Como funciona a observabilidade de software
O mecanismo tem três partes que se encaixam: o código passa a emitir telemetria, os sinais são ligados entre si por um contexto compartilhado e a leitura de uma degradação segue um roteiro.
Instrumentação: como o código passa a emitir telemetria
Instrumentar é fazer a aplicação emitir telemetria, como as câmeras instaladas na fábrica registram cada etapa da produção. A documentação do OpenTelemetry descreve duas abordagens.
A instrumentação sem código, ou zero-code, fornece telemetria das bibliotecas usadas e do ambiente. Serve para começar e para os casos em que o código não pode ser modificado.
A instrumentação baseada em código chama a API do OpenTelemetry dentro da própria aplicação e dá mais profundidade, nos pontos em que o negócio exige detalhe.
As duas se combinam, e é essa combinação que responde ao receio mais comum em adoções de software: dá para começar sem alterar o código e aprofundar depois, serviço a serviço, nos pontos que importam.
Os três sinais e o contexto que os liga
Um trace distribuído registra o caminho percorrido por uma única requisição por vários serviços, e cada span é uma unidade de trabalho ou operação dentro dessa requisição, com nome, dados de tempo e atributos.
As métricas são agregações, ao longo de um período, de dados numéricos sobre a infraestrutura ou a aplicação, como taxa de erros, uso de processamento e taxa de requisições. Os logs são mensagens com marca de tempo emitidas por serviços e outros componentes, e ficam mais úteis quando correlacionados a um trace ou a um span.
O que liga os sinais entre serviços é a propagação de contexto. O propagador padrão usa os cabeçalhos da especificação W3C Trace Context, e é isso que permite reconstruir o caminho completo de uma requisição. Sem ela, o trace fica incompleto e aparece o span órfão.
O roteiro de leitura de uma degradação
Confiabilidade responde se o serviço faz o que os usuários esperam, e um sistema pode estar sempre no ar e ainda assim ser pouco confiável. Por isso a medição se baseia no comportamento percebido, e não na disponibilidade do processo.
O indicador de nível de serviço, ou SLI, é a medição desse comportamento, idealmente da perspectiva do usuário, e o objetivo de nível de serviço, ou SLO, é o valor-alvo ou a faixa de valores desse indicador.
Com essas peças no lugar, ler uma degradação deixa de ser improviso e passa a seguir cinco passos.
- O objetivo de nível de serviço desvia, e esse desvio é o gatilho da investigação, não a reclamação do usuário.
- O mapa de dependências mostra por onde a requisição passa e quais serviços estão no caminho.
- O trace aponta a chamada que atrasou, dentro daquele caminho.
- As métricas e os logs correlacionados àquele span explicam o motivo.
- A comparação com a publicação mais recente indica se a mudança foi a origem.
O primeiro passo é o que muda a natureza do plantão. Enquanto o gatilho é a reclamação, a investigação começa depois do prejuízo, e com uma meta medida ela começa quando a margem ainda existe.
Como implementar observabilidade de software em sistemas críticos
Implementar bem pede escolhas sobre plataforma, amostragem e padronização, e uma equipe que saiba operar o resultado. Em sistemas críticos, cada escolha errada custa em tempo de investigação durante um incidente real.
Causa raiz, análise em nível de código e correlação com a publicação
Na plataforma Dynatrace, o OneAgent realiza a descoberta automática de processos e tecnologias suportadas em hosts, contêineres e ambientes de nuvem, podendo exigir configurações adicionais conforme a arquitetura, e ativa a instrumentação da pilha encontrada.
O app Distributed Tracing ingere dados de trace do OneAgent e do OpenTelemetry e os analisa sobre o Grail, o motor de armazenamento e consulta da plataforma. É possível fatiar os traces por qualquer atributo e de qualquer origem, ver exceções com stack traces e causas raiz encadeadas, e examinar os traces junto de logs, eventos de negócio e métricas.
O Smartscape apresenta uma visualização dinâmica da topologia e das dependências identificadas no ambiente monitorado, auxiliando na compreensão das relações entre os componentes e dos possíveis impactos nos serviços. É a peça que entrega o segundo passo do roteiro.
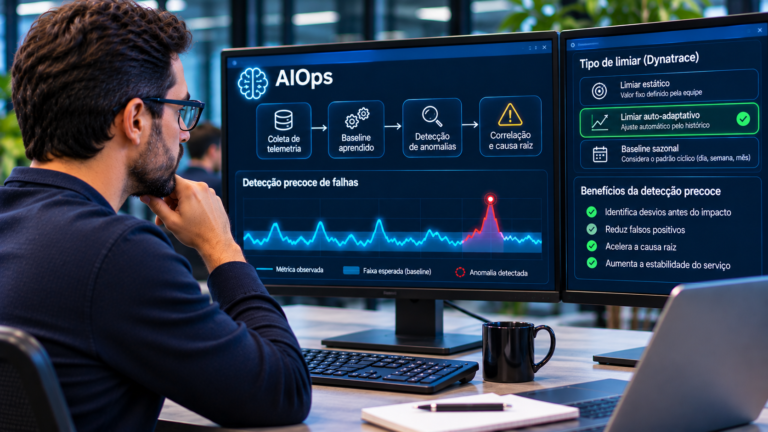
A inteligência da plataforma, chamada Dynatrace Intelligence, adota uma abordagem hipermodal, combinando capacidades de IA preditiva, causal, generativa e agêntica. A IA causal atua na identificação da causa e do contexto do problema, enquanto os dashboards organizam e tornam exploráveis os sinais operacionais.
Segundo a documentação, a análise causal agrupa eventos em problemas e marca a entidade que determinou ser a causa raiz. O problema fica salvo como registro no Grail, e o Dynatrace Query Language, ou DQL, permite perguntas exploratórias sobre ele.
Para o quinto passo do roteiro, a prática que faz diferença é simples e quase sempre esquecida: marcar cada publicação e cada mudança de configuração. Sem essa marcação, a correlação entre a degradação e o deploy depende de alguém lembrar o horário, e com ela a comparação entre o antes e o depois passa a ser uma consulta.
Em ambientes com publicações frequentes, essa marcação é o que transforma “algo mudou hoje” em “esta mudança, neste serviço, nesta chamada”.
Erros comuns e boas práticas de adoção
Sete erros se repetem de projeto em projeto.
- Coletar tudo sem propósito, com o consumo subindo, a consulta ficando lenta e a equipe perdendo confiança nos dados.
- Deixar os atributos sem governança: quando diferentes equipes utilizam nomes ou atributos inconsistentes para identificar o mesmo serviço, o agrupamento e a correlação dos dados podem ficar prejudicados, dificultando as análises nos dashboards da Dynatrace.
- Gerar explosão de cardinality, com identificadores únicos por requisição usados como atributos.
- Configurar a amostragem head-based de modo agressivo, decidindo cedo e sem olhar o trace inteiro, e perder traces de erro e de latência.
- Deixar a propagação de contexto falhar e produzir span órfão, o que exige instrumentação manual nos pontos de entrada e saída de cada sistema.
- Misturar dados de desenvolvimento, homologação e produção na Dynatrace sem a separação adequada dos ambientes monitorados, comprometendo a confiabilidade das informações utilizadas em auditorias.
- Subestimar a curva de aprendizagem da equipe interna.
Sobre a amostragem, a escolha é de governança do projeto. No tail-based sampling, a decisão sobre o que preservar ocorre após informações adicionais da transação estarem disponíveis, permitindo aplicar políticas com base no resultado observado. No head-based, a decisão ocorre o mais cedo possível, com custo de operação menor.
O consumo da plataforma segue as condições do modelo de licenciamento contratado. No Dynatrace Platform Subscription, ou DPS, ele é contabilizado conforme as capacidades utilizadas. No Classic, o acompanhamento segue regras próprias, baseadas em unidades como HU, DEM, DDU e AppSec.
Cinco boas práticas seguem a mesma linha dos erros.
- Começar pelos serviços e pelos fluxos de negócio mais críticos, com implantação em ondas.
- Combinar instrumentação automática e baseada em código nos pontos de negócio.
- Garantir a propagação de contexto entre serviços e nos pontos de contato entre sistemas.
- Definir indicadores e objetivos de nível de serviço ligados à perspectiva do usuário.
- Padronizar nomes de serviço e atributos desde a primeira onda, e não depois.
A quinta é a que mais custa quando fica para depois, porque renomear atributos exige retrabalho em painéis, alertas e consultas que já estavam em uso.
O que muda em cada setor crítico
No setor financeiro, um fluxo digital fica lento depois de uma publicação. O trace mostra qual serviço e qual chamada degradaram, e essa evidência sustenta a trilha auditável exigida de quem responde ao Banco Central e à LGPD.
Nos órgãos públicos, um portal de tributos sob pico exige achar rápido o serviço que chegou ao limite, porque o custo social e político da indisponibilidade é alto. A heterogeneidade tecnológica ali é regra.
Em cooperativas, o mesmo aplicativo atende várias praças. Painéis regionalizados mostram onde a experiência é pior e levam evidências às reuniões de governança, com a mesma qualidade na capital e na cidade pequena.
Em empresas privadas de grande porte, as publicações são frequentes e a experiência digital é diferencial competitivo. A observabilidade mostra se a mudança degradou essa experiência antes que o cliente perceba.
Perguntas frequentes sobre observabilidade de software
A Dynatrace precisa do OpenTelemetry?
Não necessariamente. O OneAgent realiza a descoberta automática nas tecnologias suportadas, e o OpenTelemetry complementa o monitoramento em cenários específicos, como aplicações serverless, componentes customizados e tecnologias sem instrumentação nativa. A plataforma permite combinar os dois quando o projeto exige maior controle ou integrações específicas, e essa é uma decisão entre abordagens técnicas dentro da mesma plataforma.
Como a experiência do usuário se liga ao back-end?
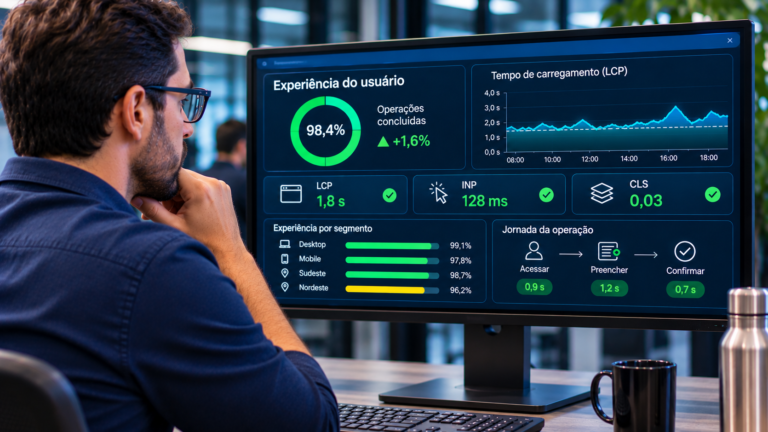
Pelo monitoramento de experiência digital. No front-end, a Dynatrace recomenda o RUM JavaScript, de real user monitoring, para a web, e o OneAgent para o mobile, e ambos se ligam aos traces de back-end pelo W3C Trace Context.
É possível ver dados no nível do código sem um novo deploy?
Sim. O Live Debugger da Dynatrace fornece dados em nível de código em tempo real, sem novos deploys nem reinícios, o que importa justamente nos sistemas em que publicar para investigar não é uma opção.
Observabilidade de software é o mesmo que APM?
Não. Uma plataforma de observabilidade reúne cinco capacidades: APM, ou Application Performance Monitoring, monitoramento de infraestrutura e cloud, DEM, ou Digital Experience Monitoring, AIOps, e compliance e governança de performance. A camada de software é a das aplicações e dos serviços, onde o APM atua, e a plataforma a cobre de traces distribuídos à análise em nível de código.
Quando o head-based sampling ainda faz sentido?
Quando a simplicidade de operação pesa mais do que capturar todos os casos raros. O head-based decide cedo e é eficiente, mas não olha o trace inteiro. O tail-based exige componentes com estado e armazenamento, e por isso a escolha acompanha a criticidade do sistema.
Como mostrar o valor da observabilidade ao conselho?
Pela capacidade de explicar degradações com evidência e de manter o serviço dentro de metas ligadas ao negócio. Segundo o OpenTelemetry, o objetivo de nível de serviço é a forma de comunicar a confiabilidade à organização, ligando os indicadores a valor de negócio.
A Rike IS atua nessas decisões. Padronizar atributos, definir a política de amostragem, marcar publicações para correlação e treinar as equipes por perfil são tarefas de projeto, e a empresa oferece consultoria, implantação, configuração, treinamento, monitoramento e governança contínua de performance sobre a plataforma Dynatrace, além de apoio operacional, investigação de incidentes e apoio à sustentação dos ambientes monitorados, conforme o escopo contratado. O atendimento alcança órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte, e o ponto de partida é a avaliação inicial do ambiente atual, que mapeia a maturidade e desenha o plano de implantação em ondas.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações