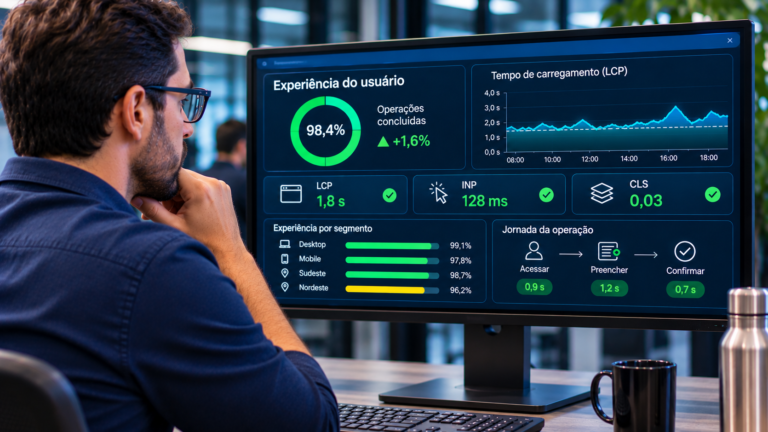


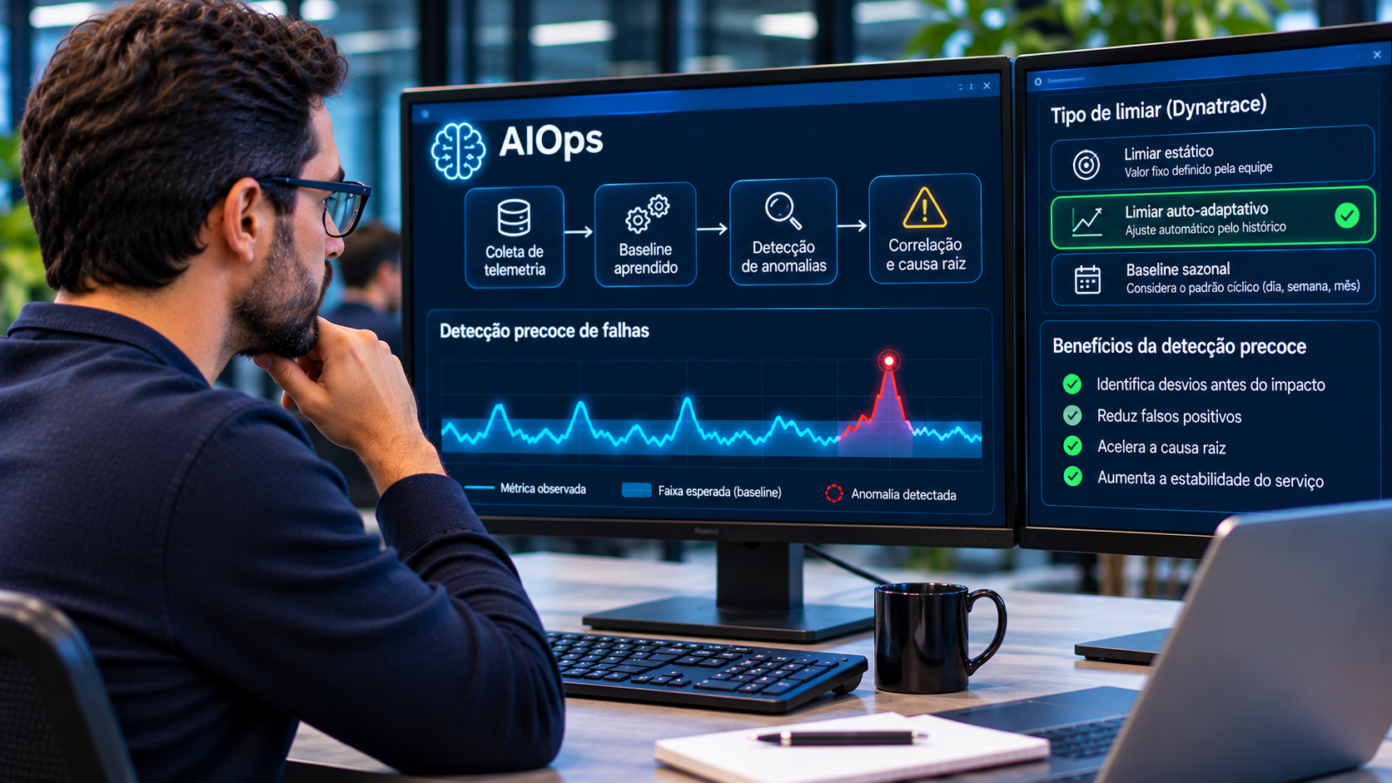
A aplicação de algoritmos de IA na detecção precoce de falhas identifica desvio estatístico sobre o comportamento aprendido de cada componente. O baseline dinâmico complementa o limiar fixo: a Dynatrace permite escolher entre limiar estático, limiar auto-adaptativo e baseline sazonal conforme o comportamento do sinal e o objetivo da detecção. Quatro famílias de técnica cobrem tipos distintos de sinal e a correlação por topologia separa anomalia isolada de incidente real. A maior parte do trabalho de engenharia está em reduzir falso positivo.
O mecanismo central da detecção precoce não é a leitura de um valor absoluto, e sim uma comparação: a plataforma confronta o que o componente está fazendo agora com o que ele costuma fazer naquele mesmo contexto de horário, dia e carga. Detectar cedo é reconhecer o desvio enquanto ele ainda é pequeno demais para disparar qualquer limiar configurado por um humano.
A disciplina que organiza essas técnicas dentro das operações de tecnologia é Artificial Intelligence for IT Operations, ou AIOps. Ela trabalha sobre a telemetria que as demais disciplinas de observabilidade coletam: Application Performance Monitoring, ou APM, que observa a aplicação por dentro, e Digital Experience Monitoring, ou DEM, que mede o que o usuário real percebe na ponta.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
Por que o limiar fixo falha
O alerta por limiar fixo pergunta uma coisa só: o valor passou do número que alguém escreveu? Esse modelo funcionou enquanto a infraestrutura foi estática, com servidor dedicado, carga previsível e capacidade constante. Três características dos ambientes atuais quebram a premissa.
A primeira é a sazonalidade. Uso alto de processador na madrugada, em um serviço que deveria estar ocioso naquele horário, indica algo errado. O mesmo patamar durante o pico de meio-dia é o comportamento esperado. Um número único não consegue estar certo nos dois momentos, e o operador acaba escolhendo entre alertar demais de dia ou não alertar nada de madrugada.
A segunda é a elasticidade da infraestrutura. Quando o ambiente adiciona e remove instâncias sozinho, o denominador da métrica muda ao longo do dia. Consumo agregado de memória cresce porque a aplicação está degradada ou porque o autoescalonamento criou réplicas novas, e o limiar não distingue os dois casos.
A terceira é a cardinality, a quantidade de valores distintos de um atributo. Uma arquitetura distribuída de porte, com um conjunto próprio de métricas relevantes por serviço, produz mais limiares do que qualquer equipe de operações consegue manter, e ninguém revisa esse volume depois de cada implantação.
O resultado prático é um sistema de alerta que envelhece mal. Limiar escrito para uma safra antiga da aplicação, que desde então trocou de arquitetura, dispara por motivo errado ou silencia quando deveria falar.
Para o gerente de infraestrutura, o limiar envelhecido é a origem de um custo invisível: horas de equipe gastas ajustando número em painel, trabalho que não produz estabilidade nem previsão de capacidade. Para o Site Reliability Engineer, ou SRE, o efeito é mais direto, porque o plantão recebe o alerta que envelheceu e precisa decidir, sob pressão, se aquilo é sintoma ou barulho.
Baseline aprendido e limiares adaptativos na detecção de anomalias
Baseline dinâmico é a faixa de comportamento esperado de uma métrica, calculada pela própria plataforma a partir do histórico observado daquele componente, e recalculada conforme o histórico avança. O limiar deixa de ser um número que alguém digitou e passa a ser uma faixa que o sistema aprendeu.
A formação do baseline segue três etapas, e cada uma resolve um problema diferente.
A etapa de aprendizagem observa a métrica por um período suficiente para cobrir os ciclos que ela realmente tem. Um serviço de folha de pagamento tem ciclo mensal, um portal de matrícula tem ciclo semestral, um sistema de pagamento tem ciclo semanal com pico em dia útil. Baseline construído sobre janela curta demais trata o primeiro fechamento de mês como anomalia.
A etapa de decomposição separa a série temporal em componentes distintos. Análise de série temporal, no contexto de monitoramento, é o estudo de uma métrica como sequência ordenada no tempo, em que a ordem dos pontos carrega informação. A decomposição isola a tendência de longo prazo, a sazonalidade repetida e o resíduo, que é a parte não explicada pelos dois primeiros. O sinal que interessa à detecção mora no resíduo.
A etapa de faixa estabelece o intervalo de tolerância em torno do valor previsto para cada instante. Ponto fora da faixa é candidato a anomalia, e a largura da faixa é o botão que controla sensibilidade.
Manter referência por componente individual importa mais do que parece. Dois serviços da mesma aplicação podem ter perfis de latência completamente diferentes, um respondendo em milissegundos e outro em segundos por natureza da operação, e a média entre os dois não descreve nenhum deles. A plataforma Dynatrace mantém referência separada por entidade, apoiada no inventário que o OneAgent monta ao ser instalado, com descoberta automática da stack.
Para o profissional de DevOps, o baseline por componente muda o significado de uma implantação. Cada versão nova passa a ser comparada com o comportamento da versão anterior daquele serviço específico, e a regressão aparece como desvio de faixa enquanto a reversão ainda é barata de executar.
Famílias de algoritmo em detecção de anomalia
Detecção de anomalia é a identificação de observações que se afastam do padrão aprendido de um conjunto de dados. A literatura organiza as técnicas em famílias, e a descrição aqui fica no nível de família, porque afirmar qual variante específica uma plataforma comercial executa internamente exige documentação pública que nem sempre existe.
São quatro famílias em uso corrente na detecção aplicada a operações de tecnologia.
A primeira é a estatística sobre série temporal. Modelos de previsão calculam o valor esperado do próximo ponto a partir da história recente, e o erro de previsão vira o sinal de anomalia. Médias móveis, suavização exponencial e modelos autorregressivos pertencem a essa família. A vantagem é a transparência: a equipe consegue explicar por que aquele ponto foi marcado.
A segunda é a de desvio estatístico sobre distribuição. Em vez de prever o próximo ponto, a técnica descreve a distribuição da métrica em condição normal e mede a distância de cada observação em relação a essa distribuição. Percentis extremos e escores de dispersão entram aqui. Funciona bem em métrica com formato estável e sofre quando a distribuição tem cauda longa, que é o caso comum de latência.
A terceira é a de clusterização e densidade. A técnica agrupa observações semelhantes em regiões densas do espaço de atributos e trata como anômalo o ponto que fica isolado, longe de qualquer grupo. É a família mais útil quando a anomalia é multivariada: nenhuma métrica isolada saiu da faixa, e a combinação entre elas nunca tinha aparecido antes.
A quarta é a de detecção de mudança de regime. O objetivo deixa de ser o ponto isolado e passa a ser o instante em que a série mudou de patamar de forma persistente. Degradação lenta depois de uma implantação é o caso típico: nenhum ponto individual chama atenção, e o nível médio da semana está claramente acima do da semana anterior.
Essas famílias não competem entre si. Uma plataforma madura combina várias, escolhendo por tipo de sinal, porque métrica de infraestrutura, contagem de erro e tempo de resposta de transação têm comportamentos estatísticos distintos.
Para o CIO, o CTO e o CEO, o ponto a reter é de natureza contratual e não matemática. Detecção por algoritmo aprende do próprio ambiente, o que significa que o valor entregue depende da qualidade do dado que a organização coleta, e não apenas da licença que ela assina.
Do desvio isolado ao problema
Anomalia detectada não é incidente, e essa distinção separa uma implantação útil de uma fábrica de alerta.
Em um ambiente distribuído de porte, métricas de vários componentes saem da faixa esperada na mesma janela de segundos durante qualquer evento minimamente relevante. A maior parte dessas anomalias é consequência, não causa: fila que cresce porque o serviço a jusante ficou lento, processador que sobe porque a aplicação está tentando reconectar, erro de tempo limite que se propaga camada acima. Tratar cada anomalia de consequência como incidente autônomo reproduz exatamente o problema que a detecção automática deveria resolver.
A correlação resolve essa multiplicação de sintomas em duas dimensões, e a ordem entre elas importa. A dimensão temporal agrupa anomalias próximas no tempo, e sozinha produz coincidência tanto quanto causalidade. A dimensão topológica usa o mapa de dependências do ambiente para perguntar se existe caminho de propagação entre os componentes afetados.
Sem topologia, a análise consegue no máximo ordenar sintomas por horário. Com topologia, a plataforma percorre o grafo de dependências e encontra o componente cuja anomalia é anterior e explica as demais. O resultado é um problema único com causa raiz nomeada, em vez de uma enxurrada de alertas simultâneos.
Na plataforma Dynatrace, o Smartscape é o mapa de dependências em tempo real, e o Davis é o motor de inteligência artificial causal que se apoia nesse mapa para determinar causa raiz. O trace, que é o GPS de uma viagem mostrando cada parada do trajeto, registra o caminho de propagação requisição por requisição. Dashboards permitem explorar e correlacionar esses dados, enquanto a Dynatrace Intelligence acrescenta detecção de anomalias e análise causal para identificar a origem e o impacto dos problemas.
Para o SRE, a correlação por topologia é o que devolve tempo de plantão. O diagnóstico chega montado, com o componente de origem e o caminho de impacto descritos, em vez de obrigar o plantonista a reconstruir esse caminho sob pressão, com painéis abertos em abas paralelas.
O falso positivo e o custo do ruído
Falso positivo é a anomalia sinalizada pela plataforma que, verificada pela equipe, não corresponde a problema real. Ele é o principal motivo pelo qual projetos de detecção automática perdem credibilidade interna, e tratá-lo abertamente é mais honesto do que prometer precisão que ninguém consegue garantir sem medir no ambiente do cliente.
O custo do falso positivo é acumulativo e tem três camadas.
A camada imediata é o tempo de verificação. Cada alerta investigado consome atenção de quem estava fazendo outra coisa, e a interrupção custa mais do que os minutos gastos lendo o gráfico. A camada seguinte é a dessensibilização: equipe que recebe ruído com frequência aprende a fechar notificação sem ler, e o alerta legítimo morre no mesmo movimento. A camada final é política, porque a plataforma passa a ser descrita internamente como barulhenta, e a conversa sobre expandir a cobertura de instrumentação fica travada por percepção, não por técnica.
Existe uma tensão estrutural que nenhum ajuste elimina. Faixa de tolerância estreita detecta mais cedo e erra mais, e faixa larga erra menos e detecta mais tarde. A engenharia de detecção trabalha nessa troca o tempo todo.
Cinco mecanismos reduzem ruído sem cegar a detecção.
O primeiro é exigir persistência. Ponto isolado fora da faixa vira sinal apenas se o desvio se mantiver por uma janela mínima, o que descarta o pico de um instante causado por coleta ou por rotina pontual.
O segundo é priorizar por impacto observado. Uma anomalia que atinge transação de usuário real tem peso diferente de uma anomalia em métrica interna de componente redundante, e essa priorização é o filtro que mais reduz volume sem perder evento importante.
O terceiro é a agregação por topologia: os sintomas de uma mesma causa viram um problema único, e o volume cai por consolidação, não por supressão.
O quarto é a governança de atributos. Serviço que aparece com três nomes diferentes em contextos diferentes impede a plataforma de reconhecer que os sinais pertencem à mesma entidade. O resultado é fragmentação de alerta que parece ruído algorítmico e é, na verdade, inconsistência de nomenclatura.
O quinto é a realimentação da equipe. Quando o plantão marca um alerta como não acionável, essa informação precisa voltar para a configuração de sensibilidade daquele componente, em vez de se perder no histórico de chamados.
Calibrar sensibilidade em ambiente crítico é trabalho de campo, feito com o conhecimento de quais transações sustentam a operação e quais toleram degradação. A Rike IS conduz essa calibragem com a equipe de operações do cliente, dentro dos ciclos de governança de performance sobre a plataforma Dynatrace.
Os limites do que a detecção por IA enxerga
Uma avaliação técnica honesta precisa nomear o que a abordagem não cobre. São quatro limites que aparecem com regularidade em operação real, e conhecê-los antes evita expectativa mal calibrada.
O primeiro limite é a falha instantânea sem sintoma precedente. Detecção precoce depende de existir degradação anterior ao impacto, ainda que sutil. Um processo que morre por corrupção de memória, um cabo que rompe, um certificado que expira à meia-noite: nenhum desses eventos tem rampa observável. A plataforma registra o fato no mesmo instante em que o usuário o sente.
O segundo limite é o componente não instrumentado. Algoritmo nenhum detecta anomalia em métrica que não existe. Quando a instrumentação não alcança um serviço, a análise causal aponta como origem o ponto mais próximo que consegue observar, e produz um diagnóstico plausível e incompleto, que é a pior combinação possível.
O terceiro limite é o comportamento anormal que virou normal. Baseline aprende do que observa, inclusive do defeito crônico. Uma aplicação que sempre teve latência alta em determinada rotina ensina a plataforma a considerar aquela latência esperada, e a detecção para de sinalizar o desvio. Corrigir isso exige um Service Level Objective, ou SLO, que é meta declarada pela organização em vez de média extraída do histórico.
O quarto limite é a decisão. A plataforma indica desvio, causa provável e impacto, e a escolha entre corrigir agora, mitigar ou conviver depende de janela de manutenção, de contexto de negócio e de apetite a risco. Nenhuma dessas informações está na telemetria.
Predição de falha, no sentido de antecipar um evento futuro, opera dentro desses mesmos limites. O que a análise faz com solidez é projetar tendência mensurável até um ponto de saturação conhecido: disco que enche em ritmo constante, conexões que se aproximam do teto do conjunto, memória que cresce sem liberar. Projeção de tendência sobre grandeza observada é previsão defensável, e não se confunde com promessa de prever qualquer falha, que não se sustenta tecnicamente.
Como avaliar a maturidade da detecção no ambiente atual
A pergunta útil para quem já tem monitoramento instalado não é qual algoritmo usar, e sim o que o ambiente atual oferece para qualquer algoritmo trabalhar. Quatro verificações respondem isso, em ordem.
A primeira verificação é de cobertura. Levantar quais componentes da stack emitem telemetria hoje e quais permanecem invisíveis, separando a cobertura de APM na camada de aplicação, a cobertura de infraestrutura e a cobertura de DEM na ponta do usuário. A lista precisa incluir integrações com terceiros e serviços legados que ninguém quer tocar, porque todo ponto cego é um lugar onde a análise causal vai errar em silêncio.
A segunda verificação é de consistência. Conferir se o mesmo serviço carrega o mesmo nome em todos os contextos, se as unidades de métrica estão declaradas e se as etiquetas obrigatórias existem em toda a stack. Inconsistência de atributo é a causa mais frequente de alerta fragmentado, e o sintoma se confunde com defeito de algoritmo.
A terceira verificação é de histórico. Detecção por baseline precisa de janela que cubra os ciclos reais do negócio, e organização que descarta telemetria em janela curta nunca aprende a sazonalidade mensal do próprio fechamento. O Grail retém logs, métricas, traces e eventos em volume massivo e por longos períodos, com consulta rápida sobre todo o histórico, o que evita a escolha entre guardar dado e conseguir consultá-lo.
A quarta verificação é de destino do alerta. Quantos alertas chegaram ao plantão no último ciclo de operação, quantos exigiram ação e quantos alguém fechou sem investigar? A razão entre alerta recebido e alerta acionável descreve a saúde da operação melhor do que qualquer métrica de plataforma, e o Dynatrace Query Language, ou DQL, é a linguagem que extrai esse número do histórico que a organização já possui.
Ambientes que passam nessas quatro verificações extraem valor de detecção automática logo nos primeiros ciclos de operação. Ambientes que falham em duas ou mais gastam a fase inicial do projeto corrigindo dado, com a percepção interna de que a plataforma não entregou o prometido. A ordem importa: cobertura e consistência de atributos vêm antes de qualquer ajuste de sensibilidade, porque calibrar detecção sobre dado incompleto produz número bonito em painel e diagnóstico errado em plantão.
Perguntas frequentes
O que a detecção faz em um serviço recém-implantado, que ainda não tem histórico?
Serviço novo entra em produção sem passado observado, e a faixa esperada nasce larga por falta de referência própria. Duas saídas funcionam nesse intervalo. A equipe pode comparar o serviço novo com o comportamento de um par estrutural, outro serviço da mesma aplicação que executa operação de natureza semelhante, e usar essa referência emprestada até o histórico próprio existir. A segunda saída é tratar o primeiro período como observação declarada, com os sinais visíveis em painel e sem roteamento para o plantão, o que evita queimar credibilidade da plataforma logo na estreia.
Detecção por desvio funciona em serviço de baixo volume?
Serviço de baixo volume é o caso mais frágil para qualquer técnica estatística, porque uma única requisição lenta desloca a distribuição inteira da janela. Duas correções tornam o cenário tratável. A primeira é alongar a janela de agregação, trocando resolução fina por estabilidade estatística, já que rota pouco acionada não precisa de detecção em granularidade de segundos. A segunda é abandonar o desvio como sinal principal e adotar verificação ativa, que é a execução periódica de uma chamada controlada contra o serviço, medindo se ele responde e responde correto, independente de existir tráfego real naquele momento.
A detecção deve ser suprimida durante janela de manutenção programada?
Supressão total durante manutenção programada resolve o ruído e cria um ponto cego no exato momento de maior risco de mudança. A prática defensável é declarar a janela como contexto conhecido, manter a detecção ativa e redirecionar o destino do sinal. Quem recebe a anomalia durante a janela é a equipe que executa a mudança, não o plantão de sobreaviso. Assim o comportamento anormal provocado pela própria manutenção aparece para quem tem o contexto para julgá-lo, enquanto o alerta segue silencioso para quem não tem.
Detecção de anomalia substitui teste de carga antes da implantação?
Detecção de anomalia e teste de carga respondem a perguntas diferentes e nenhum dos dois cobre a lacuna do outro. Teste de carga formula uma hipótese em ambiente controlado, antes de expor usuário, e descobre onde está o limite do sistema. Detecção por desvio observa o comportamento em produção e descobre o instante em que o sistema começou a se afastar do que ele mesmo costuma fazer. Ambiente que troca o teste de carga pela detecção descobre o limite pela indisponibilidade, que é a forma mais cara de aprender o mesmo dado.
Anomalia detectada e violação de objetivo de nível de serviço são a mesma coisa?
Anomalia é desvio em relação ao comportamento aprendido, e violação de objetivo de nível de serviço é descumprimento de uma meta que a organização declarou. Os dois sinais divergem nos dois sentidos. Um sistema pode apresentar anomalia clara sem violar meta alguma, quando o desvio acontece dentro da folga contratada, e pode violar a meta sem gerar anomalia, quando a degradação já entrou no histórico como normal. A anomalia dispara investigação técnica, e a violação de meta dispara decisão de prioridade com quem responde pelo serviço.
Detecção precoce por algoritmo depende de instrumentação consistente, governança de atributos, calibragem de sensibilidade e revisão contínua com quem atende o plantão. Nenhuma dessas quatro condições vem pronta na instalação, e cada uma exige decisão de engenharia tomada dentro do ambiente do cliente. A Rike IS assume esse percurso inteiro sobre a plataforma Dynatrace, do diagnóstico inicial em sistemas críticos à governança de performance continuada, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o inventário de alertas do seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações