

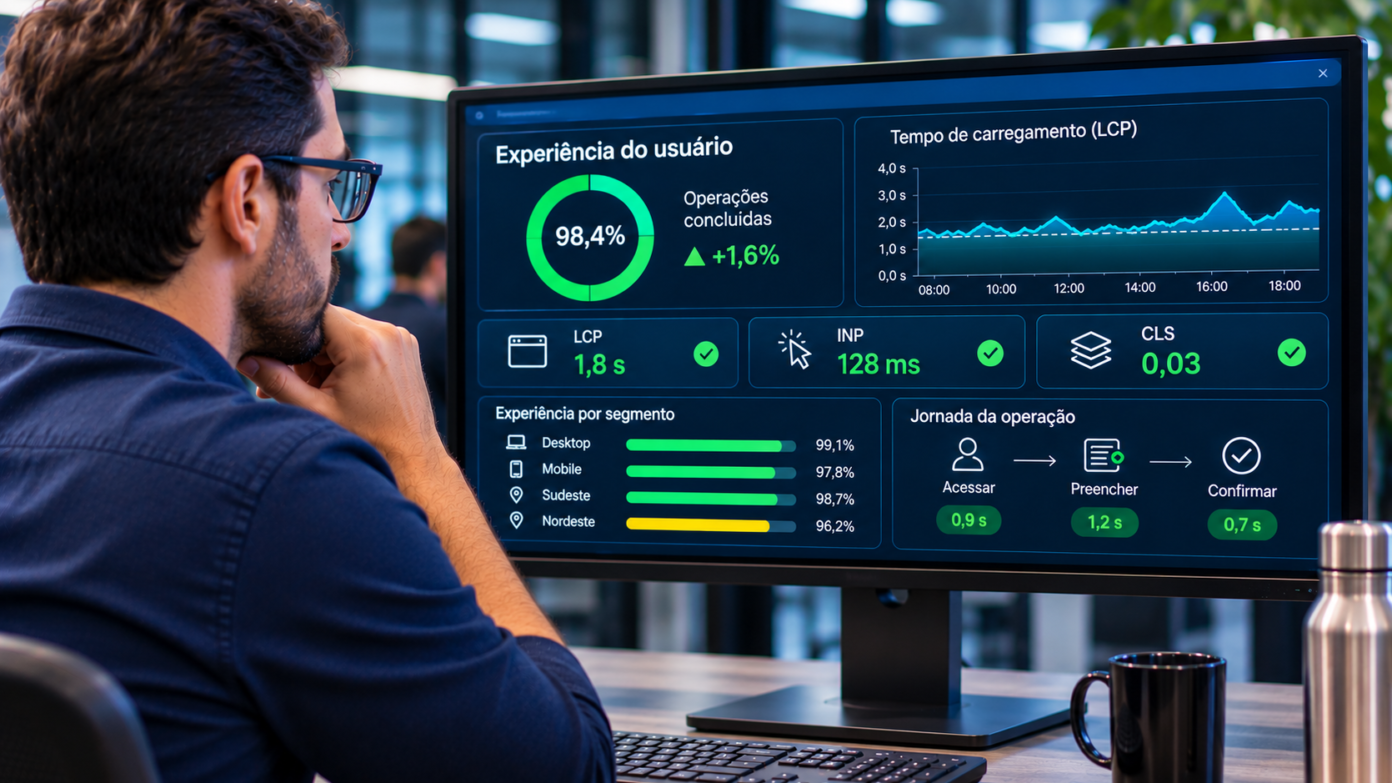
Monitoramento da experiência do usuário mede o sistema pelo lado de quem usa: tempo até o conteúdo aparecer, resposta à interação, taxa de erro no navegador e conclusão de fluxo crítico. Cada métrica precisa de dono, faixa acordada e segmentação por região, dispositivo e versão, e o painel se organiza em três camadas: topo, segmentação e investigação.
Um painel de experiência bem montado responde a uma pergunta prática: o que a aplicação entregou hoje para a população que a usou. Um painel mal montado responde a uma pergunta abstrata, acumula indicador que ninguém consulta e envelhece dentro de um trimestre. A diferença entre os dois está na escolha das métricas, não na quantidade delas.
Monitoramento da experiência do usuário é a medição do comportamento de um sistema a partir de quem está do outro lado da tela, no aparelho e na rede de quem acessa. O ponto de coleta muda de lugar: em vez de registrar como o servidor respondeu, o monitoramento registra quanto tempo a pessoa esperou, o que falhou no aparelho dela e se a operação chegou ao fim.
Essa mudança produz números diferentes dos de infraestrutura, e os dois conjuntos podem discordar no mesmo horário, sobre a mesma janela de observação, sem que nenhum deles esteja errado.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte que operam sistemas críticos.
O que faz uma métrica de experiência valer
Existe um critério anterior a qualquer lista de métricas, e ele economiza meses de retrabalho: a métrica muda uma decisão? Se a resposta for não, o indicador ocupa espaço, consome ingestão de dados e treina a equipe a ignorar a tela.
Métrica que muda decisão tem três propriedades observáveis.
A primeira é ter um dono. Alguém precisa ser a pessoa que age quando o número sai da faixa aceitável, e esse nome existe antes do incidente, não durante. Indicador sem dono vira assunto de reunião, não de correção.
A segunda é ter segmentação. Um número único para toda a base esconde justamente o grupo que está sofrendo, porque a maior parte da população costuma estar bem. Sem corte por região, por dispositivo e por versão da aplicação, a métrica informa que existe um problema e não informa onde.
A terceira é ter uma faixa aceitável acordada. Sem limite combinado, a leitura do número vira negociação sob pressão, e a gravidade do incidente passa a depender de quem está na sala.
Para o CIO, o CTO e o CEO, métrica com dono e faixa acordada transforma discussão de percepção em discussão de risco mensurável. Para o gerente de infraestrutura, a segmentação evita expandir capacidade central quando o problema estava em uma região específica.
Para o profissional de DevOps, a mesma métrica segmentada por versão mostra em minutos se a entrega de ontem piorou a experiência, e sustenta a decisão de reverter. O Site Reliability Engineer, ou SRE, usa a faixa acordada como divisor entre alerta acionável e ruído de plantão, e é sobre ela que se calcula o orçamento de erro do serviço.
Métricas de velocidade percebida
Velocidade percebida é o tempo que a pessoa espera até conseguir fazer o que veio fazer no sistema, e não o tempo de resposta que o servidor registra do lado dele. Um serviço pode responder em poucos milissegundos e ainda assim levar vários segundos até se tornar utilizável, porque o tempo se acumulou depois da resposta: no download dos recursos, no processamento do código de interface, na montagem da tela.
Três tempos merecem estar em qualquer painel de experiência.
O primeiro é o tempo até o conteúdo principal aparecer. O marco correto é o elemento pelo qual a pessoa entrou: o saldo, o formulário, a lista de resultados. O primeiro pixel desenhado na tela não serve como referência, porque cabeçalho e plano de fundo aparecem antes do que interessa. Esse tempo determina se o usuário entende que a página está funcionando.
O segundo é o tempo de resposta à interação. Depois que a tela apareceu, quanto demora entre o toque e a reação visível do sistema? Interface que aparece rápido e trava no primeiro clique produz mais abandono que interface lenta e responsiva.
O terceiro é o tempo até a conclusão da operação inteira, somando todas as telas do percurso. Cada etapa pode estar dentro do limite enquanto a soma delas ultrapassa a paciência de quem está pagando um boleto ou emitindo uma certidão.
Os navegadores padronizaram os nomes desses três tempos no conjunto que se convencionou chamar de indicadores centrais de web. Largest Contentful Paint, ou LCP, mede o tempo até o conteúdo principal aparecer. Interaction to Next Paint, ou INP, mede a resposta à interação. Cumulative Layout Shift, ou CLS, mede a estabilidade visual da tela. Cada um tem faixa de referência própria e forma de coleta própria, que merecem tratamento separado deste conjunto.
Uma decisão de leitura altera o significado de qualquer um desses tempos: média ou percentil. A média dilui o caso extremo, e se a maior parte das sessões carrega rápido, o subconjunto lento some do indicador, com o painel exibindo saúde que o atendimento contradiz todos os dias. O percentil preserva essa informação, porque olha o tempo enfrentado pela fatia em pior situação, que é exatamente a fatia que abre chamado e desiste da operação.
Para a diretoria, a diferença entre média e percentil é contratual. Um compromisso de tempo de resposta definido sobre média pode ser cumprido no papel enquanto parte relevante dos usuários enfrenta tempo inaceitável.
Métricas de erro na ponta
Taxa de erro na ponta é a proporção de sessões em que alguma coisa falhou do lado do usuário, e boa parte desses erros nunca aparece no registro do servidor. O motivo é direto: quando o código que roda no navegador quebra antes de enviar a requisição, o servidor não tem o que registrar, porque nada chegou até ele.
A disciplina que mede o desempenho pelo lado do servidor tem nome próprio, Application Performance Monitoring, ou APM, e cobre o que acontece dentro da aplicação e das suas dependências. A medição na ponta não substitui o APM nem concorre com ele: os dois conjuntos respondem a perguntas diferentes e se completam quando a investigação precisa atravessar do navegador até o banco de dados.
Três tipos de erro merecem métrica própria, e confundir os três atrasa a investigação.
O primeiro é a exceção de front-end. Um erro no código de interface interrompe o preenchimento de um formulário, congela um botão ou impede a validação de um campo. Do ponto de vista da infraestrutura, nada aconteceu naquele minuto.
O segundo é a requisição que sai do dispositivo e não completa: tempo limite esgotado, resposta com código de erro, falha de rede no meio do envio. Aqui existe rastro nos dois lados, e a métrica útil é a taxa de falha por operação de negócio, não a taxa global de requisições.
O terceiro é a falha silenciosa de fluxo: nenhuma exceção, nenhum código de erro, e mesmo assim a pessoa não conclui. Campo obrigatório que não aceita o formato correto, botão que não responde no dispositivo antigo, etapa que devolve o usuário ao início. É o tipo mais caro e o mais difícil de detectar, porque só aparece quando a métrica de erro conversa com a métrica de conclusão de fluxo.
Cada um deles precisa da mesma segmentação usada nos tempos. Taxa de erro por versão da aplicação mostra a entrega que introduziu o defeito. O corte por dispositivo revela o aparelho ou o navegador em que o código não roda como esperado. Taxa de erro por região aponta problema de rota, de provedor ou de conteúdo distribuído.
Para o SRE, esse recorte encurta o tempo médio de resolução porque elimina hipóteses antes da primeira consulta ao código. Para o profissional de DevOps, a taxa de erro por versão é o sinal que autoriza reverter uma entrega sem esperar o chamado do atendimento.
Métricas de alcance: região, dispositivo e rede
A mesma aplicação, servida da mesma origem, entrega experiências diferentes conforme o lugar, o aparelho e a rede de quem acessa. Ignorar essa variação produz painel confortável e operação cega.
Região geográfica é o primeiro corte. A pergunta de governança não é se o sistema está no ar. Para uma cooperativa com agências espalhadas ou um órgão público de alcance nacional, a questão é se o sistema está igualmente utilizável em todas as praças atendidas. Comparar o tempo do percentil por estado transforma essa pergunta em tabela, e tabela é o insumo que sustenta uma reunião de conselho sem depender de percepção pessoal.
Dispositivo é o segundo corte. Aparelho de baixo poder de processamento leva mais tempo para executar o mesmo código de interface, e telas menores mudam a ordem em que os elementos carregam. Uma aplicação aprovada em teste de laboratório com equipamento novo pode ser inviável no aparelho mais comum da base real de usuários.
Rede é o terceiro corte, e o mais esquecido. Conexão móvel instável, rede corporativa com proxy, faixa de horário com saturação: cada condição muda o tempo de download dos recursos sem alterar nada dentro da aplicação.
Existem duas formas complementares de coletar esses três cortes. O monitoramento de usuário real observa sessões efetivas e entrega fidelidade alta, com a limitação de só enxergar o que alguém percorreu. O monitoramento sintético executa um roteiro predefinido de vários pontos geográficos em intervalos regulares, e cobre o fluxo crítico mesmo em horário sem tráfego. O sintético dá a linha de base e o alarme, e o usuário real explica o que a população enfrentou.
O corte por dispositivo carrega uma armadilha que só aparece depois da primeira fatura de ingestão. O modelo do aparelho é um atributo de cardinality alta, e capturá-lo sem agrupamento multiplica o volume armazenado sem melhorar a leitura do painel. O arranjo que se sustenta ao longo dos anos agrupa os aparelhos em poucas faixas de capacidade de processamento e guarda o modelo exato apenas nas sessões que já registraram erro.
No monitoramento sintético a armadilha é outra: roteiro que atravessa autenticação com segundo fator quebra a cada mudança na tela de login, e o alarme falso resultante ensina o plantão a ignorar justamente o alerta que deveria acordar alguém.
Para o gerente de infraestrutura, esses cortes mudam a decisão de investimento. Saber que a degradação é regional e não de capacidade central evita comprar servidor para um problema de distribuição de conteúdo.
Métricas de percurso e de negócio
Métrica de percurso mede o que aconteceu ao longo de uma sequência de etapas, e é a ponte entre o painel técnico e o resultado que a organização entrega. Tempo e erro descrevem o comportamento do sistema, e conclusão de fluxo descreve o que a pessoa conseguiu realizar.
Quatro métricas de percurso cobrem a maior parte dos casos.
A primeira é a taxa de conclusão do fluxo crítico: quantas pessoas que iniciaram a abertura de conta, a emissão da guia ou a contratação do serviço chegaram até o fim, no período observado.
A segunda é a taxa de abandono por etapa, que mostra em qual tela a sequência se rompe. Essa localização transforma uma reclamação genérica de lentidão em um alvo de correção com endereço.
A terceira é o tempo de conclusão do fluxo inteiro, medido por percentil. Fluxo que conclui, mas conclui devagar, migra o custo do sistema para o canal de atendimento, porque a pessoa liga enquanto espera.
A quarta é a taxa de repetição de etapa. Usuário que refaz a mesma tela três vezes está enfrentando um problema que nenhuma métrica de erro registrou, porque nada falhou tecnicamente.
A ligação dessas quatro com conversão é direta e não exige modelo estatístico. Queda na taxa de conclusão de um fluxo de compra, sem queda proporcional no volume de entrada, é receita perdida dentro do próprio sistema. Aumento de abandono na etapa de pagamento em um dispositivo específico é receita perdida com endereço técnico conhecido.
Para o CIO, o CTO e o CEO, esse é o conjunto que traduz observabilidade em linguagem de resultado. Taxa de conclusão, abandono por etapa e consistência regional são indicadores que o conselho compreende sem precisar de glossário técnico.
Montar esse conjunto exige decidir quais fluxos merecem instrumentação, qual granularidade de dados sustenta a análise e como manter a governança de atributos ao longo do tempo. Essas três decisões vêm antes de qualquer instalação de agente, e desfazê-las depois custa reprocessamento e retrabalho de painel. A Rike IS leva esse desenho à mesa com as equipes de operações e de negócio antes da primeira coleta.
Quantas métricas bastam num painel
Um painel de experiência não precisa de dezenas de indicadores. Precisa de poucos que respondam a perguntas operacionais reais, e de profundidade suficiente para investigar cada um deles quando o número sair da faixa. A regra prática que funciona em ambiente crítico divide o painel em três camadas.
A camada de topo tem entre quatro e seis números, no máximo. Tempo do percentil no fluxo principal, taxa de erro na ponta, taxa de conclusão do fluxo crítico e disponibilidade percebida pelo monitoramento sintético dão conta da leitura diária. Cada um desses números tem dono, faixa acordada e alerta configurado.
A camada intermediária é a segmentação dos mesmos números, e não um conjunto novo de indicadores: região, dispositivo, versão da aplicação e condição de rede. Quem olha essa camada já sabe o que procurar, porque a camada de topo apontou o problema.
A camada de detalhe não é painel, é investigação sob demanda. Trace da requisição, registro do componente, sessão individual reproduzida. Ela existe para responder por que, depois que as duas camadas anteriores responderam o que e onde.
Coletar com propósito também é decisão de custo. Cada atributo capturado sem pergunta associada gera volume de dados que a organização paga para armazenar e nunca consulta, e essa conta cresce silenciosamente ao longo dos trimestres. Governança de atributos definida no início evita a limpeza cara dois anos depois.
Na plataforma Dynatrace, esse desenho em camadas se apoia em recursos que conversam entre si. O OneAgent, agente unificado, descobre os componentes da stack e instrumenta sem configuração manual por serviço. O Grail retém o volume em formato consultável, com períodos de retenção que variam conforme o tipo de dado e a configuração adotada, e com consulta rápida sobre todo o histórico, e o Dynatrace Query Language, ou DQL, é a linguagem que permite responder perguntas que o painel padrão não previa.
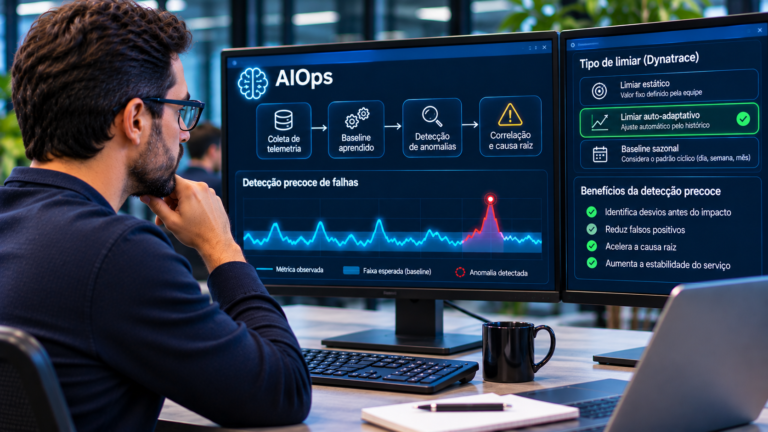
O Davis, que dentro do Dynatrace Intelligence é responsável pela análise causal, liga os sinais da ponta à causa raiz sem intervenção manual, e é isso que a disciplina de Artificial Intelligence for IT Operations, ou AIOps, acrescenta à leitura do painel de experiência. A IA causal atua na identificação da causa e do contexto do problema, enquanto os dashboards organizam e tornam exploráveis os sinais operacionais.
Perguntas frequentes
Quem decide a faixa aceitável quando negócio e tecnologia discordam?
A área que responde pelo resultado do fluxo decide o número, e a área técnica decide se ele é alcançável na arquitetura atual. Quando as duas não convergem, o registro da divergência vale mais que o acordo forçado: anota-se o limite pedido, o limite entregue hoje e o investimento que separa os dois. Faixa definida sem esse registro volta como discussão a cada incidente.
Métrica de experiência do usuário substitui pesquisa de satisfação?
Não substitui, porque as duas medem coisas diferentes. A telemetria registra o que aconteceu no aparelho da pessoa, com precisão de milissegundo e sem depender da memória dela. A pesquisa captura expectativa, frustração acumulada e motivo de desistência, que nenhum sensor lê. Operações que cruzam as duas fontes descobrem casos em que o número técnico estava dentro da faixa e a percepção continuava ruim, quase sempre por problema de fluxo e não de velocidade.
Vale a pena medir experiência em sistema interno, usado só por funcionários?
Vale, e o retorno costuma ser mais direto que no sistema público, porque a população é conhecida e o custo do tempo perdido é folha de pagamento. Sistema interno lento não gera abandono visível: gera fila no atendimento, retrabalho e horas extras. A diferença de método é que a segmentação por região perde peso e a segmentação por parque de equipamentos e por rede corporativa ganha.
Quanto tempo de histórico dessas métricas precisa ficar guardado?
O horizonte útil vem da pergunta que a organização faz. Comparar o comportamento de hoje com a semana anterior exige poucas semanas de dado bruto. Demonstrar tendência de degradação ao longo do ano exige retenção longa, mas só do dado agregado por período e por segmento. Guardar sessão individual por muitos meses é o erro de custo mais comum, porque o volume cresce sem que ninguém consulte a sessão antiga.
Métricas de experiência funcionam em aplicativo móvel nativo ou só na web?
Funcionam nos dois, com pontos de coleta distintos. No aplicativo nativo não existem os indicadores centrais de web. O equivalente ali é o tempo até a tela ficar utilizável, a taxa de travamento por sessão e a conclusão do fluxo dentro do aplicativo. A segmentação por versão fica mais importante que na web, porque a atualização depende da loja e do usuário, e versões antigas convivem na base por meses.
Escolher o que medir na ponta do usuário, definir faixas defensáveis, segmentar por região e por dispositivo e sustentar esse conjunto sob governança ao longo dos anos é trabalho de especialista, não de configuração inicial. Do desenho do painel à governança de atributos que o mantém útil, a Rike IS presta esse serviço sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o painel de experiência que você tem hoje para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações