

Real User Monitoring mede a experiência de pessoas reais a partir do navegador, em sessões, ações e erros, e os Core Web Vitals dão a régua pública com LCP, INP e CLS. A coleta se habilita de quatro formas, depende de cabeçalhos, cookies e cache, e se liga a traces distribuídos. Sintético e governança de privacidade completam o uso.
O servidor responde dentro do esperado e, ainda assim, usuários reclamam de lentidão no portal. As duas coisas podem ser verdade ao mesmo tempo, porque o que o servidor entrega e o que a pessoa vê no navegador são medidas diferentes.
O Real User Monitoring, ou RUM, fecha essa lacuna. Ele mede a experiência a partir do navegador de quem usa a aplicação, e não a partir do servidor que a entrega, e é no uso real que lentidão e indisponibilidade viram reputação, receita e, no setor público, custo político.
Cada perfil lê esse dado por um ângulo. Para o CIO, o CTO e o CEO, o RUM mostra o que o usuário de fato viu, onde a experiência se degrada e para quem. Para o profissional DevOps, é a validação de cada versão publicada na ponta. Para o Site Reliability Engineer, ou SRE, é a fonte de um indicador de experiência que o servidor, sozinho, não entrega. Para o gerente de infraestrutura, mostra se o dimensionamento sustenta o pico onde ele é sentido.
O que é Real User Monitoring e o que ele captura
O Real User Monitoring é a técnica que mede a experiência de pessoas reais ao usar uma aplicação web ou móvel, com dados capturados diretamente do navegador ou do aplicativo durante as sessões.
Na plataforma Dynatrace, ele integra a capacidade de Digital Experience Monitoring, ou DEM. A documentação considera aplicações web todas as páginas HTML, sejam estáticas ou aplicações de página única executadas em um navegador.
Sessões, ações do usuário e Core Web Vitals
A unidade de medida do RUM é a sessão de usuário, e dentro dela ficam as ações do usuário. Segundo a documentação do Real User Monitoring Classic da Dynatrace, a captura inclui ações geradas automaticamente e nomeadas por configuração, ações XHR, outros tipos de interação e as ações-chave, avaliadas com o Application Performance Index, ou Apdex, o índice de satisfação que o RUM alimenta.
A documentação lista ainda propriedades de sessão, que permitem segmentar o uso por características de quem acessa.
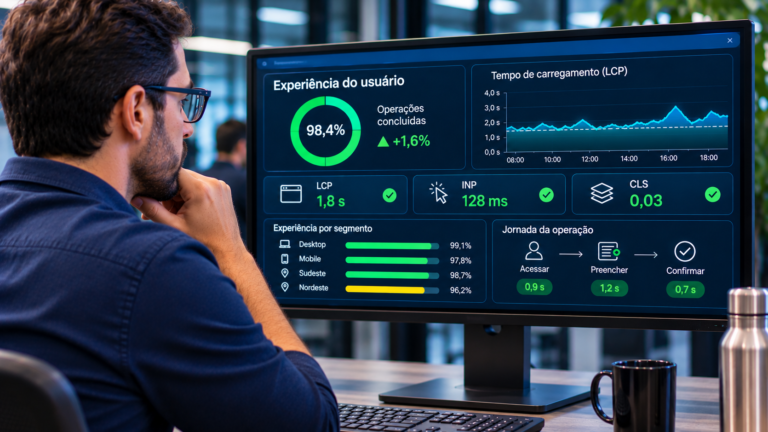
Fora de qualquer ferramenta, o padrão de mercado para medir experiência web são os Core Web Vitals, definidos na documentação pública do próprio padrão.
| Métrica | O que mede | Limite considerado bom |
|---|---|---|
| Largest Contentful Paint, ou LCP | Carregamento | 2,5 segundos |
| Interaction to Next Paint, ou INP | Interatividade | 200 milissegundos |
| Cumulative Layout Shift, ou CLS | Estabilidade visual | 0,1 |
A avaliação usa o percentil 75 das visitas, isto é, pelo menos três em cada quatro visitas precisam ficar dentro do limite, e vale separadamente para celular e desktop. Esses nomes vêm do padrão público dos Core Web Vitals, e a coleta de cada métrica na ferramenta em uso deve ser conferida na documentação dela.
Dados de campo versus dados de laboratório
Dados de campo refletem a experiência de usuários reais, e dados de laboratório vêm de ambientes controlados. O RUM produz dados de campo, e a recomendação da documentação dos Core Web Vitals é medir em campo, porque é ali que aparece a variedade de dispositivos, redes e condições de uso que um teste controlado não reproduz.
Em órgãos públicos, o período de pico é quando essa diferença pesa. O RUM mostra se usuários de regiões ou dispositivos distintos enfrentam degradação, e o registro serve de evidência para a transparência que o setor exige.
Como o RUM funciona na prática
O RUM funciona com um código que roda no navegador do usuário e reporta o que acontece durante a sessão. A documentação da Dynatrace descreve quatro formas de habilitar essa coleta, cada uma com requisitos próprios.
Formas de habilitar a coleta: injeção, sem agente, snippet e OneAgent
As quatro formas documentadas para aplicações web são estas.
- Injeção automática do JavaScript de RUM nas páginas.
- Monitoramento sem agente.
- Snippet manual, em formatos selecionáveis.
- OneAgent em modo full-stack, com implantação seletiva de RUM nos hosts.
A escolha entre elas é decisão de implantação, e cada uma carrega requisitos próprios. O OneAgent, agente unificado que descobre automaticamente a stack de um host, contêiner ou ambiente cloud, une a coleta no navegador à observabilidade do servidor, o que importa quando a investigação precisa atravessar as duas pontas.
Requisitos e limitações: cabeçalhos, cookies, cache e XHR de origem cruzada
Segundo a documentação, a infraestrutura precisa repassar as requisições, os cabeçalhos e os cookies específicos para o RUM funcionar como esperado, e os servidores de cache precisam estar bem configurados. Se algum desses elementos não chega, a coleta fica comprometida.
As ações XHR de origem cruzada exigem configuração extra para se ligar a traces distribuídos.
Cada requisito vira uma pergunta de implantação, com responsável definido: quem confere o repasse dos cabeçalhos, quem revisa a configuração de cache e quem valida o vínculo das chamadas de origem cruzada, antes de o dado ser tratado como confiável.
Do front-end à causa raiz: ligando o RUM aos traces
Quando a ação do usuário é associada a um trace distribuído, o RUM deixa de apontar apenas o sintoma e aponta o caminho. O trace é o GPS de uma viagem, mostrando cada parada do trajeto. Sem esse vínculo, a lentidão vista pelo usuário fica sem explicação, porque pode estar na página, na rede ou em um serviço do back-end.
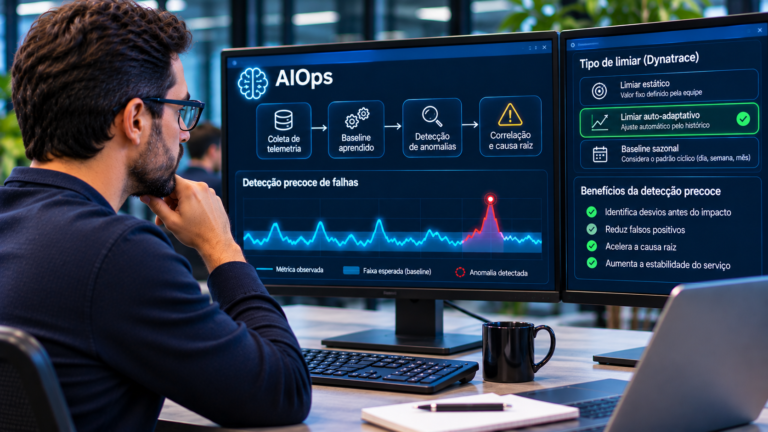
Na plataforma Dynatrace, o Dynatrace Intelligence é responsável pela análise causal, com base no mapa de dependências do ambiente, e aponta a causa raiz, o impacto no negócio e as transações afetadas. Para o SRE, isso encurta o caminho entre a reclamação do usuário e o serviço responsável.
A IA causal atua na identificação da causa e do contexto do problema, enquanto os dashboards organizam e tornam exploráveis os sinais operacionais. No RUM, essa divisão é visível: a sessão mostra o que a pessoa viveu, e a análise causal explica por quê.
Como usar o RUM e evitar os erros comuns
Coletar dados de usuários reais é a parte simples. O valor aparece quando a equipe escolhe o que medir, segmenta com critério e governa o que coleta.
RUM e monitoramento sintético: papéis complementares
O monitoramento sintético simula acessos programados para verificar a disponibilidade, inclusive quando não há tráfego, e o RUM mostra o que usuários reais viveram. Um não substitui o outro: o sintético avisa que o serviço caiu de madrugada, e o RUM mede o impacto sobre quem estava usando.
Privacidade, governança de atributos e segmentação
Segmentar por dispositivo, região e versão transforma o dado em decisão, e o eixo da segmentação muda conforme o setor.
Em instituições financeiras, o RUM mostra em qual etapa do fluxo de uma transação o usuário desiste e quanto tempo cada etapa leva.
Em cooperativas, comparar a experiência entre praças e dispositivos, com dashboards regionalizados, revela se a qualidade é a mesma na capital e na cidade pequena.
Em empresas privadas de grande porte, a comparação antes e depois de uma versão nova mostra se a mudança degradou a experiência de quem compra ou contrata.
As propriedades de sessão e de usuário podem envolver dados pessoais, e a Lei Geral de Proteção de Dados, ou LGPD, como regime geral, pede governança sobre o que se coleta. Os controles específicos da plataforma devem ser verificados na documentação antes de qualquer configuração.
Os erros de adoção mais frequentes se repetem de projeto para projeto.
- Medir apenas o servidor e supor que o usuário está bem.
- Habilitar o RUM sem verificar cabeçalhos, cookies e cache.
- Deixar as ações XHR de origem cruzada sem vínculo com os traces, o que perde o elo com o back-end.
- Olhar médias em vez de percentis e ignorar a diferença entre celular e desktop.
- Coletar atributos de sessão sem governança, com nomes inconsistentes entre equipes, e sem considerar a LGPD.
- Subestimar a curva de aprendizagem da equipe interna.
Perguntas frequentes sobre Real User Monitoring
O RUM funciona em navegadores antigos?
Nem todos. A documentação dá um exemplo: o suporte ao Internet Explorer 11 terminou a partir da versão 1.293 do JavaScript de RUM. Antes de prometer cobertura para um público com navegadores antigos, vale conferir na documentação da versão em uso quais navegadores o JavaScript atende.
Como investigar a reclamação de um usuário específico?
A documentação do Real User Monitoring Classic cita a marcação de usuários específicos para análise de sessão. Com a marcação, a equipe liga a reclamação ao que aconteceu naquela sessão, em vez de tentar reproduzir o problema. Como a marcação identifica uma pessoa, vale a governança descrita para a LGPD.
Visually complete e Speed index são Core Web Vitals?
Não. Os Core Web Vitals são LCP, INP e CLS. A documentação do Real User Monitoring Classic lista Visually complete e Speed index entre as métricas capturadas, e a coleta dos três Core Web Vitals pelo nome deve ser verificada na documentação da plataforma antes de usá-los como meta.
Qual a diferença entre ação do usuário e ação XHR?
A ação do usuário é a interação registrada na sessão, gerada automaticamente e nomeada por configuração. A ação XHR vem de XMLHttpRequest, ou XHR, e é a chamada assíncrona que a página faz ao servidor sem recarregar.
Quais fluxos acompanhar primeiro?
Os que sustentam receita e continuidade. Em instituições financeiras, o login e as transações. Em órgãos públicos, os serviços ao cidadão que concentram pico. Em cooperativas, os fluxos usados em todas as praças. Em empresas privadas de grande porte, o caminho que o cliente percorre para comprar ou contratar.
Por quanto tempo guardar dados de sessão?
Não há prazo universal. Em sistemas críticos, a retenção dos dados de sessão deve seguir o regime aplicável ao setor, com a LGPD como regime geral, e a finalidade da coleta. O prazo sai de uma decisão conjunta entre tecnologia, jurídico e negócio, registrada antes de ativar o RUM.
O sampling de traces pode esconder a causa de uma lentidão vista pelo usuário?
Pode. No head-based sampling, a decisão ocorre no início da transação, antes de o trace estar completo, e por isso ele pode descartar os traces de erro e de latência, justamente os que explicam a reclamação. No tail-based sampling, a decisão sobre o que preservar ocorre após informações adicionais da transação estarem disponíveis, permitindo aplicar políticas de amostragem com base no resultado observado.
Definir o que coletar de usuários, como nomear os atributos de sessão, como ligar o RUM ao back-end e como governar os dados pede leitura do ambiente, e não apenas a ativação da coleta. A Rike IS atua como parceira de consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, junto a órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte, começando pela avaliação inicial do ambiente atual.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações