

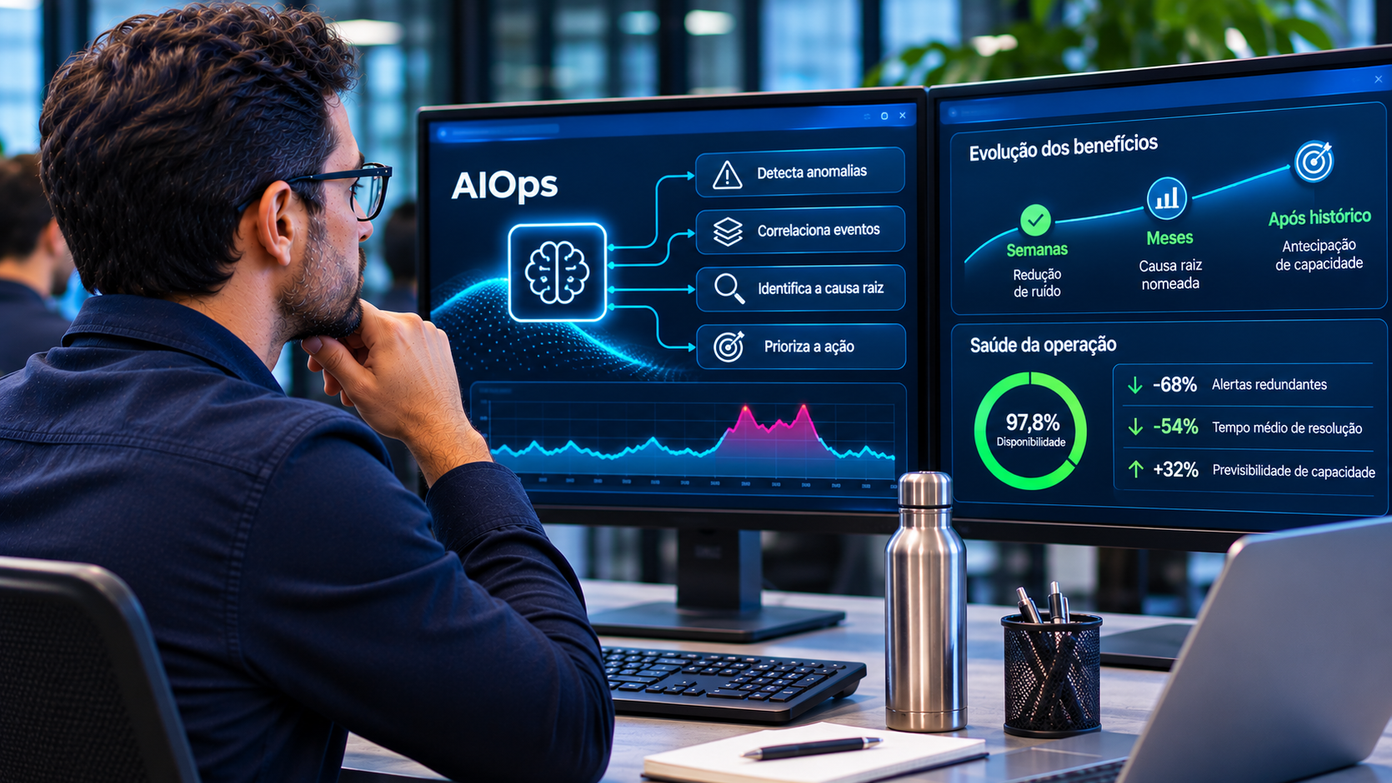
Os benefícios da AIOps chegam em três ondas com prazos distintos: corte de alerta redundante em semanas, causa raiz nomeada em meses e antecipação de capacidade depois de histórico acumulado. Quatro obstáculos previsíveis atrasam essas ondas: coleta sem propósito, ausência de governança de atributos, sampling mal configurado e curva de aprendizagem subestimada.
Benefícios e desafios da AIOps se organizam em uma relação de dependência. Cada ganho só chega depois que a organização cumpre uma condição de preparo específica, e cada obstáculo é o nome dessa condição quando ela fica pendente.
Artificial Intelligence for IT Operations, ou AIOps, é a disciplina que aplica análise causal automatizada sobre a telemetria de produção para determinar causa raiz sem depender de leitura humana de cada alerta. Ela não opera como produto que se liga e passa a diagnosticar sozinho: depende de telemetria consistente, de convenção de nomes acordada antes da instrumentação e de equipe treinada para ler o que a plataforma entrega. Essas três condições pertencem à organização, não à licença contratada.
Quem monta um business case de AIOps precisa dos dois lados da conta. Prometer resultado imediato produz frustração no terceiro mês, e omitir o custo de preparação produz orçamento que estoura.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
Os benefícios da AIOps, em ordem de aparição
Os ganhos chegam em três ondas, e a ordem importa mais do que a lista. Cada onda depende da maturidade construída na anterior, e tentar cobrar a terceira no primeiro mês é o erro de expectativa mais comum em projeto novo.
A primeira onda é a redução de ruído, e ela aparece em semanas. Durante uma falha em cascata, cada camada instrumentada emite seu próprio alerta, e a equipe de operações recebe dezenas de notificações que descrevem sintomas verdadeiros de um mesmo evento. A plataforma agrupa esses sinais e apresenta um problema priorizado no lugar da enxurrada. O ganho é imediato porque não exige mudança de processo, apenas telemetria chegando com consistência.
A segunda onda é a causa raiz nomeada, e costuma amadurecer em meses. A análise causal precisa do mapa de dependências construído em tempo real para afirmar que o evento A provocou o evento B, e precisa também de largura. O motor cruza o sinal do Application Performance Monitoring, ou APM, que observa a aplicação por dentro, com o do Digital Experience Monitoring, ou DEM, que registra o que o usuário sentiu no navegador ou no aplicativo. Enquanto a cobertura de instrumentação tem buracos, a plataforma aponta como origem o ponto mais próximo que consegue observar, e o diagnóstico sai plausível e incompleto.
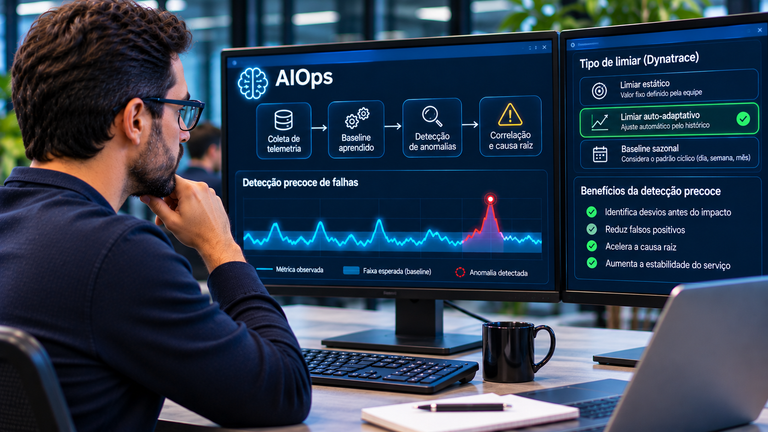
A terceira onda é a antecipação, e é a mais lenta. Detecção de desvio sobre comportamento aprendido permite ver saturação de recurso antes que ela chegue ao usuário, e a análise de tendência revela capacidade ociosa que ninguém tinha coragem de reduzir. Essa onda exige histórico acumulado, porque o motor precisa saber o que é normal em um mês fechado de folha, em uma véspera de feriado e em um pico de campanha.
Para o CIO, o CTO e o CEO, o valor está na substituição de contagem por explicação. Levar ao conselho o número de incidentes descreve o passado, e levar a causa dos incidentes e a ação tomada sobre cada uma sustenta previsão. O retorno do investimento aparece na redução expressiva do tempo médio de resolução e na queda de indisponibilidade em sistemas críticos, dois efeitos que a operação consegue demonstrar com o histórico da própria plataforma.
Para o gerente de infraestrutura, o benefício se traduz em capacidade e custo previstos com antecedência, em vez de compra emergencial depois do incidente. No time de DevOps, cada implantação passa a ter métrica clara de impacto, e a regressão aparece enquanto a reversão ainda é barata. Para o Site Reliability Engineer, ou SRE, o plantão deixa de consumir tempo em triagem, e o orçamento de erro, a margem de indisponibilidade tolerada no período acordado, passa a ser gasto em decisão consciente.
A resposta direta à pergunta do business case: AIOps compensa quando a organização opera sistemas críticos, tem volume de incidentes que já cansa a equipe e possui telemetria em quantidade que nenhum humano consegue ler. Quando o ambiente é pequeno, estável e bem conhecido, o ganho existe mas demora mais a pagar a preparação.
Primeiro obstáculo: coletar tudo sem propósito
A tentação inicial de todo projeto é ligar a coleta no máximo e decidir depois o que fazer com o dado. Log de qualquer evento. Métrica na granularidade mais fina disponível. Trace em volume completo de todas as transações. A justificativa parece prudente: melhor ter e não precisar.
O efeito prático desmente essa prudência. O custo de ingestão sobe em curva que ninguém previu no orçamento, a performance de consulta cai porque cada busca varre volume desnecessário e a equipe começa a evitar a plataforma que deveria usar. Quando a consulta demora, o plantão volta para o terminal e para o log bruto, e o investimento vira prateleira.
A correção é anterior à técnica. Cada métrica, log e trace precisa responder a uma pergunta operacional ou de negócio que alguém saiba formular antes da coleta. Métrica que não responde a pergunta nenhuma é despesa recorrente disfarçada de precaução.
Existe um teste rápido para qualquer fonte de dado candidata: que decisão muda se aquele dado existir, e quem toma essa decisão? Fonte que não passa nesse teste entra em retenção curta ou fica fora.
Para o gerente de infraestrutura, esse obstáculo é o que transforma previsão de custo em surpresa trimestral. Para o CIO, é a diferença entre um contrato que se defende no comitê de orçamento e um contrato que precisa ser explicado.
Segundo obstáculo: ausência de governança de atributos
Governança de atributos é o conjunto de convenções que define como a organização nomeia e etiqueta cada entidade do ambiente na telemetria: nome de serviço, nome de ambiente, identificador de time responsável, unidade de cada métrica e etiquetas obrigatórias por tipo de carga de trabalho.
Parece burocracia de planilha até o primeiro incidente sério.
Sem convenção acordada, o mesmo serviço aparece com um nome em um time, com prefixo técnico em outro e em formato concatenado no time que herdou o código legado. O motor de correlação trata os três como entidades distintas, o dashboard não agrupa e a análise causal perde o caminho de propagação justamente no ponto em que ele atravessa times.
O problema piora com o tempo, porque dado já gravado carrega a inconsistência para o histórico. Corrigir convenção depois que a telemetria está em produção custa mais do que definir antes, e em muitos casos exige reprocessar meses de dado para que a comparação com o passado continue válida.
Adiar governança de atributos para depois que a plataforma estiver funcionando é a decisão que mais compromete projetos de AIOps. A análise causal opera sobre a consistência do dado, e dado inconsistente não se conserta com mais licença.
Para o profissional de DevOps, a convenção precisa entrar na esteira de entrega, com validação automática que rejeita serviço novo sem as etiquetas obrigatórias. Para o SRE, ela é o que permite abrir o mapa de dependências durante o plantão e reconhecer o que está vendo, em vez de decifrar três nomes para a mesma coisa.
Terceiro obstáculo: sampling mal configurado
Sampling, ou amostragem, é a política que decide qual parte da telemetria a coleta preserva e qual ela descarta na origem. Sampling é a pesquisa eleitoral da telemetria, que observa parte para inferir o todo.
Sampling agressivo demais economiza ingestão e descarta justamente os eventos que precisavam de análise, porque erro e latência elevada são raros por definição e a amostragem aleatória os elimina primeiro. O time descobre a perda no pior momento possível: durante a investigação de um incidente que não deixou rastro.
Sampling permissivo demais preserva tudo, eleva o custo sem retorno proporcional e recria o primeiro obstáculo por outro caminho.
Em sistemas críticos, o sampling tail-based é geralmente preferido, porque decide o que preservar depois de conhecer o resultado da transação, mantendo na amostra o que terminou em erro ou em latência alta. A alternativa, decidir no início da requisição, descarta sem saber como aquela transação vai acabar.
A política também precisa ser diferenciada por carga. Transação de receita, fluxo de autenticação e operação sujeita a supervisão regulatória merecem cobertura completa, enquanto rotina interna de baixo risco tolera amostragem reduzida sem prejuízo de diagnóstico.
Montar essa política exige conhecer o comportamento real de cada carga de trabalho, e esse conhecimento raramente está documentado. A Rike IS conduz esse levantamento junto com a equipe de operações do cliente, mapeando quais fluxos exigem cobertura integral antes de qualquer ajuste na coleta.
Quarto obstáculo: curva de aprendizagem subestimada
O quarto obstáculo aparece no calendário da equipe, não no produto contratado.
Organizações que tratam capacitação como etapa posterior à implantação passam a usar uma fração das capacidades que contrataram. O Davis, motor de inteligência artificial causal da plataforma Dynatrace, entrega o problema priorizado, e o plantão continua investigando pelo caminho antigo porque nunca aprendeu a ler o mapa de impacto. O Dynatrace Query Language, ou DQL, permanece inexplorado, e perguntas que se responderiam em minutos voltam a exigir exportação para planilha.
A IA causal atua na identificação da causa e do contexto do problema, enquanto os dashboards organizam e tornam exploráveis os sinais operacionais.
Capacitação precisa correr em paralelo à implantação, não depois dela. Para o business case, o que importa é reservar custo e calendário desde a assinatura, na mesma linha de orçamento em que entra a licença.
Existe um segundo componente da curva que costuma ficar invisível. A equipe precisa desaprender o hábito de confiar no alerta individual, construído em anos de operação baseada em limiar fixo. Confiar em um problema priorizado, com causa nomeada, exige que a plataforma acerte algumas vezes na frente do time antes que a confiança se estabeleça.
Para o CTO, essa curva é um item de plano com custo e prazo, não uma linha genérica de treinamento. Para o gerente de infraestrutura, é o que decide se a equipe atual dá conta do novo ambiente ou se o quadro precisa de reforço temporário durante a transição.
Dimensionar essa curva antes da assinatura evita a frustração que costuma chegar no terceiro mês de projeto. A Rike IS faz esse levantamento junto com a equipe de operações do cliente, separando o que a organização já tem do que precisa construir antes da primeira instrumentação.
O que precisa estar pronto antes de adotar AIOps
Quatro pré-requisitos decidem o resultado, e nenhum deles é uma compra.
O primeiro é inventário do que roda em produção, com dono definido por serviço. Ambiente em que ninguém sabe dizer quem responde por determinado componente produz problema priorizado que fica sem destinatário, e o ganho de tempo se perde no encaminhamento.
O segundo é a convenção de atributos escrita e acordada entre os times antes da instrumentação. Basta um documento curto, com nomes obrigatórios e unidades padronizadas, validado por quem opera cada domínio.
O terceiro é a definição de quais fluxos são críticos para o negócio, em ordem. Essa lista orienta a política de sampling, a prioridade de instrumentação e o que entra primeiro no acompanhamento. Sem ela, a implantação avança pelo que é tecnicamente mais fácil, que raramente coincide com o que mais dói.
O quarto é o compromisso de calendário da equipe que vai operar. Horas de capacitação reservadas na agenda, com nome e data, valem mais do que intenção declarada em reunião de abertura.
Sobre prazo, a resposta honesta vem em faixas. A redução de ruído aparece em semanas depois que a telemetria chega consistente. A causa raiz confiável exige cobertura de instrumentação madura e costuma amadurecer ao longo de alguns meses. A antecipação de capacidade depende de histórico suficiente para o motor conhecer os ciclos do negócio.
A plataforma Dynatrace acelera essas faixas por três caminhos. O OneAgent descobre a stack sozinho, sem configuração manual por componente. O Smartscape monta o mapa de dependências em tempo real, sem depender de desenho manual de topologia. O Grail retém logs, métricas, traces e eventos em volume massivo, com períodos de retenção que variam conforme o tipo de dado e a configuração adotada, com consulta rápida sobre todo o histórico, que é o insumo da previsão de capacidade. A aceleração vale para a coleta, para o mapa e para o histórico, não para a maturidade da equipe, que segue o próprio ritmo.
O que separa um projeto de AIOps que dá certo
Os projetos que entregam o que prometeram compartilham três características, e nenhuma delas tem relação com o tamanho do contrato.
A primeira é método na ordem de execução. Definir convenção de atributos antes de instrumentar, escolher o domínio inicial pela dor e não pela facilidade, calibrar sampling por carga de trabalho e treinar a equipe em paralelo. Inverter essa ordem cria retrabalho que consome o orçamento reservado para a expansão.
A segunda é governança de performance continuada. Ambiente muda, serviço novo entra e arquitetura se reorganiza, e convenção sem manutenção degrada em silêncio. Revisão periódica das etiquetas obrigatórias, do custo de ingestão por fonte e da política de amostragem mantém a análise causal operando sobre dado que continua confiável.
A terceira é experiência de campo. Saber quais fluxos exigem cobertura integral em uma instituição financeira não é conhecimento que se extrai de documentação. Também não se extrai de documentação o que a supervisão regulatória cobra de retenção em um órgão público, nem como uma cooperativa organiza seus picos de atendimento. Vem de ter feito antes, em ambiente com as mesmas restrições, e é esse repertório que evita o piloto que funciona na demonstração e trava na primeira semana de produção real.
Perguntas frequentes
AIOps substitui a equipe de operações?
AIOps não substitui a equipe de operações. A disciplina muda o conteúdo do plantão: quem está de sobreaviso deixa de triar notificação e passa a validar hipótese de causa e a decidir a ação corretiva. O trabalho manual de leitura cai, o nível da decisão sobe e a necessidade de gente que conhece o negócio permanece intacta. Organizações que reduzem o quadro logo depois da implantação ficam sem quem valide o que o motor de análise propõe.
AIOps funciona em ambiente com sistema legado e servidor próprio?
Sim, desde que o sistema legado emita telemetria que a plataforma consiga ler. O que decide é a instrumentação disponível, e não a idade da aplicação ou o fato de ela rodar em servidor próprio. Aplicação que grava apenas log em arquivo local, sem métrica e sem rastro de transação, entra na análise causal como caixa preta e aparece no mapa de dependências pela borda, através dos vizinhos que conversam com ela. Nesse cenário, instrumentar vem primeiro.
Qual a diferença entre AIOps e automação por runbook?
Automação por runbook executa uma sequência que alguém escreveu antes, disparada por uma condição já conhecida. AIOps opera sobre o que ninguém antecipou, encontrando relação entre eventos que nenhum runbook previa. As duas convivem sem conflito: a análise causal nomeia o que aconteceu e o runbook executa a resposta acordada para aquele caso. Confundir as duas produz a expectativa errada, porque runbook não descobre causa e análise causal não aplica correção sozinha.
Quem deve responder pelo projeto de AIOps dentro da organização?
O projeto precisa de um dono com autoridade sobre mais de um time, porque a convenção de atributos só funciona quando vale para todos ao mesmo tempo. Quando o dono é a área de infraestrutura sem mandato sobre desenvolvimento, a convenção vira recomendação e a análise causal passa a operar sobre dado inconsistente. O arranjo que sustenta o projeto tem patrocínio no nível do CIO ou do CTO e um responsável técnico com trânsito entre as áreas.
Como saber se a implantação de AIOps está dando certo?
Três indicadores mostram isso antes de qualquer relatório de fim de ciclo. O primeiro é a proporção de notificações que a equipe fecha sem precisar investigar. O segundo é a frequência com que a causa apontada pela plataforma coincide com a causa confirmada na análise pós-incidente. O terceiro é o volume de consultas que a própria equipe escreve, sem acionar o parceiro. Quando os dois primeiros sobem e o terceiro fica parado, o que falta é capacitação, não plataforma.
Colocar AIOps em operação em sistemas críticos exige diagnóstico do que já existe, convenção acordada entre times, política de coleta dimensionada e capacitação conduzida em paralelo à implantação. A Rike IS oferece consultoria, implantação, treinamento e governança de performance continuada sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o business case do seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações