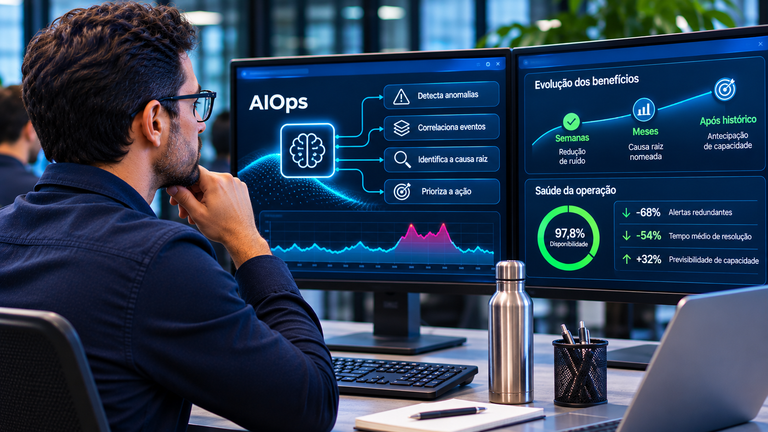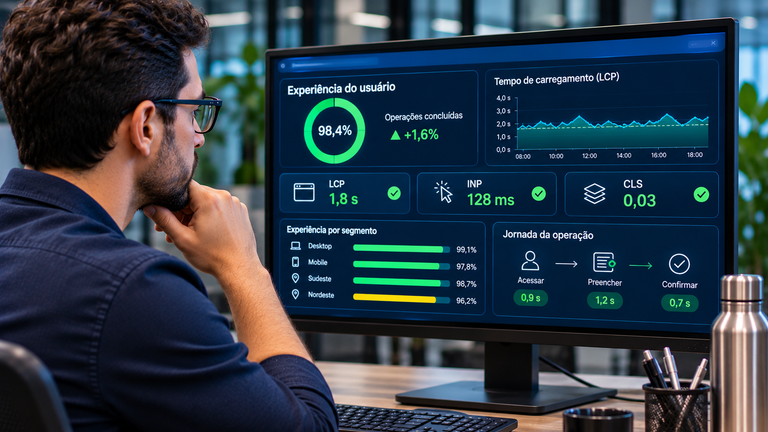


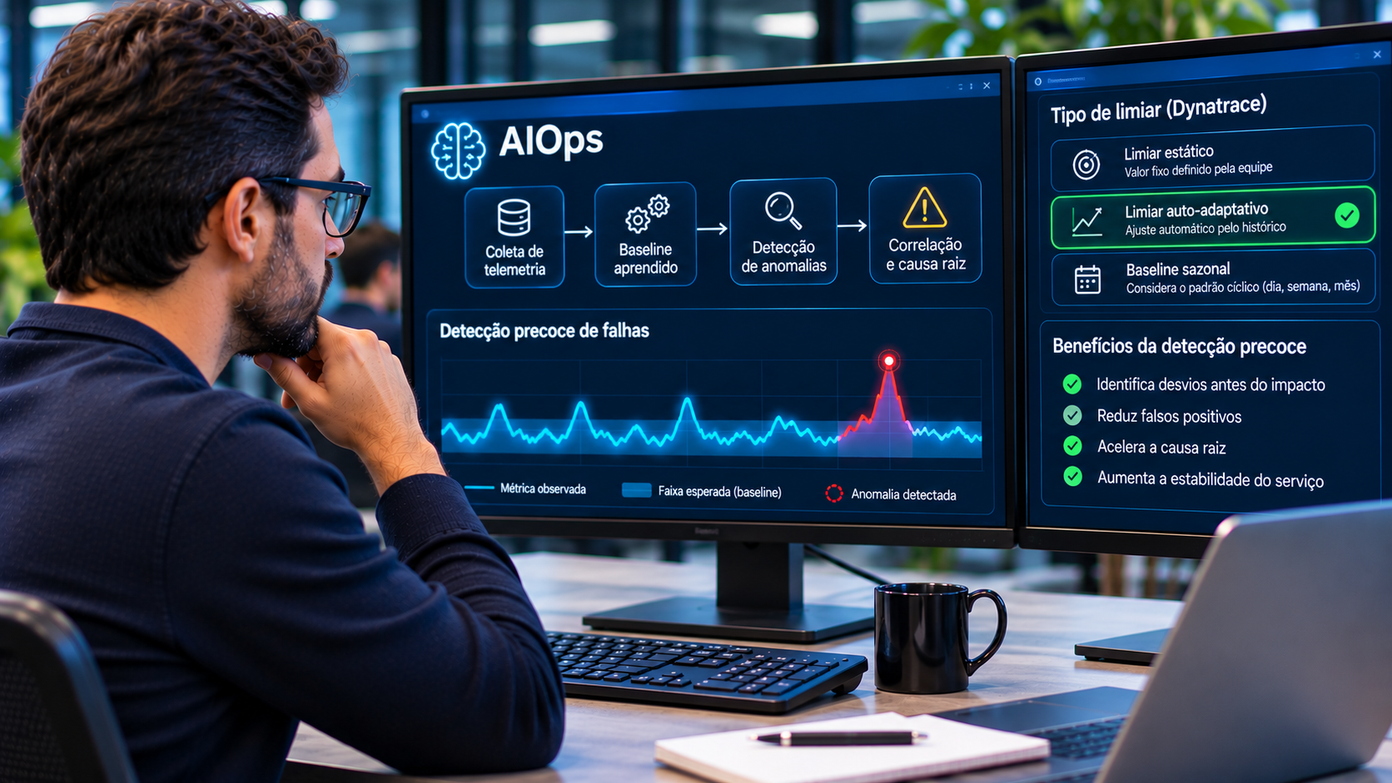
AIOps funciona em quatro etapas encadeadas: ingestão de telemetria, correlação de eventos, determinação de causa raiz e ação. Cada etapa consome o produto da anterior, e a qualidade do que entra na primeira decide o teto do que sai na última. Na plataforma Dynatrace, o motor Davis executa a análise apoiado no mapa de dependências do Smartscape.
Cada etapa consome o produto da etapa anterior, e nenhuma delas recupera informação que se perdeu antes. É por isso que a decisão tomada na ingestão limita o que a análise causal consegue afirmar três etapas adiante.
Artificial Intelligence for IT Operations, ou AIOps, funciona como um fluxo de quatro etapas: ingestão de dados de telemetria, correlação de eventos, determinação de causa raiz e ação. O fluxo é contínuo, não pontual. A plataforma observa o ambiente sem interrupção, aprende o comportamento normal de cada componente e revisa esse aprendizado a cada nova amostra recebida.
O ciclo se fecha quando o resultado da ação retorna como dado de entrada, no que a engenharia de operações chama de ciclo de retorno.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
O fluxo da AIOps, em quatro etapas
O funcionamento da AIOps se organiza em quatro etapas, sempre nesta ordem: ingestão, correlação, determinação de causa raiz e ação. A ordem não é convenção didática, porque uma etapa só dispõe do insumo que a anterior produziu.
A primeira etapa é a ingestão de dados de telemetria, que traz logs, métricas, traces e eventos de toda a stack para um mesmo repositório consultável.
A segunda etapa é a correlação de eventos, que agrupa sinais pertencentes a um mesmo problema e separa esse agrupamento das coincidências temporais.
A terceira etapa é a determinação de causa raiz, que percorre o mapa de dependências do ambiente para nomear o componente que originou a cadeia de falhas.
A quarta etapa é a ação, que se materializa como recomendação apresentada ao plantão ou como remediação executada de forma automatizada.
O encadeamento das quatro produz previsibilidade. Para o CIO, o CTO e o CEO, essa previsibilidade significa que a organização passa a saber por que os incidentes acontecem, e não apenas quantos aconteceram. Para o Site Reliability Engineer, ou SRE, responsável pelo plantão, o mesmo encadeamento define quanto do tempo de resolução é gasto entendendo a falha em vez de corrigindo a falha.
Etapa 1: ingestão de telemetria
A ingestão de dados é a etapa em que a telemetria produzida pelo ambiente chega até a camada de análise. Quatro tipos de sinal entram nessa porta, cada um respondendo a uma pergunta diferente sobre o sistema.
As métricas são o painel do carro: valores numéricos amostrados em intervalos regulares, que informam temperatura, rotação e velocidade do sistema em um dado instante. Os logs são o diário de bordo, com o registro textual do que cada componente fez e o detalhe que a métrica agregada descarta. Os traces são o GPS de uma viagem, mostrando cada parada que uma requisição fez ao atravessar serviços distribuídos. Os eventos registram mudanças de estado, como uma implantação, um reinício de contêiner ou uma alteração de configuração.
A origem desses sinais também se divide por disciplina. O Application Performance Monitoring, ou APM, produz a telemetria do lado da aplicação e da infraestrutura que a sustenta. O Digital Experience Monitoring, ou DEM, produz a telemetria do lado de quem usa o sistema, no navegador e no aplicativo móvel. As duas origens entram pela mesma porta de ingestão, e o fluxo perde alcance quando só uma delas alimenta a análise.
A coleta acontece por dois caminhos dentro da plataforma Dynatrace, e a escolha entre eles é arquitetural.
O primeiro caminho é o OneAgent, agente unificado que faz a descoberta automática da stack. Instalado no host, ele identifica processos, contêineres, bibliotecas e serviços sem que alguém precise declarar o inventário, e passa a instrumentar o que encontrou. Instrumentação equivale às câmeras instaladas na fábrica, e o setor sem câmera é o setor sobre o qual nada pode ser explicado depois.
O segundo caminho é o OpenTelemetry, padrão aberto e vendor-neutral da CNCF para gerar telemetria, que funciona como o padrão USB-C da telemetria. O transporte até a plataforma acontece pelo OpenTelemetry Protocol, ou OTLP, que é o envelope dos correios levando a carga até o destino.
O modelo híbrido combina os dois: OneAgent onde a cobertura automática compensa, OpenTelemetry onde a aplicação já está instrumentada ou onde a equipe quer manter controle explícito sobre os atributos emitidos.
Nesta etapa aparecem duas decisões que condicionam tudo o que vem depois. A primeira é a política de sampling, a amostragem que decide qual fração dos traces será preservada. Sampling é a pesquisa eleitoral da telemetria: observa uma parte para inferir o todo, e erra quando a parte observada não representa o todo. A segunda decisão é a governança de atributos, o acordo sobre como cada serviço, ambiente e unidade de negócio será nomeado no dado emitido.
Para o gerente de infraestrutura, a ingestão é onde o custo nasce. Volume coletado, granularidade de métrica e retenção contratada formam a conta, e cardinality alta, a quantidade de valores distintos de um atributo, multiplica essa conta quando identificadores únicos entram como rótulo. Coletar com propósito significa exigir de cada métrica, log e trace uma pergunta operacional ou de negócio que ele responda.
O Grail sustenta essa etapa no armazenamento, reunindo logs, métricas, traces e eventos em escala, com períodos de retenção definidos conforme o tipo de dado e a configuração adotada, permitindo consultas e análises sobre o histórico armazenado. O Dynatrace Query Language, ou DQL, é o instrumento de consulta sobre esse acervo, e permite reconstituir o estado do ambiente semanas depois do incidente.
Etapa 2: correlação de eventos
A correlação de eventos transforma um volume de sinais isolados em um conjunto de problemas contáveis. O insumo é o dado ingerido, e o produto é o agrupamento.
Em um ambiente distribuído, uma única degradação produz sintoma em todas as camadas que dependem do componente afetado. As filas crescem, os tempos limite se esgotam, os erros se propagam para cima na cadeia de chamadas. Cada camada instrumentada emite seu próprio alerta, e todos chegam ao mesmo canal quase ao mesmo tempo. Sem correlação, a equipe de operações recebe um volume de notificações que descrevem sintomas verdadeiros de um problema único.
A correlação opera sobre três dimensões combinadas. A leitura temporal observa quais anomalias começaram na mesma janela. A topologia informa quais componentes se comunicam entre si segundo o mapa de dependências vigente. A camada semântica agrupa sinais que compartilham atributos, como o mesmo serviço, o mesmo ambiente ou a mesma transação de negócio.
A governança de atributos decidida na ingestão mostra o seu efeito aqui. Quando o mesmo serviço aparece sob nomes diferentes em cada sistema de origem, a dimensão semântica perde poder de agrupamento, e a análise recai sobre tempo e topologia. O motor continua funcionando, com menos evidência do que poderia ter.
O produto da correlação é um objeto de problema, não uma lista de alertas. Esse objeto reúne todas as anomalias correlacionadas, o intervalo em que ocorreram, os componentes envolvidos e as transações de usuário afetadas.
Para o profissional de DevOps, a correlação muda a leitura da entrega. Quando uma implantação recente aparece dentro do objeto de problema como evento correlacionado, a decisão de reverter deixa de depender de intuição sobre coincidência de horário, e a hipótese de regressão entra na análise de imediato.
Etapa 3: determinação de causa raiz
A determinação de causa raiz é a etapa em que a análise deixa de descrever o que aconteceu e passa a explicar por que aconteceu. Correlação e causalidade são coisas distintas, e a distância entre as duas é o argumento técnico central da AIOps.
Correlação temporal registra que dois eventos ocorreram próximos no tempo. É um sinal útil e insuficiente. Dois componentes degradam na mesma janela sem que um tenha causado o outro, e a coincidência é real e observável sem autorizar conclusão sobre origem. Ordenar sintomas por horário produz uma narrativa plausível e errada.
A causalidade exige contexto estrutural. Para afirmar que o evento A causou o evento B, a análise precisa saber que B depende de A, e precisa conhecer a topologia que ligava os dois no momento exato do incidente.
O Smartscape fornece esse contexto. Trata-se do mapa de dependências do ambiente em tempo real, que registra quais serviços chamam quais serviços, quais bancos cada aplicação consome e por onde o impacto se propaga. O mapa deixa de ser recurso de visualização e vira insumo de análise.
O Davis, dentro do Dynatrace Intelligence, é responsável pela análise causal e percorre esse mapa. A IA causal atua na identificação da causa e do contexto do problema, enquanto os dashboards organizam e tornam exploráveis os sinais operacionais.
O resultado da etapa é um veredito nomeado: o componente de origem, o caminho de propagação até o usuário e a ordem em que os sintomas apareceram. Em vez de uma lista de anomalias ordenada por horário, a equipe recebe uma explicação verificável no ambiente real.
Para o SRE, isso muda a natureza do trabalho durante o plantão. O diagnóstico chega pronto em vez de exigir que a equipe o construa sob pressão, e a fase de compreensão para de consumir o tempo médio de resolução. O orçamento de erro, a margem de indisponibilidade que a operação pode gastar no período sem violar o compromisso de serviço, passa a ser gasto em correção em vez de investigação.
Poucas operações chegam ao incidente com topologia, telemetria e governança já alinhadas entre si, e quando esse alinhamento falta a equipe descobre a lacuna no pior momento possível, com o sistema fora do ar. A Rike IS avalia o estágio atual desse alinhamento junto com o time interno, antes do primeiro incidente que o expõe.
Etapa 4: ação, entre recomendar e executar
A ação é a etapa final do ciclo, e existe em dois modos: recomendação e remediação automatizada. A escolha entre os dois não é apenas técnica, porque depende de risco, de reversibilidade e de maturidade da operação.
No modo de recomendação, a plataforma entrega o diagnóstico e a sugestão de intervenção, e um humano decide. O ganho está na velocidade da decisão, porque a informação chega estruturada.
No modo de remediação automatizada, a plataforma aciona um fluxo de trabalho que executa a intervenção sem espera por aprovação. Reinício de um serviço travado, ajuste de escala horizontal diante de saturação previsível, redirecionamento de tráfego para uma réplica saudável e reversão de uma implantação recém-promovida são exemplos de ação delegada à plataforma.
A pergunta que aparece em toda avaliação séria da disciplina é se a AIOps age sozinha ou apenas recomenda. A resposta honesta é que a disciplina faz as duas coisas, e a organização decide o limite entre elas, não a plataforma.
Existe um critério prático para essa decisão. Ação reversível, de baixo raio de impacto e com resultado verificável logo em seguida é candidata natural à automação. Ação irreversível, que toque dado de cliente ou que altere configuração compartilhada por muitos serviços, permanece sob decisão humana, mesmo quando o diagnóstico é inequívoco.
Automatizar sobre diagnóstico ruim multiplica o erro em vez de corrigir o problema. Uma remediação disparada a partir de causa raiz mal determinada age no componente errado, e o sintoma real continua ativo enquanto a operação acredita ter resolvido. Por isso a ordem das etapas importa tanto: a operação habilita a automação por último, nunca primeiro.
A etapa de ação fecha o ciclo. O resultado, executado por um humano ou pela plataforma, volta ao ambiente como novo comportamento observável, entra de novo pela ingestão e alimenta o aprendizado da linha de base. Esse retorno é o que separa uma operação que corrige incidentes de uma operação que reduz a recorrência deles.
Para o profissional de DevOps, esse ciclo é o que liga observabilidade e entrega contínua. Cada promoção de versão passa a ser avaliada contra o comportamento anterior do serviço, e a regressão aparece enquanto a reversão ainda é barata.
O que quebra o fluxo
O fluxo falha por motivos previsíveis, e três aparecem com mais frequência. Nenhum deles é defeito de plataforma, e todos nascem de decisões tomadas na primeira etapa.
O primeiro motivo de quebra é a governança de atributos ausente. Sem convenção acordada de nomes de serviço, de etiquetas de ambiente e de unidades de métrica, o mesmo componente chega à plataforma sob identidades diferentes. A correlação semântica perde tração, o objeto de problema se fragmenta em vários problemas menores, e o operador volta a receber ruído. Corrigir convenção depois que o dado está em produção custa mais do que definir antes, e costuma exigir reprocessamento de histórico.
O segundo motivo de quebra é o sampling mal calibrado. Amostragem agressiva demais economiza ingestão e descarta justamente os traces de erro e de latência elevada, que são os que a análise precisaria examinar. Amostragem permissiva demais preserva tudo e eleva o custo sem retorno proporcional. Em sistemas críticos, o sampling tail-based é geralmente preferido, porque decide o que preservar depois de conhecer o resultado da transação e mantém erro e latência fora da linha de base na amostra.
O terceiro motivo de quebra é a cobertura incompleta da instrumentação. Componente não instrumentado é componente invisível para a análise causal. Quando um componente invisível é a origem real da falha, o motor aponta como causa o ponto observável mais próximo dele, e o veredito fica plausível, coerente com os dados disponíveis e incompleto. A equipe corrige um sintoma e volta a ver o mesmo problema dias depois.
Existe ainda um quarto ponto, de outra natureza, que compromete o fluxo sem tocar em dado nenhum: a curva de aprendizagem da equipe interna. Organizações que tratam capacitação como etapa posterior passam a usar uma fração das capacidades contratadas, e atribuem à plataforma um resultado que decorre de falta de treino.
Para o gerente de infraestrutura, os três primeiros motivos formam a agenda de manutenção do fluxo. Revisão periódica de convenção de atributos, revisão da política de amostragem por carga de trabalho e auditoria de cobertura de instrumentação são atividades de governança de performance, não projetos isolados com data de encerramento.
Como avaliar a maturidade do fluxo na operação atual
Avaliar a maturidade do fluxo é mais útil do que perguntar se a organização já tem AIOps. Três verificações objetivas dão a resposta, e a própria equipe de operações consegue executá-las sem consultoria externa.
A primeira verificação recai sobre a ingestão. Um serviço crítico qualquer serve de amostra: quantos nomes ele tem nos sistemas de telemetria em uso? Um nome indica governança de atributos praticada, e nomes concorrentes indicam que a correlação semântica está trabalhando com evidência parcial.
A segunda verificação recai sobre a correlação. No último incidente relevante, quantas notificações a equipe de operações recebeu naquele intervalo? O número de notificações dividido pelo número de problemas reais é a medida direta do ruído que o plantão absorve.
A terceira verificação recai sobre a determinação de causa raiz. Quanto tempo separou o primeiro alerta da primeira hipótese correta sobre a origem da falha? Esse intervalo é a parte do tempo médio de resolução que a análise causal ataca, e é onde a diferença aparece primeiro depois de uma implantação bem conduzida.
Operações que respondem bem às três verificações costumam ter, além da plataforma, uma disciplina de governança sustentada ao longo do tempo. Operações que respondem mal quase sempre têm a plataforma e não têm a disciplina.
Perguntas frequentes
O fluxo funciona em um ambiente que tem métricas e logs, mas não tem traces?
Funciona com alcance reduzido. Sem traces, a plataforma detecta anomalia e agrupa sinais por tempo e por atributo, e perde a evidência de qual serviço chamou qual serviço dentro de uma mesma requisição. O prejuízo aparece na terceira etapa: a análise indica o componente que apresentou sintoma, e não o ponto da cadeia distribuída onde a degradação nasceu.
Quanto tempo a plataforma precisa observar o ambiente antes de o fluxo dar resultado confiável?
O suficiente para cobrir um ciclo completo de sazonalidade da carga. Um serviço com pico em dia útil, vale no fim de semana e volume atípico no fechamento do mês só tem linha de base representativa depois que a plataforma observou os três comportamentos. Antes disso, a leitura de anomalia trata variação normal como desvio.
A determinação de causa raiz substitui a análise pós-incidente?
Não substitui. A etapa de causa raiz responde qual componente originou a falha, dentro do incidente e sob pressão de tempo. A análise pós-incidente responde por que aquele componente pôde falhar daquele jeito, e essa pergunta envolve decisão de arquitetura, processo de mudança e prioridade de trabalho pendente. O veredito da plataforma é insumo da análise posterior, não o encerramento dela.
Quem mantém o fluxo depois da implantação: a equipe de operações ou o time de desenvolvimento?
A manutenção se divide entre os dois. A equipe de operações responde pela política de amostragem, pela retenção contratada e pela revisão do que a plataforma observa. O time de desenvolvimento responde pelos atributos que o próprio serviço emite, porque só ele decide como o serviço se nomeia no momento em que o código publica o dado. Fluxo que trata atributo como assunto exclusivo de operações degrada a cada nova entrega.
Quem responde pelo resultado quando a plataforma executa a remediação sem aprovação humana?
A organização que autorizou a automação, e a responsabilidade permanece com ela mesmo quando a plataforma executa a ação. Por isso o catálogo de ações automatizadas exige três controles: dono nomeado para cada ação, registro de toda execução e caminho de reversão testado antes do primeiro disparo em produção. Automação sem esses controles dá velocidade à operação e deixa a prestação de contas sem endereço.
Colocar as quatro etapas em funcionamento exige diagnóstico do ambiente atual, decisão arquitetural entre OneAgent, OpenTelemetry e modelo híbrido, convenção de atributos acordada antes da instrumentação e revisão continuada depois que o fluxo entra em produção. A Rike IS conduz esse trabalho com consultoria, implantação, treinamento e governança de performance sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o fluxo do seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações