

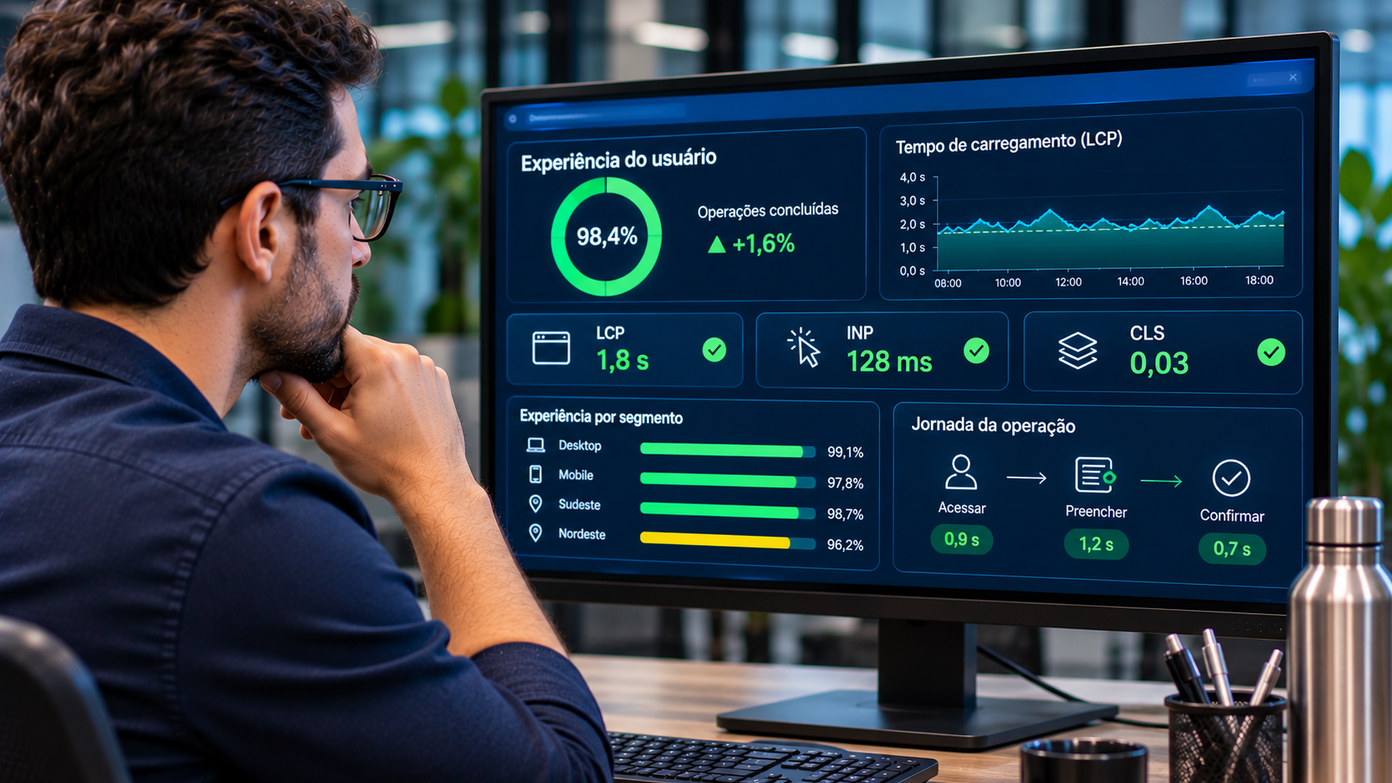
Prevenir falha de sistema pelo lado do usuário é detectar a degradação que atinge parte da base enquanto os indicadores de infraestrutura seguem dentro do esperado. Erro de front-end, lentidão por região e fluxo crítico interrompido não aparecem em indicador de host, e três decisões sustentam a prevenção: quais fluxos vigiar, o que conta como falha em cada um e como o sinal vira ação.
Sistemas distribuídos modernos quase nunca param por inteiro. O que acontece com frequência é uma operação específica quebrar para um recorte de usuários, em um dispositivo, em uma região ou em uma versão do aplicativo, enquanto o restante do ambiente responde normalmente e nenhum limiar de alerta é ultrapassado.
Prevenir falha de sistema, na ótica de quem usa o sistema, é identificar essa degradação antes que ela vire reclamação. A falha percebida pelo usuário e a indisponibilidade registrada pelo servidor são dois eventos distintos, com detecções distintas, e apenas o primeiro chega ao atendimento.
A prevenção, nesse recorte, depende de observar o sistema onde ele acontece para a pessoa: no navegador, no aparelho, na rede que ela usa, no fluxo que ela precisa concluir. Sem esse ponto de medição, o intervalo entre o impacto e a percepção passa a ser medido pela paciência de quem esperou.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte que operam sistemas críticos.
A falha que o painel de infraestrutura não mostra
Indicadores agregados de infraestrutura respondem a uma pergunta específica: o recurso está disponível e dentro da capacidade prevista? A pergunta é legítima e a resposta é útil, mas ela não cobre o que a pessoa do outro lado da tela conseguiu fazer. Processador, memória, disco e taxa de erro do servidor podem permanecer estáveis durante toda a duração de uma falha que impede a conclusão de uma operação de negócio.
Três mecanismos produzem o descolamento entre painel saudável e usuário insatisfeito.
O primeiro é a degradação parcial. Uma operação específica passa a falhar ou a responder devagar enquanto as demais continuam saudáveis, e a média do conjunto absorve o desvio. Quanto maior o volume total de requisições, mais eficiente é essa diluição, porque o subconjunto afetado representa uma fatia pequena do agregado.
O segundo é o código executado fora do servidor. Um erro de JavaScript no navegador interrompe o preenchimento de um formulário sem gerar registro algum do lado da aplicação, porque a requisição nunca chegou a ser enviada. Do ponto de vista da infraestrutura, aquele usuário simplesmente não existiu.
O terceiro é a variação por condição de acesso. A mesma aplicação, servida da mesma origem, entrega tempos diferentes para quem acessa de uma capital com conexão estável e para quem acessa de uma cidade pequena com rede saturada. A diferença também aparece entre um aparelho recente e um modelo antigo, já sem folga de processamento.
Somados, os três produzem um resultado previsível: o painel exibe saúde enquanto o canal de atendimento registra insatisfação, e as duas informações estão corretas ao mesmo tempo.
Para o CIO, o CTO e o CEO, um indicador que sinaliza normalidade durante uma falha real é um problema de risco, porque a descoberta do incidente sai de dentro da organização e passa para o cliente. O custo dessa inversão aparece em reputação, em volume de chamado e no desgaste da relação com as áreas de negócio.
Para o Site Reliability Engineer, ou SRE, o alerta que não dispara é um problema de fila de plantão. Sem alerta não há entrada na fila, e o incidente começa a ser tratado apenas quando alguém de fora do time de engenharia levanta a mão.
Onde a falha aparece primeiro para o usuário
A falha percebida costuma se manifestar em quatro lugares antes de virar indisponibilidade completa, e cada um deles tem um sinal próprio de detecção.
O primeiro é o fluxo crítico de negócio. Consultar saldo, emitir uma guia, concluir uma transferência, finalizar uma compra: são operações cuja interrupção tem consequência imediata, e a taxa de conclusão delas cai antes de qualquer métrica de servidor se mexer. Uma queda de conclusão em uma etapa intermediária, sem aumento correspondente de erro no servidor, indica problema no lado do usuário.
O segundo é o front-end. Erro de JavaScript, recurso que não carrega, biblioteca de terceiro que atrasa a renderização: nada disso passa pelo registro da aplicação, e tudo isso impede a pessoa de seguir adiante.
O terceiro é a distribuição geográfica. Latência que sobe apenas para uma região, para um provedor de acesso ou para uma rota específica produz uma população insatisfeita concentrada, invisível em qualquer indicador nacional agregado.
O quarto é a versão. Uma implantação nova pode degradar a experiência apenas para quem já recebeu a atualização, e a comparação entre versões é o que revela o efeito antes que a distribuição alcance toda a base.
Abandono é o último sinal antes da indisponibilidade percebida. Quando a pessoa desiste da operação, ela deixa de gerar requisição, e o tráfego que some é justamente o tráfego que deveria ter alertado alguém.
Para o gerente de infraestrutura, saber em qual dos quatro lugares a falha nasceu muda a conversa sobre capacidade. Descobrir que a degradação era regional, ou restrita a uma versão do aplicativo, evita ampliação de recurso central que não resolveria o sintoma e ainda elevaria o custo mensal do ambiente.
Como observar o sistema pelo lado de quem usa
A disciplina que trata dessa observação se chama Digital Experience Monitoring, ou DEM, e mede o comportamento do sistema a partir do navegador, do aplicativo e da rede do usuário, em vez de medir a partir do servidor que respondeu.
A medição acontece por duas vias complementares. O Real User Monitoring, ou RUM, coleta dados de sessões efetivas, com alta fidelidade e cobertura limitada ao que alguém percorreu. O monitoramento sintético executa em intervalos regulares um roteiro predefinido que percorre o fluxo crítico do começo ao fim, e cobre exatamente a lacuna do RUM ao verificar o fluxo mesmo sem tráfego.
Operações maduras usam as duas juntas. O sintético estabelece a linha de base e dispara o alarme, enquanto o RUM explica o que a população efetiva enfrentou e permite segmentar por região, dispositivo e versão até isolar o recorte afetado.
Instrumentação são as câmeras instaladas na fábrica: sem elas, o gestor sabe quanto entrou e quanto saiu, e nada sobre onde a linha parou.
Escolher quais fluxos instrumentar primeiro, com qual profundidade e com qual governança de atributos é uma decisão de projeto, não de configuração. A ordem que a Rike IS aplica nas implantações segue um critério pouco intuitivo: o primeiro fluxo instrumentado não é o mais acessado, e sim aquele cuja falha a organização hoje só descobre pelo canal de atendimento. Fluxo de alto volume costuma já ter vigilância improvisada em algum painel, e o fluxo cego é o que produz surpresa.
A escolha dos atributos de sessão vem junto, no mesmo desenho. Atributo definido depois obriga a reprocessar a leitura histórica, e a comparação entre versões perde a base.
Priorizar por impacto no usuário, não por volume de alerta
Instrumentado o lado do usuário, aparece um problema novo: a lista de coisas erradas cresce mais rápido que a capacidade de corrigir. Priorizar pelo alerta mais frequente é a escolha intuitiva e costuma ser a errada, porque frequência de alerta não guarda relação com custo para o negócio.
Três critérios ordenam melhor essa fila: a população afetada em termos absolutos, a posição da falha dentro do fluxo e a existência de alternativa fora do canal digital. Em órgãos públicos, a ausência de alternativa costuma significar deslocamento físico do cidadão até um posto de atendimento, o que altera o peso do terceiro critério em relação ao setor privado.
Aplicados os três, a fila deixa de ser reativa e passa a ser defensável diante de quem pergunta por que uma correção veio antes da outra.
Para o profissional de DevOps, ordenar a fila por impacto no usuário muda o ciclo de entrega. Uma implantação que degrada a taxa de conclusão de um fluxo crítico aparece em minutos no RUM, e a reversão acontece antes que a reclamação chegue ao atendimento. O retorno de informação sobre a mudança deixa de depender do relato do cliente.
Definir critério de prioridade antes do incidente reduz a negociação de gravidade durante o incidente. Equipes que fazem esse acordo com antecedência discutem execução sob pressão, em vez de discutir importância.
Traduzir esse acordo em alerta, em painel e em rotina de revisão é trabalho de governança de performance, e em ambiente já em operação ele custa mais do que em projeto novo, porque a fila herdada precisa ser reordenada sem parar o plantão. A Rike IS conduz essa reordenação junto da equipe que já está de sobreaviso.
Da falha percebida à causa raiz
Detectar a falha percebida tem valor limitado se o próximo passo for abrir uma investigação do zero. A prevenção depende de encurtar o caminho entre o sintoma que o usuário sentiu e o componente técnico que o produziu, sem troca de ferramenta no meio do percurso. Esse caminho tem quatro passos, e a ordem entre eles importa.
O primeiro passo é delimitar o recorte. Qual operação degradou, para qual população, em qual região, em qual versão e desde quando. Um recorte preciso reduz o espaço de busca antes que a investigação comece, e um recorte ausente obriga a equipe a examinar o ambiente inteiro.
O segundo passo é separar o lado. O tempo se acumulou antes da resposta do servidor ou depois dela? A resposta divide o problema em dois territórios com métodos distintos: back-end e infraestrutura de um lado, front-end e rede do outro.
O terceiro passo é seguir o trace, o rastreamento distribuído da requisição, que funciona como o GPS de uma viagem ao mostrar cada parada do percurso. O trace revela em qual etapa o tempo foi consumido: consulta ao banco, fila, dependência externa, processamento próprio.
O quarto passo é ler os registros do componente identificado, onde aparecem a exceção e a mensagem que a métrica não carrega.
Na plataforma Dynatrace, os quatro passos ocorrem sobre um conjunto correlacionado de dados. O OneAgent coleta esses dados e descobre sozinho os componentes da stack e as dependências entre eles, alimentando o Smartscape, o mapa de dependências em tempo real que se mantém atualizado conforme o ambiente muda, sem inventário desenhado à mão.
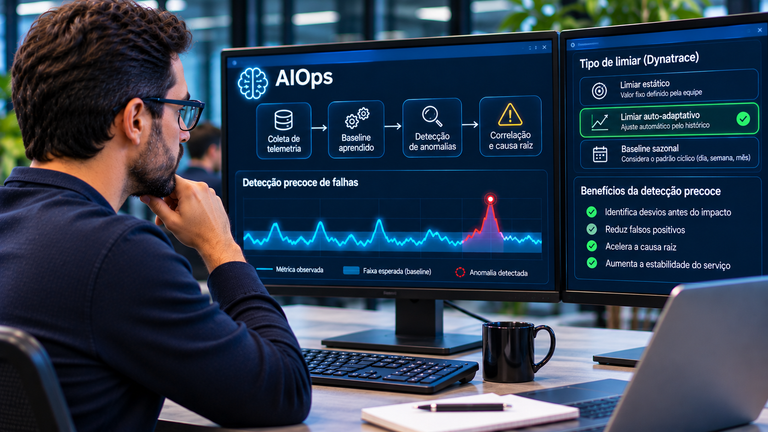
O Davis, motor de inteligência artificial causal da plataforma, encurta o segundo e o terceiro passos ao apontar a causa raiz com base nesse mapa, em vez de entregar uma lista de anomalias ordenada por horário. IA causal opera como o médico que diagnostica, enquanto o dashboard é apenas o termômetro.
Os dois passos restantes dependem de conseguir voltar ao dado bruto depois do fato. O Grail retém sessão, trace e registro em volume massivo e por longos períodos, com consulta rápida sobre todo o histórico, e o Dynatrace Query Language, ou DQL, é a linguagem que interroga esse conjunto. Investigar uma falha percebida de duas semanas atrás, segmentada por versão do aplicativo, é uma consulta, não um pedido de restauração de histórico.
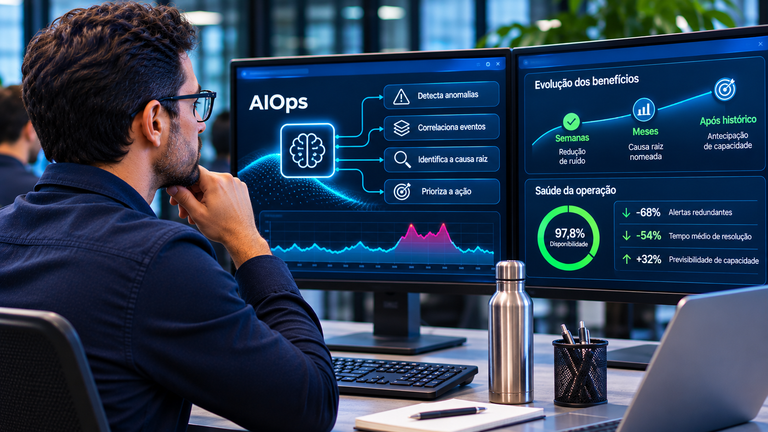
Correlacionar sintoma e causa a partir do mapa de dependências é o que Artificial Intelligence for IT Operations, ou AIOps, designa quando aplicada a operações. A disciplina usa a topologia e o histórico para reduzir o tempo médio de resolução, em vez de somar mais alertas à fila do plantão, e o ganho para o SRE é direto, porque o tempo gasto em triagem passa a ser gasto em correção.
Application Performance Monitoring, ou APM, entra nesse percurso do lado de dentro da aplicação, medindo latência de transação e gargalo em código. DEM observa por fora e APM observa por dentro, e os dois se completam no mesmo trajeto de investigação. Prevenir falha percebida sem os dois obriga a equipe a adivinhar metade do caminho.
Três decisões que previnem a falha antes do impacto
Prevenção, nesse recorte, não é um projeto com data de término. São três decisões tomadas em ordem, e cada uma depende da anterior estar resolvida.
A primeira decisão é escolher quais fluxos vigiar. Cobertura total é uma meta que atrasa a entrega e eleva o custo de ingestão sem melhorar a detecção do que importa. O ponto de partida são as operações cuja interrupção tem consequência imediata para o negócio ou para o cidadão, instrumentadas com monitoramento sintético e com RUM, e a cobertura se amplia depois que a linha de base está estabelecida. A escolha dos primeiros fluxos define o que a organização vai enxergar em um incidente futuro.
A segunda decisão é definir o que conta como falha para cada fluxo. Um limiar de tempo de resposta lido em percentil, uma taxa mínima de conclusão, uma taxa máxima de erro de front-end: cada fluxo crítico precisa de um alvo declarado, medido do lado do usuário e revisado quando o comportamento da base muda. Sem alvo declarado por fluxo, o alerta vira opinião, e opinião não sustenta plantão.
A terceira decisão é ligar a detecção à ação. Um sinal que chega ao painel e para ali não previne nada. O que transforma o sinal em prevenção é o encaminhamento automático para quem pode agir, com o recorte já delimitado e com a causa provável já apontada.
A governança que sustenta essas três decisões é contínua. Fluxo crítico muda, aplicação recebe versão nova, base de usuários migra de dispositivo, e o desenho que funcionava no trimestre anterior perde aderência sem que ninguém perceba. Revisão periódica dos alvos, do escopo instrumentado e da governança de atributos é o que mantém a detecção alinhada ao sistema real.
Para o CIO, o CTO e o CEO, o efeito das três decisões é de previsibilidade. Falha detectada antes do chamado tem custo menor, escopo menor e conversa mais curta com as áreas de negócio, e o retorno do investimento aparece na diferença entre incidente contido e incidente público. Para o gerente de infraestrutura, o efeito é de precisão no gasto. Para quem trabalha com entrega contínua, é a possibilidade de reverter uma mudança ruim em minutos. Para o SRE, é começar a investigação com o recorte pronto.
Perguntas frequentes
Como separar falha da aplicação de problema na rede do próprio usuário?
A comparação entre a população afetada e a base de atributos de rede da sessão resolve a maior parte dos casos. Quando a degradação se concentra em um provedor de acesso ou em uma rota, e a mesma operação responde dentro do alvo para as demais origens, o problema está no trajeto, não na aplicação. Um roteiro sintético disparado de um ponto controlado dentro da mesma região fecha o diagnóstico: se ele conclui a operação dentro do alvo, a aplicação está íntegra. A conclusão muda a destinação do chamado, e a equipe de engenharia sai da conversa.
O que fazer quando a degradação vem de um serviço de terceiro?
Gateway de pagamento, provedor de identidade e serviço de consulta externa quebram fluxo crítico sem que exista código próprio para corrigir. O tratamento é outro: medir o terceiro como se fosse componente interno, declarar um alvo próprio para a chamada externa e registrar a evidência do desvio. Sem esse registro, a conversa com o fornecedor vira troca de impressões. Com ele, a organização discute contrato com dado de sessão real na mão, e decide se o fluxo precisa de caminho alternativo enquanto o terceiro não normaliza.
Instrumentar o navegador expõe dado pessoal do usuário?
Depende inteiramente da governança de atributos definida antes de ligar a coleta, porque a instrumentação de front-end captura o que o desenho mandar capturar. Identificador técnico de sessão e comportamento de navegação bastam para segmentar falha, e conteúdo digitado em campo de formulário não precisa sair do navegador. Mascarar campo sensível, decidir o que constitui identificador aceitável e revisar essa lista a cada versão da aplicação é decisão de projeto. Coleta ampla ligada primeiro e filtrada depois deixa histórico que ninguém quer ter guardado.
Qual a diferença entre falha percebida e lentidão no sistema?
Lentidão é uma das formas da falha percebida, não sinônimo dela. A pessoa que espera além do tolerável e a pessoa que recebe erro de front-end sofrem impactos diferentes, com detecções diferentes. A espera aparece na cauda da distribuição de tempo, e o erro aparece na taxa de falha de sessão. Tratar tudo como lentidão leva a equipe a investigar desempenho quando o defeito é funcional, e o tempo de resolução cresce por diagnóstico errado, não por complexidade técnica.
Aplicativo móvel muda o que precisa ser monitorado?
Muda em dois pontos. A distribuição da versão deixa de ser instantânea, porque a atualização depende da loja e da decisão de cada usuário, e o ambiente passa a conviver com várias versões simultâneas por semanas. A rede também entra como variável permanente, com troca entre redes móveis e conexão instável durante a própria operação. Prevenir falha em aplicativo móvel exige comparar versões em paralelo por mais tempo e distinguir interrupção de rede de defeito da aplicação antes de abrir investigação.
Prevenir a falha que o usuário sente exige medição na ponta certa, critério de prioridade acordado antes do incidente e um caminho curto entre sintoma e causa raiz, sustentados por governança que acompanha a mudança do sistema. A Rike IS conduz esse trabalho do diagnóstico inicial à operação contínua sobre a plataforma Dynatrace, com consultoria, implantação, treinamento e governança de performance, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve os fluxos críticos do seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações