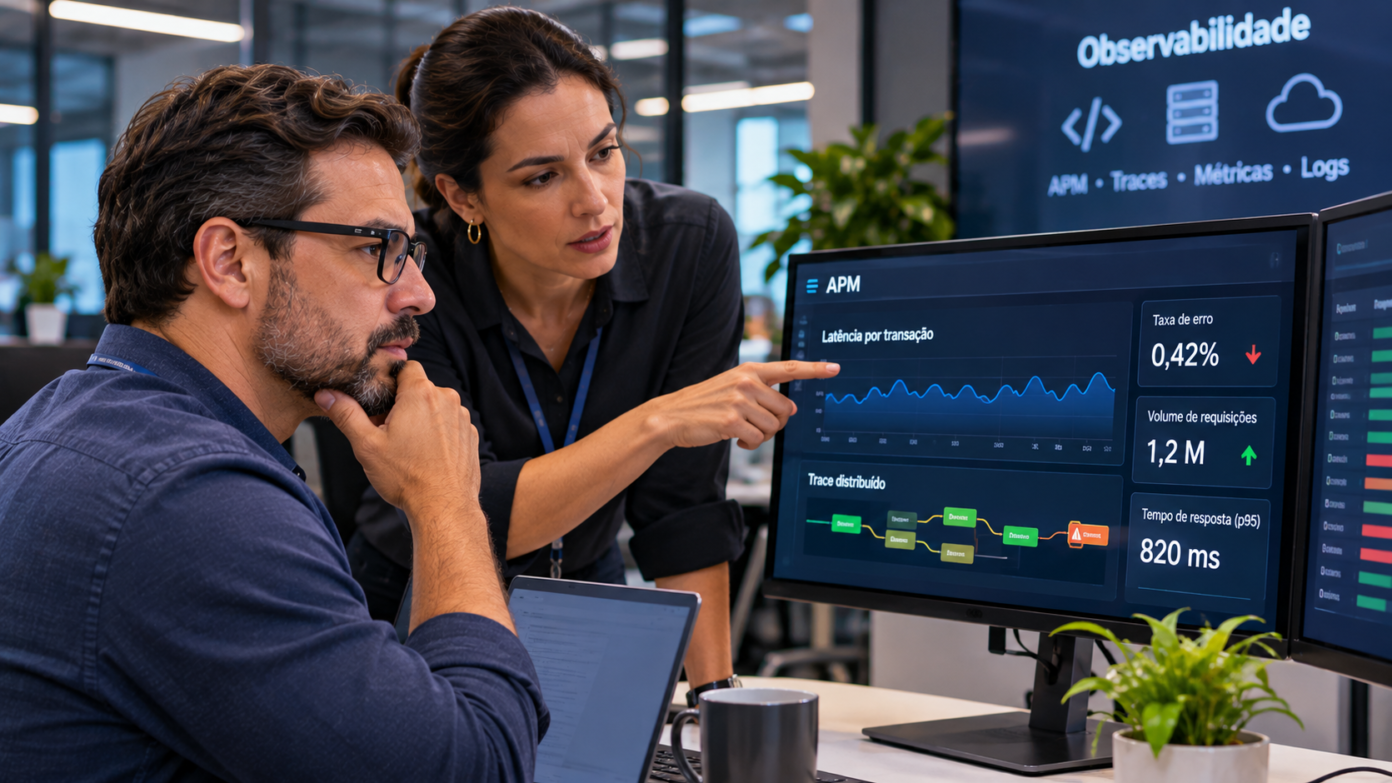
APM mede performance da aplicação por dentro do código em execução, com latência por transação, taxa de erro, volume e gargalo. A disciplina separa lentidão de infraestrutura de degradação de uma transação de negócio, instrumenta dependências externas e sustenta o trace distribuído que reconstrói o percurso de uma requisição entre dezenas de serviços.
Separar a lentidão geral da infraestrutura da degradação específica de uma transação de negócio é a distinção que nenhuma outra camada de observabilidade consegue fazer. Sem ela, uma equipe investiga servidores quando o problema está em uma consulta sem índice.
APM, sigla de Application Performance Monitoring, é a disciplina que mede performance e disponibilidade das aplicações a partir de dentro do código em execução. O escopo cobre latência por transação, taxa de erro, volume de requisições, gargalo em código e impacto de dependências externas.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
O que é APM
Monitoramento de infraestrutura observa a aplicação por fora. Ele informa que o processo consome memória, que o processador está ocupado, que a porta responde. Nenhuma dessas informações explica o que a aplicação estava fazendo.
APM observa por dentro. A instrumentação acompanha a execução do código, registra quanto tempo cada operação consumiu e reconstrói o caminho percorrido por uma requisição desde a entrada até a resposta.
A unidade de análise do APM é a transação, não o host. Uma transação pode ser a emissão de uma guia de pagamento, a consulta de saldo ou o envio de um formulário, e atravessa código de aplicação, banco de dados, fila e serviço de terceiro.
Essa mudança de unidade importa porque é a transação que o usuário percebe. Um host saudável com uma transação degradada produz painel verde e cliente insatisfeito ao mesmo tempo.
A instrumentação acontece por duas vias. A automática ocorre por agente instalado no ambiente, que detecta linguagens, frameworks e dependências sem configuração manual por componente. A manual usa bibliotecas no código, e oferece controle mais granular onde o agente não alcança.
As métricas centrais de APM
A disciplina se sustenta em quatro grupos de métricas. Cada grupo responde a uma pergunta diferente, e nenhum deles substitui os demais.
Latência por transação mede quanto tempo cada operação de negócio consome. A média isolada engana com frequência, porque esconde a cauda: um percentil elevado revela que parte dos usuários enfrenta tempo muito superior ao típico.
Taxa de erro mede a proporção de transações que não completaram corretamente. O número importa menos que a distribuição: erro concentrado em uma operação específica indica defeito, enquanto erro difuso sugere problema de infraestrutura ou de dependência.
Volume de requisições contextualiza as duas anteriores. Latência estável com volume caindo pode significar que usuários desistiram antes de completar a operação, e essa leitura só aparece quando as métricas são observadas juntas.
Gargalo em código localiza onde o tempo se acumula dentro da execução. Uma consulta sem índice, um laço que percorre coleção grande ou uma serialização custosa aparecem nesse nível de detalhe.
Métricas são o painel do carro. Elas informam que algo mudou, sem dizer qual trecho do trajeto levou até ali.
A escolha entre média e percentil decide se a métrica descreve a experiência real. A média dilui o caso extremo: se a maioria das transações completa rápido, um subconjunto lento praticamente desaparece do indicador. O percentil preserva essa informação, e ao observar o percentil mais alto de latência a equipe enxerga o tempo enfrentado pela fatia de usuários em pior situação, que costuma ser justamente a que abre chamado e a que desiste da operação.
Em sistemas críticos essa distinção tem consequência contratual. Um acordo de nível de serviço definido sobre média pode ser cumprido no papel enquanto parte relevante dos usuários enfrenta tempo inaceitável, e a evidência dessa contradição só aparece quando o indicador muda de média para percentil.
Distinguir infraestrutura de aplicação
Quando um sistema fica lento, existem duas hipóteses iniciais. A primeira é lentidão geral: o ambiente inteiro degradou, e todas as transações sofrem proporcionalmente. A segunda é degradação específica: o ambiente está saudável, e uma operação de negócio em particular passou a consumir mais tempo.
As duas hipóteses exigem investigações opostas. A primeira aponta para capacidade, rede ou saturação de recurso compartilhado. A segunda aponta para código, consulta ou dependência daquela transação.
Sem APM, essa distinção depende de inferência. A equipe observa indicadores de infraestrutura, não encontra anomalia evidente e conclui que o problema não existe, ou parte para tentativa e erro.
Com APM, a distinção é imediata. Se apenas uma transação apresenta latência elevada enquanto as demais mantêm o comportamento típico, a hipótese de lentidão geral cai de saída, e a investigação começa no lugar certo.
Dependências externas
Aplicações modernas dependem de serviços que a organização não controla: gateway de pagamento, serviço de autenticação federada, interface de consulta a órgão regulador, provedor de mensagem.
Quando um desses serviços degrada, o sintoma aparece na sua aplicação. O usuário reclama do seu sistema, o chamado chega para a sua equipe, e o indicador de disponibilidade que será cobrado é o seu.
APM instrumenta essas chamadas como parte da transação. O tempo consumido por cada dependência externa fica registrado separadamente do tempo consumido pelo código próprio. A consequência prática é dupla: a equipe identifica rapidamente que a origem é externa, e passa a dispor de evidência objetiva para acionar o fornecedor com dado em vez de percepção.
Existe um efeito secundário relevante. Dependência lenta consome recurso do lado que chama, porque conexões e threads permanecem ocupadas aguardando resposta. Uma degradação externa moderada pode esgotar o pool de conexões e produzir indisponibilidade interna ampla.
Esse mecanismo explica um padrão que confunde equipes com frequência. O serviço externo não ficou fora do ar, apenas respondeu mais devagar, e ainda assim a aplicação própria parou de atender. A causa não foi a indisponibilidade do terceiro, mas o esgotamento de recurso provocado pela espera acumulada.
Instrumentar a chamada externa permite antecipar esse cenário. Quando o tempo de resposta da dependência sobe antes de o pool saturar, existe janela para acionar limite de tempo mais curto, isolar a chamada ou degradar a funcionalidade de forma controlada.
APM em arquitetura distribuída
Em aplicação monolítica, o APM tradicional bastava. A requisição entrava, era processada em um processo e saía, e a análise cabia em um único contexto.
Arquitetura de microserviços rompeu esse arranjo. Uma única requisição de usuário atravessa dezenas de serviços, em processos e máquinas distintas, e nenhum deles tem visão do conjunto.
Nesse cenário, o trace se torna obrigatório e não opcional. Trace é o rastreamento de uma requisição percorrendo todos os serviços que participaram dela, e funciona como o GPS de uma viagem, mostrando cada parada do trajeto e onde houve atraso.
O trace se compõe de spans. Cada span registra uma operação individual, como consultar um banco ou processar um pagamento, e carrega identificador próprio, identificador do trace, marcas de tempo, atributos e estado.
Para que o trace sobreviva ao salto entre serviços, é preciso propagação de contexto. Cabeçalhos padronizados pelo W3C Trace Context, com os campos traceparent e tracestate, propagam o contexto do trace entre serviços. A propagação de contexto funciona como o carimbo no passaporte, que acompanha o viajante entre fronteiras.
Quando alguma camada não propaga esses cabeçalhos, aparece o span órfão: uma operação registrada sem ligação com o trace a que pertence. Em ambientes com sistemas legados, esse é um problema recorrente, e exige instrumentação manual cuidadosa nos pontos de entrada e de saída de cada serviço.
Dois conceitos governam o custo dessa coleta. Sampling, ou amostragem, define quais traces são preservados, e em sistemas críticos o sampling tail-based é geralmente preferido, porque decide depois de conhecer o resultado da transação e mantém erro e latência elevada na amostra. Cardinality é a quantidade de valores distintos de um atributo, e identificadores únicos por requisição fazem esse número explodir, encarecendo armazenamento e degradando consulta.
APM dentro da observabilidade full-stack
APM entrega muito e não entrega tudo. Ele explica o comportamento da aplicação e não explica por que o contêiner foi reiniciado, nem se o usuário em outra região enfrentou lentidão de rede.
Por isso APM aparece como uma das cinco capacidades essenciais de uma plataforma de observabilidade pronta para sistemas críticos. As outras quatro são monitoramento de infraestrutura e cloud, Digital Experience Monitoring, ou DEM, Artificial Intelligence for IT Operations, ou AIOps, e compliance e governança de performance.
O valor cresce quando as cinco operam sobre o mesmo conjunto de dados. A equipe parte de uma métrica anômala, salta para o trace que a originou, desse trace para os logs do serviço afetado e daí para o estado da infraestrutura naquele instante, sem trocar de ferramenta.
Na plataforma Dynatrace, o OneAgent sustenta essa integração. Uma única instalação descobre automaticamente toda a stack em execução no host, contêiner ou ambiente cloud, detectando linguagens, frameworks, bancos, filas, serviços e dependências sem configuração manual por componente.
Davis, dentro do Dynatrace Intelligence, é responsável pela análise causal da plataforma, e opera sobre esse conjunto correlacionado. Com base no mapa de dependências, ele identifica o evento gerador da cadeia de falhas e descreve o impacto no negócio, em vez de apresentar uma lista de anomalias por horário. Dashboards organizam e tornam exploráveis os sinais operacionais, enquanto a Dynatrace Intelligence complementa essa análise com detecção de anomalias, correlação e investigação causal para reduzir a triagem e orientar a resposta.
A análise posterior depende de histórico preservado. O Grail retém logs, métricas, traces e eventos em volume massivo, com períodos de retenção que variam conforme o tipo de dado e a configuração adotada, mantendo consulta rápida sobre todo o acervo, e o Dynatrace Query Language, ou DQL, é a linguagem que interroga esse histórico. Reconstituir um incidente semanas depois exige as duas peças.
O que muda para cada time
APM produz quatro efeitos distintos dentro da organização, e cada efeito justifica o investimento por um caminho próprio.
Para o CIO, o CTO e o CEO, APM traduz tecnologia em indicador de negócio. Tempo de resposta em fluxo crítico, volume de transações concluídas e taxa de erro em fluxo de receita são métricas que o conselho compreende sem tradução técnica.
Para o gerente de infraestrutura, APM evita investimento equivocado. Saber que a lentidão vinha de uma consulta e não de saturação de recurso preserva orçamento de expansão que não resolveria o problema.
Para o profissional de DevOps, APM fecha o ciclo de entrega. Cada implantação passa a ser avaliada por impacto medido em latência e erro, e a regressão aparece enquanto a reversão ainda é simples.
Para o Site Reliability Engineer, ou SRE, APM é a ferramenta de diagnóstico cotidiana. O caminho da métrica anômala ao trace e do trace ao log reduz o tempo médio de resolução, e a análise posterior alimenta melhoria estrutural em vez de correção pontual.
Erros frequentes na adoção de APM
Quatro erros aparecem com regularidade em projetos de APM, e todos são evitáveis com decisão tomada antes da instrumentação.
O primeiro é instrumentar tudo com a mesma profundidade. Cobertura uniforme parece prudente e produz volume que ninguém consulta, com custo de ingestão que cresce sem retorno proporcional. A profundidade deve seguir a criticidade da transação.
O segundo é medir latência por média. A média oculta a cauda de transações lentas, e a cauda é onde estão os usuários que abrem chamado. Painel construído sobre média produz a sensação de saúde que o atendimento contradiz todos os dias.
O terceiro é tratar o nome do serviço como detalhe. Quando cada equipe nomeia o mesmo componente de forma diferente, o painel fragmenta, o alerta perde contexto e a análise causal trabalha com entidades duplicadas. Convenção semântica não é burocracia, é pré-requisito de correlação.
O quarto é ignorar o ponto de contato com sistemas legados. Camada que não propaga contexto gera span órfão, e o trace daquele percurso fica incompleto justamente onde a organização tem menos visibilidade. Esses pontos exigem instrumentação manual deliberada.
Há um padrão comum aos quatro. Todos decorrem de decisões adiadas para depois da instalação, quando corrigi-las já implica reprocessar dado e retrabalhar painel.
Implantar APM em ambiente complexo exige diagnóstico do parque, instrumentação consistente e governança de atributos desde o início. A Rike IS conduz esse trabalho junto das equipes que já operam o ambiente, sem interromper o que está em produção.
Perguntas frequentes
O que é APM?
APM, sigla de Application Performance Monitoring, é a disciplina que mede performance e disponibilidade das aplicações a partir de dentro do código em execução. Cobre latência por transação, taxa de erro, volume de requisições, gargalo em código e impacto de dependências externas.
Qual a diferença entre APM e monitoramento de infraestrutura?
Monitoramento de infraestrutura observa a aplicação por fora, medindo consumo de recurso e resposta de porta. APM observa por dentro, acompanhando a execução do código e reconstruindo o caminho de cada transação de negócio.
Por que o trace se tornou obrigatório em microserviços?
Porque uma única requisição atravessa dezenas de serviços em processos distintos, e nenhum deles tem visão do conjunto. O trace reconstrói o percurso completo e mostra em qual etapa o tempo foi consumido.
O que é span órfão?
Span órfão é uma operação registrada sem ligação com o trace a que pertence. A causa habitual é falha na propagação de contexto, quando alguma camada não repassa os cabeçalhos do W3C Trace Context entre serviços.
APM substitui observabilidade full-stack?
Não. APM é uma das cinco capacidades essenciais, ao lado de monitoramento de infraestrutura e cloud, Digital Experience Monitoring, AIOps e compliance e governança de performance. O valor cresce quando todas operam sobre o mesmo conjunto correlacionado de dados.
Medir performance de aplicação ponta a ponta em sistemas críticos exige instrumentação consistente, convenção de atributos acordada entre times e trace íntegro nos pontos de contato com sistemas legados. A Rike IS oferece consultoria, implantação, treinamento e governança de performance continuada sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações