Monitoramento de aplicações Java liga as métricas internas da JVM à transação que o usuário percebe: ocupação de heap, ciclo de garbage collection, estado das threads e saturação de pool de conexão. A pausa de coleta que congela a aplicação não aparece em nenhum painel de infraestrutura, e é o trace que liga o indicador interno à operação de negócio degradada.
O host aparece saudável, o processo aparece vivo, e a transação demora porque uma pausa de coleta congelou a aplicação por um intervalo que nenhum painel de infraestrutura registrou. Monitorar Java sem visibilidade da máquina virtual produz diagnóstico errado com frequência.
Monitoramento de aplicações Java é a prática de observar o comportamento do código em execução dentro da JVM e ligar cada indicador interno à transação de negócio que o usuário executou. O escopo cobre ocupação de heap, ciclo de garbage collection, estado das threads, saturação de pool de conexão e tempo de resposta por operação.
A particularidade do ambiente Java está na camada intermediária. O código não conversa direto com o sistema operacional, porque a máquina virtual gerencia memória, agenda threads, compila trechos quentes para código nativo e decide sozinha quando recuperar objetos sem referência. Nenhuma métrica de host descreve essas decisões.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
O que observar na Java Virtual Machine
A JVM expõe quatro famílias de indicadores que merecem acompanhamento contínuo em sistemas críticos. Cada família responde a uma pergunta distinta sobre o estado do processo, e nenhuma delas substitui as outras três.
A primeira é a memória gerenciada. O heap é a região onde a máquina virtual aloca os objetos criados pela aplicação, e ele se divide em gerações. Objetos recém-criados nascem na geração jovem, e os que sobrevivem a coletas sucessivas migram para a geração antiga. Fora do heap existem áreas próprias, entre elas o metaspace, que guarda os metadados das classes carregadas.
A segunda é a atividade de coleta de lixo, tratada na seção seguinte.
A terceira família é o estado das threads. Uma thread é a unidade de execução dentro do processo Java, e a aplicação típica mantém muitas delas em paralelo. O indicador relevante não é a contagem total, e sim a distribuição por estado: quantas executam, quantas esperam bloqueio de outro trecho de código e quantas aguardam resposta de um recurso externo.
A quarta é o carregamento de classes. Crescimento contínuo do número de classes carregadas, sem estabilização depois do aquecimento, aponta para geração dinâmica de código ou para carregadores de classe que a máquina virtual nunca libera.
Duas leituras dessa lista costumam surpreender a equipe de operações quando a instrumentação chega a um ambiente já em produção. A primeira é o metaspace, que quase ninguém coleta e que responde por parte das indisponibilidades atribuídas a heap. A segunda é a distância entre os parâmetros de memória que a documentação interna descreve e os que o processo realmente subiu, visíveis nos argumentos da máquina virtual em execução. Sistemas críticos que atravessaram várias gerações de equipe apresentam essa divergência com frequência.
Para o Site Reliability Engineer, ou SRE, essas quatro famílias formam a primeira tela do plantão, porque separam em minutos um problema de memória de um problema de concorrência. Para o gerente de infraestrutura, elas orientam previsão de capacidade com base no consumo real do processo, em vez de dimensionar servidor pelo pico observado no sistema operacional.
Garbage collection e o custo da pausa
Garbage collection, ou GC, é o mecanismo pelo qual a máquina virtual identifica objetos que nenhuma parte do programa alcança e devolve essa memória para reuso. A aplicação Java não libera memória manualmente, e essa comodidade transfere para a JVM uma decisão com efeito direto no tempo de resposta.
Coletar custa processador e, em parte do ciclo, custa parada. Durante certas fases, a máquina virtual precisa suspender as threads da aplicação para trabalhar sobre um estado consistente da memória. Esse intervalo aparece para o usuário como lentidão sem causa aparente, porque o código não estava executando nada, apenas esperando a coleta terminar.
Três indicadores descrevem a saúde da coleta. A frequência mostra de quanto em quanto tempo cada tipo de coleta acontece. A duração mostra quanto tempo a aplicação ficou suspensa em cada evento. A proporção do tempo total gasto em coleta mostra quanto do processador foi consumido por gerenciamento de memória em vez de trabalho útil.
Não existe valor universal de pausa aceitável. O limite razoável nasce do Service Level Objective, ou SLO, o objetivo de nível de serviço acordado para a aplicação. Uma pausa tolerável em processamento em lote noturno pode ser inaceitável em uma consulta de saldo, e a comparação vale contra a meta acordada da própria aplicação, nunca contra um valor de referência genérico.
O sinal que exige investigação imediata é a mudança de padrão. Coleta que antes ocorria em intervalos regulares e passa a ocorrer em sequência, com duração crescente, indica que a aplicação já não consegue recuperar memória suficiente em cada ciclo.
Duas decisões de campo separam quem investiga coleta de quem adivinha. A primeira é manter o registro dos eventos de coleta ligado o tempo todo, em vez de habilitá-lo depois do incidente, quando a evidência do episódio já passou. A segunda é ler a distribuição das pausas por percentil, em vez da média, porque a média dilui justamente o evento que estourou a meta. Em plantão de sistema crítico, a leitura por média é o hábito que mais adia o diagnóstico.
Para a equipe de DevOps, o valor prático aparece na comparação entre versões. Quando o comportamento de coleta muda logo após uma implantação, a evidência aponta para a alteração recém-entregue, e a reversão acontece enquanto ainda é barata.
Memória e vazamento em Java
Vazamento de memória em Java tem definição própria, diferente da que vale em linguagens sem coletor. O objeto não escapou do controle do programa: alguma estrutura ainda mantém referência a ele, o coletor entende que a memória está em uso e não a recupera. O resultado é heap que cresce e nunca retorna ao patamar anterior.
A assinatura desse comportamento é reconhecível em um gráfico de ocupação ao longo do tempo. Em aplicação saudável, o uso de heap sobe entre coletas e cai após cada uma, formando um traçado em serra com base estável. Em aplicação com vazamento, a base sobe a cada ciclo, e o traçado inteiro se desloca para cima até a memória se esgotar. O desfecho costuma ser a exceção de memória insuficiente, precedida por um período em que a aplicação passa quase todo o tempo coletando sem liberar espaço.
Isolar a origem exige mais do que o gráfico. É preciso saber quais classes ocupam a memória retida e qual caminho de referências impede a liberação. Essa informação vem da análise do conteúdo do heap, o heap dump, que a equipe de operações solicita sob demanda ou que o agente captura quando o consumo atinge um limite configurado.
Três origens respondem pela maioria dos casos observados em produção. Coleções estáticas que recebem elementos e nunca os removem. Caches sem política de expiração nem limite de tamanho. Escutadores de evento e conexões que alguém registra e ninguém cancela quando o componente que os criou sai de cena.
O sinal mais confiável de vazamento não diagnosticado não está em gráfico nenhum. Ele está na rotina de reinício programado que a operação já normalizou: quando a equipe derruba o processo em janela fixa para liberar memória, o defeito existe e ninguém o classificou como defeito.
Capturar o heap dump depois desse reinício descarta a única evidência que fecharia o caso, porque o processo novo começa com a memória limpa. A ordem correta é capturar antes de reiniciar, mesmo com o incidente aberto e a pressão para restabelecer o serviço.
Para o CIO, o CTO e o CEO, o efeito relevante do vazamento não é técnico, e sim de previsibilidade. Aplicação com vazamento produz indisponibilidade em horário imprevisível, muitas vezes no pico de uso, e transfere para a operação uma rotina de reinício programado que mascara o defeito em vez de resolvê-lo.
Pool de conexão e recursos compartilhados
Pool de conexão é o conjunto limitado de conexões abertas que a aplicação mantém prontas para uso, em geral contra banco de dados, e que as threads pegam emprestado durante uma operação, devolvendo ao final. O limite existe por decisão de projeto, porque cada conexão consome recurso no cliente e no servidor.
O limite do pool é também o ponto onde a aplicação para primeiro.
Quando o banco de dados responde mais devagar, cada thread segura a conexão por mais tempo. O pool esvazia, novas requisições entram em fila esperando conexão livre, e a aplicação inteira passa a responder mal, inclusive nas operações que não dependiam daquele banco. A causa raiz está na dependência lenta, e o sintoma aparece em toda a aplicação.
Quatro indicadores tornam esse mecanismo visível antes do esgotamento: conexões ativas contra o tamanho máximo, tempo médio de espera por uma conexão livre, tempo que cada conexão permanece emprestada e número de requisições em fila.
O mesmo raciocínio vale para qualquer recurso compartilhado com limite. Pool de threads de servidor de aplicação, semáforo de controle de concorrência, fila interna de trabalho. Todos exibem o mesmo padrão de saturação silenciosa, em que a métrica de infraestrutura permanece confortável enquanto a aplicação já enfileira trabalho.
Existe um erro de reação recorrente diante desse quadro. Ampliar o pool sem investigar a lentidão da dependência transfere a fila para o banco de dados, que passa a receber mais conexões simultâneas do que consegue atender, e o tempo de resposta piora em vez de melhorar.
O número configurado no console do servidor de aplicação raramente é o número que o processo realmente abre. Frameworks de acesso a dados criam pools próprios, e cada fonte de dados adicional soma conexões que ninguém somou na conta original. O inventário verdadeiro aparece quando alguém observa as conexões que o processo mantém abertas em execução, em vez de ler o arquivo de configuração. Em ambiente que cresceu por integrações sucessivas, essa contagem quase sempre desmente a documentação interna.
Quem chega a esse ponto do diagnóstico costuma já ter ampliado o pool sem resultado. A conversa que destrava o quadro começa pelo mapa de dependências, e não pela configuração: qual chamada ficou lenta, desde quando, e o que mudou no intervalo. A Rike IS acompanha equipe de operações e desenvolvimento nessa etapa.
Da JVM à transação do usuário
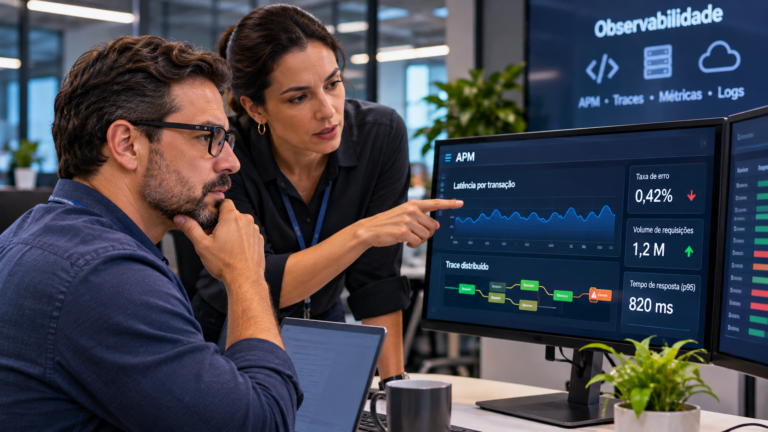
A métrica interna só vira decisão quando alguém consegue responder a uma pergunta simples: qual operação de negócio ficou pior por causa disso. É essa ligação que separa monitoramento de máquina virtual de Application Performance Monitoring, ou APM, a disciplina que mede a performance a partir de dentro do código em execução.
A ponte entre as duas camadas é o trace, o registro do percurso completo de uma requisição. O trace é o GPS de uma viagem, mostrando cada parada do trajeto e onde o tempo foi consumido, e cada etapa individual é um span, com marcas de tempo e atributos próprios.
Em uma aplicação Java, esse percurso atravessa camadas bem definidas. Entrada pelo contêiner de servlet ou pelo framework web, execução do método de negócio, chamada ao repositório de dados, empréstimo de conexão do pool, consulta ao banco, serialização da resposta.
Quando cada etapa carrega tempo próprio, a análise deixa de ser inferência. Uma transação lenta com tempo concentrado na espera por conexão indica saturação de pool. A mesma transação lenta com tempo distribuído por igual entre todas as etapas indica pausa de coleta atingindo o processo inteiro.
A correlação com o evento de garbage collection é o que fecha o raciocínio. Se as transações degradadas coincidem no tempo com pausas longas de coleta, o percentil de latência não tem causa em nenhum trecho específico do código, e sim no gerenciamento de memória do processo.
Na plataforma Dynatrace, o Davis, que dentro do Dynatrace Intelligence é responsável pela análise causal, executa essa correlação. É Artificial Intelligence for IT Operations, ou AIOps, aplicada ao processo Java. A IA causal atua na identificação da causa e do contexto do problema, enquanto os dashboards organizam e tornam exploráveis os sinais operacionais.
O que o navegador ou o aplicativo do usuário percebe pertence a Digital Experience Monitoring, ou DEM, camada vizinha que começa onde a transação sai do servidor Java.
Instrumentação automática e manual em Java
Java é a linguagem em que a instrumentação automática alcança maior profundidade, e o motivo é técnico. A máquina virtual expõe uma interface de agente que permite modificar o código das classes no momento do carregamento, sem alterar o código-fonte e sem recompilação.
O OneAgent, agente unificado da plataforma Dynatrace, usa esse mecanismo. Uma única instalação no host ou no contêiner descobre os processos Java em execução e identifica frameworks web, clientes de banco, bibliotecas de mensageria e clientes de chamada remota, passando a registrar a entrada e a saída de cada um desses pontos.
O resultado é cobertura ampla sem esforço por serviço. Métricas de máquina virtual, eventos de coleta, estado de pool, consultas executadas e traces distribuídos aparecem correlacionados desde a primeira execução, e a propagação de contexto entre serviços Java acontece sem configuração manual em cada ponto de entrada.
A instrumentação manual continua tendo lugar, em três situações concretas. A primeira é o código de negócio proprietário, que o agente enxerga como método sem nome de negócio, e marcar explicitamente a operação dá ao trace o vocabulário do domínio, com identificador de pedido ou tipo de contrato como atributo. A segunda é o atributo de negócio que precisa acompanhar a requisição inteira, como canal de origem ou segmento do cliente. A terceira é o ponto de integração com sistema legado que não propaga contexto, onde a instrumentação deliberada evita o span órfão.
A escolha do padrão de instrumentação manual acontece entre a interface própria do agente e o OpenTelemetry, padrão aberto e vendor-neutral da CNCF que funciona como o padrão USB-C da telemetria. A mesma plataforma ingere os dois.
Para a equipe de DevOps, a diferença prática está no custo de manutenção. Cobertura automática sobrevive a mudança de framework e a nova versão de biblioteca, enquanto instrumentação manual precisa ser revisada a cada refatoração do código que a contém.
Por onde começar em uma aplicação já em produção
Aplicação Java em produção com problema de performance raramente permite parar tudo e instrumentar do zero. A sequência que funciona nesse cenário tem três decisões, nesta ordem.
A primeira decisão é obter cobertura ampla antes de escolher o que aprofundar. Instalar o agente no ambiente e deixar a descoberta automática mapear processos, frameworks e dependências produz, em pouco tempo, o inventário real do que está em execução. Esse inventário quase sempre difere do que a documentação interna descreve.
A segunda decisão é eleger as transações de negócio que importam. Nem toda operação merece o mesmo nível de detalhe, e tentar instrumentar tudo com a mesma profundidade gera volume que ninguém consulta, com custo de ingestão crescendo sem retorno equivalente. A criticidade da transação define a profundidade.
A terceira decisão é definir o vocabulário antes de ampliar a cobertura. Nome de serviço, nome de aplicação e atributos de negócio precisam seguir convenção única, porque painel, alerta e análise causal dependem desses nomes para agrupar dados que pertencem ao mesmo componente.
Governança de performance em Java se sustenta quando essas três decisões precedem a escala.
Para o CIO, o CTO e o CEO, o retorno dessa ordem aparece em previsibilidade. A indisponibilidade que antes surgia sem aviso passa a ter sinal antecedente conhecido, com tempo de reação antes do impacto no cliente. Para o gerente de infraestrutura, o mesmo trabalho transforma dimensionamento em decisão baseada em consumo medido do processo, em vez de margem de segurança arbitrária.
Perguntas frequentes
É preciso reiniciar a aplicação Java para começar a monitorar?
Sim, na maioria dos casos. A instrumentação por agente atua no momento em que a máquina virtual carrega as classes, e um processo já em execução carregou as suas antes da chegada do agente. O reinício do processo Java entra no planejamento da implantação como janela acordada, não como surpresa. Métricas de host e de contêiner aparecem antes disso, mas o detalhe de código e o trace só começam no processo reiniciado.
Qual a diferença entre vazamento de memória e heap subdimensionado?
O heap subdimensionado sustenta a aplicação, mas com folga pequena: a ocupação sobe, a coleta recupera espaço e a base retorna ao mesmo patamar, apenas com coletas mais frequentes do que o desejável. No vazamento, a base sobe a cada ciclo e nunca retorna, e nenhum aumento de heap resolve, apenas adia. A distinção prática está no comportamento após a coleta completa, e confundir as duas leva a ampliar memória em um defeito que só cresce mais devagar.
Monitorar a JVM por Java Management Extensions substitui o agente?
Java Management Extensions, ou JMX, é a interface nativa da máquina virtual para expor indicadores de gerenciamento, e entrega bem heap, threads e contadores de coleta. O que ela não entrega é o percurso da requisição: JMX descreve o estado do processo, não a transação que atravessou o processo. Ambiente que só coleta JMX enxerga a JVM doente sem saber qual operação de negócio ficou pior por causa disso.
A instrumentação automática pesa na aplicação Java em produção?
Existe custo, e ele é pequeno diante do custo de diagnosticar sem dado. O ponto que merece atenção não é o agente em si, e sim a instrumentação manual acrescentada sem critério, que cria atributos de alta cardinality e trace em profundidade excessiva. O ajuste correto trabalha a amostragem e a profundidade por criticidade da transação, em vez de desligar a cobertura.
Aplicação Java em contêiner exige ajuste no monitoramento?
Exige atenção a um ponto específico: a máquina virtual precisa enxergar o limite de memória do contêiner para dimensionar o heap, e versões antigas de máquina virtual leem a memória do host, ignorando o limite do contêiner. Quando isso acontece, a JVM dimensiona o heap acima do que o contêiner permite, e o orquestrador encerra o processo por consumo excedido antes que qualquer alerta de aplicação dispare. O sintoma se parece com indisponibilidade sem causa, e a causa raiz está na leitura errada do limite.
Ligar métrica de máquina virtual, comportamento de coleta, saturação de pool e trace de transação em uma leitura única exige diagnóstico, instrumentação consistente e governança de atributos desde o primeiro dia. A Rike IS conduz esse trabalho sobre a plataforma Dynatrace, com consultoria, implantação, treinamento e governança de performance continuada, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o inventário das suas aplicações Java para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações