Gerenciamento de desempenho de aplicações mede latência, tráfego, erros e saturação contra um alvo declarado, e a lentidão cobra em receita antes de aparecer em relatório. O Open Finance Brasil mede o tempo de resposta no percentil 95 diário e define tetos por frequência da API: 1.500 ms para alta e média-alta, 2.000 ms para média e 4.000 ms para baixa.
A lentidão não derruba o sistema. Ela adia o pagamento, alonga a fila do atendimento e faz o cliente desistir sem reclamar. Nada disso dispara alerta, porque nenhum recurso estourou, e é por isso que o custo aparece meses depois, já traduzido em número de negócio.
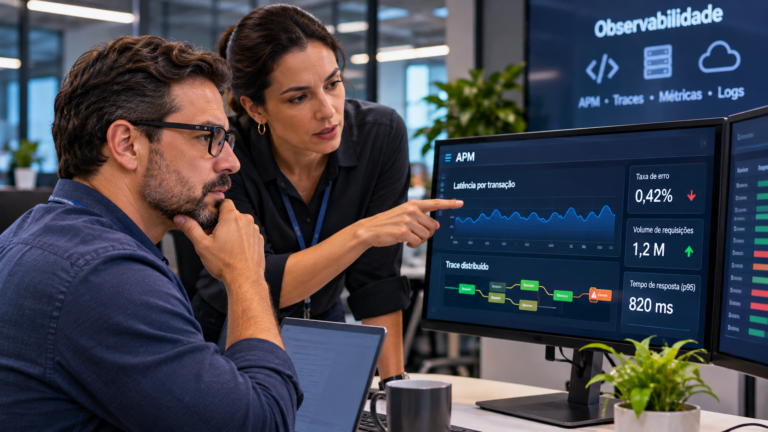
Gerenciamento de desempenho de aplicações, ou Application Performance Monitoring, ou APM, é a disciplina de medir, diagnosticar e sustentar o comportamento de aplicações em produção: tempo de resposta, taxa de erro, tráfego e saturação. A finalidade é manter a experiência do usuário dentro de um alvo declarado, e o mecanismo é a instrumentação, que emite métricas, logs e traces correlacionados por rastreamento distribuído.
O requisito é um alvo numérico definido antes da medição, porque sem objetivo de nível de serviço declarado o gerenciamento de desempenho de aplicações vira coleta de gráfico sem decisão associada. A restrição também importa: o APM mede a aplicação, e não o negócio. Ele mostra o checkout em 4 segundos no percentil 95 sem mostrar quanto isso custou.
O dashboard está verde e o cliente está reclamando
Terça-feira, 14h20. Os chamados sobem e o dashboard de infraestrutura segue dentro do limite. Nenhum alerta disparou, porque todos os limiares falam de recurso, e nenhum recurso estourou. No atendimento, a mensagem que se repete é que está travando na hora de finalizar.
Às 16h, o time de aplicação aponta o banco, o time de banco mostra as consultas dentro da linha de base e o time de rede mostra a latência entre zonas estável. Todos têm razão no próprio recorte, e ninguém tem a jornada inteira.
Monitoramento de infraestrutura responde se o servidor está de pé. Gerenciamento de desempenho de aplicações responde se a jornada do cliente está funcionando. São perguntas diferentes, e a primeira fica verde enquanto a segunda quebra.
O que gerenciamento de desempenho de aplicações não é
Três confusões atrasam essa conversa antes de ela começar. A primeira é confundir APM com monitoramento de infraestrutura: processador e memória no limite descrevem o host, e alerta de recurso não pega degradação de jornada.
A segunda é confundir APM com alerta e dashboard. Quem tem quatrocentos alertas por dia e nenhum alvo declarado produz ruído com carimbo de urgência. A terceira é confundir APM com teste de carga, que mede ambiente controlado antes da publicação, enquanto o APM mede comportamento real durante a operação.
APM e observabilidade: onde termina um e começa o outro
O APM entrega resposta pronta para pergunta conhecida: quais rotas estão mais lentas, quais consultas mais pesam. Observabilidade é a capacidade de formular pergunta nova sobre a telemetria, inclusive a que ninguém previu ao instrumentar.
Gerenciamento de desempenho de aplicações é uma das cinco capacidades essenciais de uma plataforma de observabilidade. As outras quatro são monitoramento de infraestrutura e cloud, Digital Experience Monitoring, ou DEM, AIOps, e compliance e governança de performance. Para o Site Reliability Engineer, ou SRE, em plantão, a distinção define se a pergunta das três da manhã tem resposta imediata ou vira caça a log.
O que o APM mede de verdade: quatro sinais
Gerenciamento de desempenho de aplicações mede quatro sinais em produção, os quatro sinais de ouro. Métricas são o painel do carro.
| Sinal | O que mede | Onde costuma escapar |
|---|---|---|
| Latência | Tempo de resposta lido em percentis, nunca em média | É o que o usuário chama de lentidão, e a média esconde |
| Tráfego | Requisições por segundo, por rota e por transação de negócio | Sem ele, a latência não tem contexto: lento sob que volume |
| Erros | Taxa de erro por tipo de operação | Medida só de forma global, uma funcionalidade quebra sem mover o número agregado |
| Saturação | Processador, memória, filas e pool de conexões | O pool de conexões satura primeiro e é o recurso menos observado |
Por que a média engana e o percentil não
A média é dominada pela maioria bem atendida. Uma média saudável de 780 milissegundos convive com um percentil 99 de 11 segundos na mesma transação, e as duas descrições estão corretas.
O P50 descreve o usuário típico, o P95 expõe a cauda longa e o P99 isola o um por cento pior. É esse um por cento que abre chamado, e ele não é aleatório: consulta lenta pune quem tem o histórico mais longo, ou seja, o cliente mais antigo.
Apdex: transformar tempo de resposta em uma nota só
O Apdex é padrão aberto criado em 2004 pela Apdex Alliance, e a fórmula soma as requisições satisfeitas à metade das toleradas, dividindo pelo total. Satisfeita vai até o limiar T, tolerada de T a 4T, e frustrada acima de 4T ou em erro de servidor.
A nota vai de excelente, a partir de 0,94, a inaceitável, abaixo de 0,50. O teto de 4T pune a cauda de propósito, o que faz do Apdex um índice que conversa melhor com a diretoria do que uma série temporal de latência.
Objetivo de nível de serviço e orçamento de erro
O Service Level Indicator, ou SLI, é o número medido, e o Service Level Objective, ou SLO, é o alvo contra o qual esse número é lido. O orçamento de erro é o que sobra: 100% menos o SLO, expresso em tempo.
Um SLO de 99,9% de disponibilidade mensal equivale a aproximadamente 43 minutos de indisponibilidade tolerada por mês. Quando o orçamento de erro se esgota, a prioridade da equipe muda de entrega para confiabilidade. É essa regra que faz o número virar decisão, em vez de virar gráfico.
Quanto a lentidão custa em receita real
No estudo Milliseconds Make Millions, encomendado pelo Google e conduzido por 55 e Deloitte, uma melhoria de 0,1 segundo elevou a conversão em 8,4% no varejo e em 10,1% em viagens. O mesmo estudo, aplicado a 37 sites e mais de 30 milhões de sessões, registrou 40,1% de aumento na progressão para o carrinho no setor de luxo.
A ressalva é parte do dado. A medição é de funil de compra digital, em marcas europeias e americanas, feita em 2019. Ela ilustra a ordem de grandeza do problema, e não é constante universal. Esses números não se transpõem a portal de tributos, a core bancário nem a plataforma de cooperativa.
Onde o custo aparece quando não há venda no fim da jornada
Em sistemas críticos, o custo da lentidão raramente aparece como queda de conversão, e sim como fila de atendimento, chamado aberto e capacidade comprada por precaução.
Em órgãos públicos, um sistema de saúde que degrada em campanha de vacinação gera fila presencial antes de gerar planilha. Em instituições financeiras, o custo é regulatório, e a moeda é a trilha auditável. Em cooperativas, provar que a experiência é igual na capital e na praça pequena exige medição regionalizada. Em empresas privadas de grande porte, o custo é competitivo: entrega rápida que degrada a jornada sem ninguém perceber.
Para o gerente de infraestrutura, existe uma quinta forma de custo, mais silenciosa. Ambiente sem alvo declarado compra capacidade por precaução, porque ninguém sabe dizer quanto é suficiente, e a fatura cresce sem que nenhuma decisão explique o crescimento.
Quando o backend está saudável e o usuário não
Os Core Web Vitals do Google fixam três limiares, medidos no percentil 75 das sessões.
| Métrica | O que mede | Limiar |
|---|---|---|
| LCP | Maior elemento de conteúdo renderizado | Até 2,5 segundos |
| INP | Resposta a todas as interações da sessão | Até 200 milissegundos |
| CLS | Deslocamento visual acumulado do layout | Até 0,1 |
O INP substituiu o FID como métrica oficial de interatividade em 12 de março de 2024. Um percentil 95 de backend dentro do alvo convivendo com INP acima de 200 milissegundos tem leitura única: a lentidão está depois do servidor e antes do olho do usuário, e o APM que só instrumenta backend nunca enxerga isso. É por aí que o monitoramento de experiência digital deixa de ser acessório.
Como o APM encontra a causa raiz
Uma solução de gerenciamento de desempenho de aplicações tem cinco componentes: instrumentação, coleta, correlação, análise e ação. Os quatro primeiros só valem pelo quinto.
Descoberta automática e mapa de dependências
Instrumentação são as câmeras instaladas na fábrica. O OneAgent descobre sozinho a stack de um host, contêiner ou ambiente cloud, incluindo linguagens, frameworks, bancos e filas, sem configuração por componente.
O Smartscape é a representação visual e dinâmica de todas as dependências do ambiente, atualizada em tempo real. Para o arquiteto, é registro de território que a documentação nunca acompanhou. Para o SRE em plantão, é o atalho que mostra o caminho do impacto.
Trace, span e a viagem de uma transação
Um span é a unidade de trabalho de um serviço, com início, fim e atributos. O trace é o conjunto de spans de uma mesma requisição, o GPS de uma viagem, mostrando cada parada do trajeto. A propagação de contexto é o carimbo no passaporte, materializada nos cabeçalhos traceparent e tracestate.
É o trace que permite falar em pagamento, em vez de falar na rota que executa o pagamento. Em ambiente legado, a propagação falha e o rastro chega incompleto, gerando span órfão. A resposta é instrumentação manual nos pontos de fronteira, somada à automática onde ela é possível.
Correlação não é o mesmo que causa
Correlação temporal aponta o que aconteceu junto, e a análise causal usa o mapa de dependências para apontar o que causou o quê e indicar as transações afetadas. O Davis é o motor de inteligência artificial causal que faz esse trabalho na plataforma Dynatrace.
Os dashboards permitem explorar métricas, traces e contexto de negócio, enquanto a Dynatrace Intelligence acrescenta detecção, correlação e análise causal para acelerar a identificação da origem da lentidão. O tempo médio de resolução é o indicador que mede essa distância, porque a etapa mais lenta de um incidente não é perceber, é entender.
No Brasil, desempenho de aplicação já é obrigação com número
No ecossistema do Open Finance Brasil, a disponibilidade exigida é de 95% a cada 24 horas e de 99,5% a cada 3 meses, com a indisponibilidade calculada sobre uma janela de 86.400 segundos. O tempo de resposta das APIs é medido no percentil 95 diário, com teto por faixa de frequência.
| Frequência da API | Teto de tempo de resposta no percentil 95 |
|---|---|
| Alta e média-alta | 1.500 milissegundos |
| Média | 2.000 milissegundos |
| Baixa | 4.000 milissegundos |
A consequência é direta: percentil não é preferência de time técnico, é unidade de medida regulada. A Resolução Conjunta nº 1, de 4 de maio de 2020, do Banco Central, exige que a política de riscos trate de indisponibilidade de interfaces e de prazos de restabelecimento, além de testes de continuidade com reporte de indicadores de desempenho.
Em órgãos públicos, a Lei nº 14.129/2021 estabelece princípios e regras da prestação digital de serviços públicos, e não fixa percentual de disponibilidade. Prestação digital virou dever legal, e dever legal sem medição é promessa.
Telemetria carrega dado, dado pessoal em atributo de trace é risco sob a LGPD, e a governança de atributos passa a ser também controle de privacidade, e não apenas de comparabilidade.
Por que a conta do monitoramento cresce sozinha
Quem já operou plataforma de observabilidade em escala tem cicatriz de fatura. O custo é função direta do volume ingerido, e o volume cresce por decisões silenciosas, tomadas por quem instrumenta e nunca revisadas por quem paga.
A padronização deixou de ser o obstáculo. A CNCF anunciou a graduação do OpenTelemetry em 21 de maio de 2026, com mais de 12.000 contribuidores de mais de 2.800 empresas. A pergunta de 2026 não é mais se instrumentar com padrão aberto, e sim o que fazer com o volume depois.
Cardinality explosion: o multiplicador invisível
Identificadores únicos por requisição no caminho da chamada, como identificador de usuário ou de sessão, transformam uma rota em centenas de operações distintas. A plataforma Dynatrace limita métricas quando as operações distintas ultrapassam 500 por padrão.
O erro gêmeo é mais silencioso. Atributo fora da convenção semântica, como app.name em vez de service.name, produz dado que existe e não correlaciona. A configuração do Collector e a governança de atributos são o controle que impede esse desperdício, e as duas precisam estar decididas antes da primeira coleta.
Sampling: observar parte para inferir o todo
Sampling é a pesquisa eleitoral, e dois comportamentos se separam aqui. O sampling head-based decide na criação do trace, por percentual aleatório, e os traces com erro ou latência anômala são bem mais raros que esse percentual. São justamente eles que se perdem.
O sampling tail-based decide depois de coletar os spans, o que preserva erro e latência. A restrição é real: todos os spans de um trace precisam chegar à mesma instância do Collector, o que exige balanceamento com consciência de trace. Em sistemas críticos, o sampling tail-based é geralmente preferido.
Retenção: quanto tempo o dado precisa sobreviver
O Grail retém logs, métricas, traces e eventos em volume massivo e por longos períodos, com consulta rápida sobre todo o histórico. A consulta exploratória desses dados é feita no Dynatrace Query Language, ou DQL. Para uma instituição financeira, é isso que responde a pergunta sobre um dia específico, meses depois, sem esforço de arqueologia.
Como implantar sem parar a operação
A sequência realista tem quatro passos. O primeiro é o diagnóstico do ambiente e da maturidade de observabilidade. O segundo é a definição do alvo, com objetivo de nível de serviço por transação de negócio, em vez de por servidor. O terceiro é a instrumentação na primeira onda, cobrindo o caminho crítico de receita ou de serviço. O quarto é a expansão nas ondas seguintes.
A implantação em ondas responde a um medo legítimo, porque quem já viu projeto de monitoramento virar mais um dashboard que ninguém olha desconfia de cronograma longo sem entrega. A primeira onda cobre a jornada de maior impacto: pagamento, emissão, login ou consulta de benefício. Para o profissional DevOps, isso significa retorno sobre a implantação em minutos e reversão decidida com evidência.
Agente, padrão aberto ou modelo híbrido
Existem três abordagens de instrumentação, e a escolha depende do parque. A instrumentação automática por OneAgent cobre a stack inteira sem configuração por componente, com o menor esforço de manutenção, e é a escolha certa onde existe permissão para instalar agente.
A instrumentação por OpenTelemetry segue o padrão aberto e vendor-neutral da CNCF, o padrão USB-C da telemetria. O OTLP é o envelope dos correios, com duas portas: gRPC na 4317, mais eficiente em volume, e HTTP com protobuf na 4318, mais simples de atravessar firewall.
O modelo híbrido combina os dois e é o adotado pela Rike IS na maior parte dos projetos: agente onde é possível instalar, padrão aberto onde não é. Para parque legado, essa deixa de ser preferência e vira a única arquitetura realista, e o critério de divisão é o inventário real de cargas, não a preferência da equipe.
De número técnico a frase de conselho de administração
Dizer que o percentil 95 do checkout subiu de 900 milissegundos para 2,4 segundos às terças não move um conselho de administração. Dizer que a organização consumiu 60% do orçamento de erro do trimestre em duas semanas, na jornada que responde pela maior parte da receita, move.
A diferença não é retórica. A segunda frase só existe quando há objetivo de nível de serviço por transação de negócio, orçamento de erro acompanhado e causa atribuída. Sem os três, o CIO, o CTO e o CEO recebem um número filtrado por quatro camadas de tradução.
Perguntas frequentes sobre gerenciamento de desempenho de aplicações
Qual percentil usar para medir latência: P95 ou P99?
Os dois, com finalidades diferentes. O P95 serve de alvo contratual, porque é estável o suficiente para virar objetivo de nível de serviço, e é o percentil que o Open Finance Brasil adota. O P99 serve de sinal de investigação, porque isola a cauda que abre chamado e costuma revelar consulta lenta ou pool de conexões saturado.
Qual objetivo de nível de serviço adotar para uma aplicação crítica?
Não existe número universal, e copiar o 99,9% alheio é o erro mais comum. O alvo nasce do impacto da indisponibilidade sobre a jornada e do que a operação consegue sustentar. Um SLO alto demais consome o time em confiabilidade e trava a entrega, e um SLO baixo demais nunca aciona decisão nenhuma.
Gerenciamento de desempenho de aplicações funciona em sistema legado?
Funciona, com profundidade variável por camada. Onde a tecnologia é coberta pelo agente, o registro desce ao nível da transação. Onde não é, a instrumentação manual nos pontos de fronteira preserva a propagação de contexto e evita o span órfão, que é o que quebra o trace em ambiente heterogêneo.
O APM substitui o monitoramento de infraestrutura?
Não. As duas camadas respondem a perguntas diferentes e são complementares dentro da mesma plataforma. Infraestrutura responde se o recurso está disponível, e o APM responde se a jornada está funcionando. O que muda é a ordem de leitura: o alerta de recurso deixa de ser o gatilho principal e passa a ser contexto do diagnóstico.
Como estimar o custo de ingestão antes de instrumentar?
Pelo inventário de cargas e pelas três decisões que definem volume: quais atributos entram, qual política de sampling se aplica e por quanto tempo cada tipo de dado é retido. Estimativa feita sem essas três respostas erra por ordem de grandeza, porque cardinality explosion multiplica séries sem aviso.
Medir tempo de resposta é a parte que a plataforma resolve. Decidir o que medir, por quanto tempo guardar e contra qual alvo comparar depende de experiência de campo, e se refaz sempre que o ambiente muda. A Rike IS trabalha exatamente aí, com consultoria, implantação em ondas, treinamento por perfil profissional e governança de performance continuada em observabilidade sobre a plataforma Dynatrace, junto a órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. O que essa combinação persegue é redução expressiva do tempo médio de resolução.
Os dados de impacto de latência citados são de estudo público de terceiros, identificado no texto, e referem-se aos contextos medidos naquele estudo. Não constituem projeção de resultado.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações