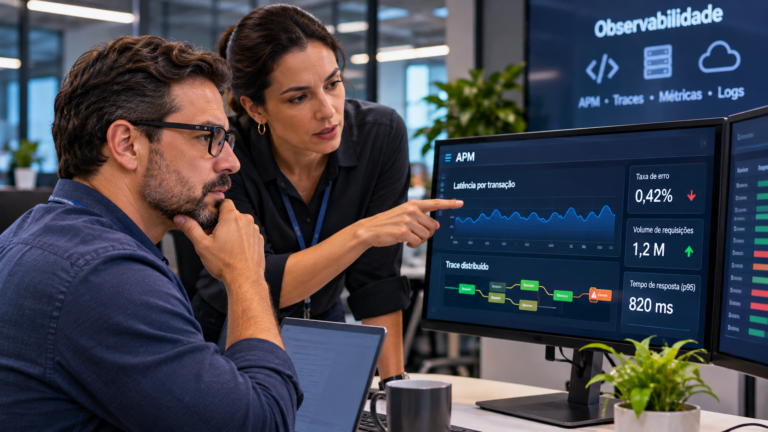
APM, sigla de Application Performance Monitoring, é o monitoramento de aplicação feito de dentro do código em execução. A unidade de análise é a transação de negócio, do pedido do usuário até a resposta, com o tempo separado entre código próprio e dependência externa. Em arquitetura distribuída, o trace é o que liga o percurso entre serviços.
Um cidadão emite uma guia de pagamento no portal de um órgão público, e essa emissão atravessa o código da aplicação, uma consulta ao banco de dados, uma fila de processamento e a chamada a um serviço externo de validação. O APM registra quanto tempo cada etapa consumiu, em qual delas o tempo se acumulou e onde a operação falhou. Nenhuma dessas informações aparece olhando apenas o consumo de memória do servidor.
APM é a prática de monitoramento de aplicação que mede o comportamento do software a partir de dentro do código em execução. O objeto observado é a aplicação, não a máquina que a hospeda. A medida é de performance: tempo de resposta, taxa de erro e caminho percorrido por cada requisição. O regime é de observação contínua, em produção, com o sistema atendendo usuários reais.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
APM: o que a sigla significa por extenso
Application Performance Monitoring reúne três termos, e cada um carrega uma decisão de escopo.
Application é a aplicação: o software que executa a regra de negócio e responde ao usuário. Um portal de emissão de documentos, um internet banking, um sistema de liquidação de operações e um aplicativo de cooperativa são aplicações. O servidor, o contêiner e a rede sustentam a aplicação, sem serem a aplicação.
Performance é o comportamento medido sob carga real. Tempo de resposta por operação, taxa de erro, volume de requisições atendidas e uso de recurso durante a execução compõem essa leitura.
Monitoring é a observação contínua e automática, com o sistema em produção. Inspeção pontual em ambiente de teste responde se o software funciona, enquanto monitoramento de aplicação responde como o software se comporta sob carga de fim de mês, com muita gente no sistema ao mesmo tempo e o banco de dados sob concorrência. As duas perguntas são diferentes, e apenas a segunda protege sistemas críticos.
Para o CIO, o CTO e o CEO, a delimitação entre aplicação e máquina tem consequência direta de risco. Investir em capacidade de servidor sem enxergar o comportamento da aplicação compra estabilidade aparente e deixa o problema real intocado, porque o problema real vive dentro do código que ninguém está medindo.
O que o APM observa dentro da aplicação
A unidade de análise do APM é a transação, e essa escolha define tudo o que vem depois.
Transação, no vocabulário de monitoramento de aplicação, é uma operação de negócio completa, do pedido do usuário até a resposta devolvida. Emitir uma guia, consultar um saldo, autorizar um pagamento e enviar um formulário são transações. A transação não é um comando de banco de dados nem uma linha de código isolada: é o percurso inteiro que entrega valor a quem está do outro lado da tela.
Dentro de cada transação, o APM registra três medidas em ordem de granularidade crescente. A primeira é o tempo total da operação, do pedido à resposta. Depois vem o tempo consumido por cada método executado no código próprio. Por último, entra o tempo de cada chamada que sai da aplicação em direção a outro sistema.
A terceira camada merece atenção própria. Dependência externa é qualquer serviço que a aplicação chama e não controla: um provedor de autenticação, uma interface de consulta a órgão regulador, um gateway de pagamento, uma fila gerenciada por terceiro. Quando uma dependência externa fica lenta, o sintoma aparece na aplicação de quem chamou. O usuário reclama do portal, o chamado chega para a equipe de operações interna e o indicador de disponibilidade cobrado em contrato é o da organização, não o do fornecedor.
O APM separa o tempo gasto no código próprio do tempo gasto esperando terceiros, e a equipe deixa de discutir percepção para acionar o fornecedor com evidência de tempo de resposta medido.
Para o Site Reliability Engineer, ou SRE, que investiga um incidente em plantão, essa separação corta a parte mais cara do trabalho: a fase de descobrir onde procurar. Para o gerente de infraestrutura, a mesma separação evita expandir capacidade de um ambiente que já estava saudável.
APM e monitoramento de servidor
Confundir monitoramento de aplicação com monitoramento de servidor é o erro mais comum de quem encontra a sigla pela primeira vez, e desfazer essa confusão explica por que as duas práticas coexistem.
Monitoramento de servidor observa a máquina: uso de processador, memória ocupada, espaço em disco, tráfego de rede, processo vivo ou morto, porta respondendo ou não. Essa leitura é necessária e continua sendo, porque um disco cheio derruba qualquer aplicação, por melhor que o código esteja escrito.
Monitoramento de aplicação observa o que a máquina está executando.
A diferença fica visível em um cenário que se repete em operação crítica. Todos os indicadores de servidor aparecem normais: processador em uso moderado, memória com folga, rede sem perda de pacote, processo ativo. Ao mesmo tempo, a central de atendimento registra reclamações de lentidão na emissão de boletos. O monitoramento de servidor não tem nada a informar, porque o servidor está mesmo saudável.
O APM tem. Uma consulta ao banco de dados que antes respondia de imediato passou a demorar, depois que uma tabela cresceu e o índice deixou de cobrir a busca. A transação de emissão de boleto degradou, as demais transações do mesmo servidor seguiram normais, e por isso nenhuma média de infraestrutura acusou a mudança.
Existe uma formulação curta para guardar a distinção. Monitoramento de servidor responde se o ambiente está de pé, e monitoramento de aplicação responde se o negócio está funcionando.
Para o profissional de DevOps, a distinção muda o critério de aceite de uma entrega. Uma implantação que não alterou nenhum indicador de infraestrutura pode ter dobrado o tempo de uma operação de negócio, e apenas o monitoramento de aplicação mostra essa degradação a tempo de reverter a versão com custo baixo.
Como o APM coleta os dados
A coleta acontece por instrumentação, que é o ato de inserir pontos de medição na execução do software. Instrumentação são as câmeras instaladas na fábrica: elas não mudam a linha de produção, mostram o que acontece em cada posto.
Existem duas vias de instrumentação, e a escolha entre elas responde à pergunta mais frequente de quem começa: APM precisa de agente?
A primeira via é o agente, um componente instalado no ambiente de execução, junto da aplicação, que descobre automaticamente o que está rodando ali e passa a medir sem alteração de código. Na plataforma Dynatrace, o OneAgent cumpre esse papel: um agente unificado que faz a descoberta automática da stack no host, no contêiner ou no ambiente de nuvem.
A segunda via é a instrumentação manual por bibliotecas no código. A equipe de desenvolvimento adiciona chamadas explícitas que marcam o início e o fim de operações escolhidas. O padrão aberto para essa via é o OpenTelemetry, padrão vendor-neutral da CNCF que funciona como o padrão USB-C da telemetria. A instrumentação manual alcança trechos que o agente não enxerga, como uma regra de negócio proprietária, ao custo de trabalho de desenvolvimento e de manutenção contínua.
A resposta honesta à pergunta sobre agente tem duas partes. O agente não é obrigatório do ponto de vista técnico, porque instrumentação manual coleta dados sem ele. O agente é o caminho de menor esforço em ambientes grandes e heterogêneos, porque a descoberta automática cobre em uma instalação o que a instrumentação manual cobriria em um esforço longo, componente por componente.
A escolha entre agente, OpenTelemetry ou modelo híbrido depende do ambiente, e o híbrido é o arranjo mais comum em organizações com sistemas legados: o agente cobre a stack padrão e o OpenTelemetry preenche o que ficou de fora.
Definir esse arranjo antes da instalação evita retrabalho de dado e de painel depois. A Rike IS fecha esse desenho com as equipes de operações e de desenvolvimento do cliente antes de instrumentar o primeiro ambiente, por um motivo prático: agente e biblioteca aplicados ao mesmo trecho sem critério duplicam a medição, e a transação passa a aparecer duas vezes no mesmo percurso.
O que mudou com arquitetura distribuída
O APM nasceu em um mundo de aplicação monolítica, e esse detalhe de origem explica a transformação da disciplina.
Na aplicação monolítica, a requisição entrava, um único processo executava a operação inteira e a resposta saía. Medir era simples, porque o percurso inteiro cabia em um lugar só. Hoje, uma única requisição de usuário costuma atravessar muitos serviços independentes, executados em processos e máquinas diferentes, escritos em linguagens diferentes por equipes diferentes. Cada serviço enxerga apenas a própria parte.
O trace resolve a falta de visão do percurso completo. Trace é o registro do caminho de uma requisição por todos os serviços que participaram dela, composto por spans, os registros de cada operação individual. Ele funciona como o GPS de uma viagem, mostrando cada parada do trajeto. Com o trace em mãos, a pergunta deixa de ser qual servidor está ruim e passa a ser qual etapa do percurso consumiu tempo.
Para que o trace sobreviva ao salto de um serviço para o próximo, é preciso propagação de contexto, em que cada chamada carrega o identificador da requisição adiante. A propagação de contexto funciona como o carimbo no passaporte, que acompanha o viajante entre fronteiras. Quando alguma camada não repassa esse identificador, o percurso fica cortado ao meio e a análise perde justamente o trecho que interessava.
Na plataforma Dynatrace, o Smartscape mantém o mapa de dependências em tempo real e mostra quais serviços participam de cada percurso, sem depender de cadastro manual.
Trace é o que torna o monitoramento de aplicação obrigatório em sistemas distribuídos. Sem ele, a investigação de um incidente vira reunião com todas as equipes envolvidas, cada uma apresentando indicadores que parecem normais dentro do próprio recorte.
Para o SRE, o trace é a diferença entre localizar a causa raiz em minutos e negociar hipóteses por horas, com impacto direto no tempo médio de resolução. Para a diretoria, a mesma diferença aparece como previsibilidade de risco, porque uma indisponibilidade curta e outra que se estende por horas têm consequências distintas para receita, reputação e prestação de contas com as áreas de negócio.
O que decidir antes de instrumentar
Entender a definição é o primeiro passo, e desenhar a instrumentação de um ambiente crítico real é outro. Quatro decisões tomadas antes da instalação definem o teto do que a organização vai conseguir enxergar depois.
A primeira é de escopo: quais transações de negócio importam de fato. Instrumentar por facilidade técnica cobre o ambiente menos crítico, e o resultado não convence ninguém a expandir.
A segunda é de profundidade. Medir tempo por transação e por dependência externa pesa pouco sobre a aplicação, enquanto capturar detalhe de execução linha a linha custa mais. A equipe liga o detalhe fino no que é crítico e mantém o restante na medição padrão.
A terceira é de nomenclatura. O mesmo serviço precisa carregar o mesmo nome em toda a stack, ou a análise trabalha com entidades duplicadas e a transação aparece fragmentada entre times.
A quarta é de retenção: quanto tempo o dado precisa ficar disponível para consulta. Na plataforma Dynatrace, o Grail centraliza logs, métricas, traces, eventos e outros dados de observabilidade, com períodos de retenção que variam conforme o tipo de dado e a configuração adotada. O Dynatrace Query Language, ou DQL, permite consultar e correlacionar esses dados para análises e investigações.
Escopo, profundidade, nomenclatura e retenção parecem detalhes de implantação e se tornam limites permanentes do que a organização consegue enxergar.
Perguntas frequentes
APM deixa a aplicação mais lenta?
Instrumentação tem custo de execução, e esse custo varia com a profundidade escolhida. Medir tempo por transação e por dependência externa pesa pouco sobre a aplicação. Capturar detalhe de execução linha a linha, ligado o tempo todo em produção, pesa mais. A profundidade é decisão de projeto: a equipe liga o detalhe fino no que é crítico e mantém o restante na medição padrão.
O que o APM não mostra?
APM não mostra o que acontece fora da aplicação instrumentada. Falha de rede, disco cheio no host, erro dentro do navegador de quem acessa e problema em fornecedor sem telemetria aparecem no APM apenas como tempo de espera, sem a causa. Por isso monitoramento de aplicação convive com monitoramento de infraestrutura e com medição do lado do usuário, em vez de substituir os dois.
APM funciona em sistema legado?
Funciona quando a tecnologia do sistema está entre as que o agente reconhece. Sistema escrito em tecnologia fora da descoberta automática exige instrumentação manual no código ou medição pela borda, que é o tempo de resposta do serviço visto por quem o chama. A leitura pela borda mostra que o legado está lento, sem mostrar em qual etapa interna o tempo se acumulou.
Qual a diferença entre APM e DEM?
APM mede o software de dentro do ambiente de execução, do pedido recebido até a resposta devolvida. Digital Experience Monitoring, ou DEM, mede o outro lado: navegador, aplicativo, rede de quem acessa e tempo até a tela ficar utilizável. Uma transação pode responder rápido no servidor e chegar lenta ao usuário. APM não enxerga esse trecho final, e DEM não enxerga o método que travou dentro do código.
APM e AIOps são a mesma coisa?
Não. APM coleta e organiza o dado da aplicação. Artificial Intelligence for IT Operations, ou AIOps, é a camada que interpreta esse dado, agrupa alertas relacionados e aponta causa raiz. O Dynatrace Intelligence utiliza análise causal para apoiar a identificação da causa raiz. APM sem AIOps entrega evidência e deixa a correlação por conta da equipe de operações.
Quem sai desta definição e vai para a implantação encontra três frentes ao mesmo tempo: decidir o que precisa ser medido, manter a instrumentação consistente entre equipes que não se falam e sustentar a governança de performance com o ambiente já em produção. A Rike IS atravessa essas três frentes sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve as transações críticas do seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações