

Reduzir tempo de inatividade exige decompor o incidente em quatro intervalos: detectar, diagnosticar, corrigir e validar. Detecção encurta com linha de base aprendida e medição na ponta do usuário, diagnóstico com IA causal sobre o mapa de dependências, correção com entrega gradual e reversão automatizada, validação com confirmação da operação de negócio.
O intervalo entre a falha começar e o serviço voltar não é um número indivisível. Ele se compõe de quatro etapas distintas, com causas distintas e pontos de atuação distintos, e atacar o conjunto sem separá-las distribui esforço nos lugares errados.
A etapa mais custosa raramente é a que a equipe imagina. Em ambientes distribuídos sem observabilidade adequada, o diagnóstico consome a maior fatia do tempo total, e não a correção.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
O tempo de inatividade não é um número só
A decomposição útil separa quatro intervalos, e cada um responde a uma pergunta diferente sobre o incidente.
O primeiro intervalo é a detecção. Começa quando a falha passa a afetar o serviço e termina quando alguém, ou algum sistema, registra que há um problema.
O segundo é o diagnóstico. Vai do registro do problema até a identificação da causa que precisa ser tratada.
O terceiro é a correção. Do diagnóstico até a aplicação da mudança que restaura o serviço, seja ela uma reversão, um ajuste de configuração ou uma medida de contorno.
O quarto é a validação. Da aplicação da correção até a confirmação de que o serviço voltou de fato, para todos, e não apenas no indicador que a equipe consultou primeiro.
A concentração do tempo no diagnóstico é contraintuitiva porque a correção é a parte visível do trabalho. A equipe lembra do ajuste que resolveu, e não das horas gastas descobrindo qual ajuste fazer. Essa distorção de memória é o que faz o investimento ir para a etapa errada.
Encurtar a detecção
Detecção lenta tem uma causa dominante: o sistema avisa de um jeito, e o monitoramento escuta de outro.
O modelo por limiar fixo estabelece um valor absoluto de referência. Processador acima de determinado patamar, tempo de resposta acima de determinado limite, contagem de erro acima de determinado número.
Esse arranjo falha em dois cenários comuns. O primeiro é a variação natural de carga ao longo do dia, porque um limiar calibrado para o pico ignora anomalia real em horário de baixo movimento. O segundo é a autoescala: quando a infraestrutura se ajusta sozinha ao volume, o consumo de recurso deixa de ser sinal confiável, já que tende a se manter estável mesmo enquanto a experiência degrada.
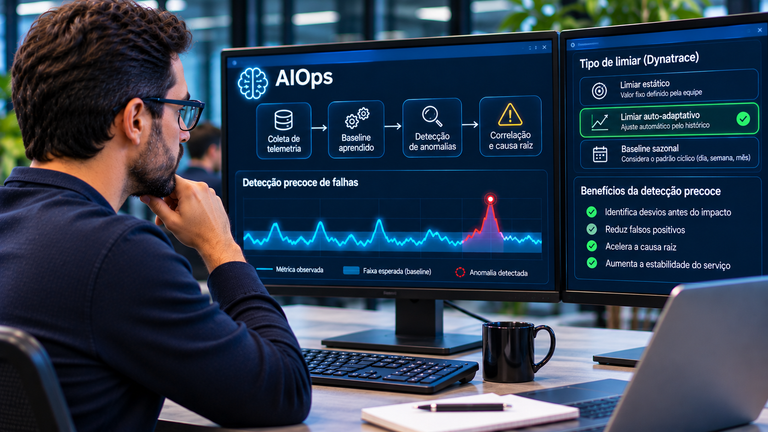
A alternativa é detectar desvio em relação ao comportamento aprendido de cada componente. A plataforma estabelece a linha de base própria daquele serviço, naquele horário, e sinaliza quando o comportamento sai do padrão.
Existe um segundo ponto de atuação na detecção que costuma ser esquecido: medir do lado do usuário. Uma operação pode falhar para parte da população, por região ou por dispositivo, enquanto todos os indicadores de servidor permanecem saudáveis. É o que a disciplina de Digital Experience Monitoring, ou DEM, captura.
Indicador de servidor funciona como o painel do carro: avisa que algo mudou de estado, sem dizer o que o passageiro sentiu. Sem medição na ponta, a descoberta chega pelo canal de atendimento, e o intervalo de detecção passa a ser determinado pela paciência de quem reclama.
Encurtar o diagnóstico
O diagnóstico é onde a observabilidade produz o efeito mais mensurável sobre o tempo total.
Em uma falha em cascata, um componente degrada e os serviços que dependem dele acumulam latência. As filas crescem, os tempos limite se esgotam, os erros se propagam. Cada camada instrumentada emite seu próprio alerta, e a equipe recebe dezenas ou centenas de notificações que descrevem sintomas verdadeiros do mesmo problema, sem que nenhuma aponte a origem.
O tempo então se consome em triagem. Alguém precisa ler o volume, descartar o redundante, formar hipótese e testá-la, justamente quando o tempo é o recurso mais escasso.
A inteligência artificial causal ataca esse ponto. Na plataforma Dynatrace, o OneAgent descobre a stack em execução sem configuração manual por componente e alimenta o Smartscape, o mapa de dependências em tempo real. Sobre esse mapa opera o Davis, que analisa relações de causalidade e não apenas proximidade temporal entre eventos.
A distinção importa. Em ambiente distribuído, dezenas de anomalias coincidem em uma janela de segundos sem manter relação de causa entre si, e ordenar sintomas por horário não resolve o incidente.
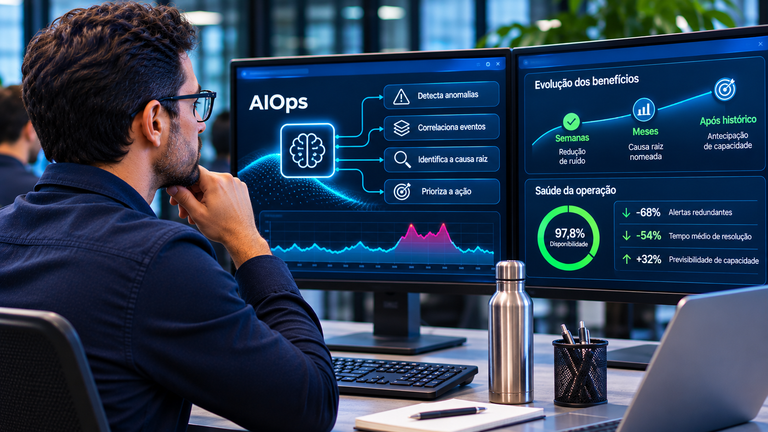
O resultado apresentado muda de natureza. Em vez de uma lista de anomalias, aparece um problema priorizado, com a causa raiz nomeada, o caminho de impacto descrito e a indicação de quais transações de usuário foram afetadas.
Dashboards organizam e tornam exploráveis os sinais operacionais, enquanto a Dynatrace Intelligence complementa essa análise com detecção de anomalias, correlação e investigação causal para reduzir a triagem e orientar a resposta.
Existe um pré-requisito. Essa análise opera sobre a consistência da instrumentação, e quando o mesmo serviço aparece com nomes diferentes em contextos diferentes, o motor trabalha com entidades duplicadas e o diagnóstico perde precisão. A convenção de atributos precisa estar fechada antes da primeira ingestão.
Encurtar a correção
A correção é a etapa em que a organização tem mais controle e a que costuma receber menos atenção estrutural. Dois mecanismos atuam aqui: a reversão rápida e a disponibilidade de medida de contorno independente do diagnóstico completo.
Reversão rápida depende de como a entrega foi feita. Mudança publicada de forma monolítica, sem mecanismo de retorno automatizado, transforma a reversão em novo projeto sob pressão.
Entrega gradual muda esse quadro. Quando a mudança é liberada para uma fatia da população antes de alcançar todos, a regressão aparece com impacto limitado e a reversão afeta menos usuários.
O segundo mecanismo contraria o instinto. Em sistema crítico, restaurar o serviço costuma preceder entender a causa, e isso exige que exista uma medida de contorno acionável sem o diagnóstico pronto.
Existe um custo nessa ordem, e ele precisa ser gerenciado. Mitigar antes de diagnosticar pode destruir a evidência: reiniciar um componente resolve o sintoma e apaga o estado que explicaria a causa.
É por isso que a retenção de telemetria faz parte do procedimento de incidente, e não apenas da arquitetura. O Grail retém logs, métricas, traces e eventos em volume massivo, com períodos de retenção que variam conforme o tipo de dado e a configuração adotada, mantendo consulta rápida sobre todo o histórico, e o Dynatrace Query Language, ou DQL, reconstrói o momento da falha depois que o componente já foi reiniciado. Com o dado preservado, a organização estabiliza primeiro e investiga depois sem perder a informação.
Encurtar a validação
A quarta etapa é a menos discutida e a que produz os incidentes reabertos.
Validação apressada tem um padrão reconhecível. A equipe aplica a correção, consulta o indicador que estava alarmando, vê o valor normalizar e encerra o incidente. O problema é que o indicador que alarmou não é necessariamente o que representa a entrega: um erro pode ter parado de ocorrer no componente corrigido e continuar afetando um subconjunto de usuários por outro caminho.
A validação adequada verifica três coisas. Se o sintoma original cessou. Se a operação de negócio afetada volta a concluir normalmente. E se nenhum novo desvio apareceu como efeito da correção aplicada.
O terceiro ponto é o que evita o incidente sequencial. Uma correção feita sob pressão pode introduzir problema em outro lugar, e o intervalo entre encerrar um incidente e abrir o seguinte costuma revelar isso.
Medir do lado do usuário encurta essa etapa de forma direta. Confirmar que a operação volta a concluir para a população real é mais conclusivo que confirmar que um indicador de servidor voltou ao normal.
O que o tempo de inatividade custa além das horas
Justificar investimento em redução de tempo de inatividade exige contabilizar o custo por inteiro, e ele se distribui em cinco frentes.
A primeira frente é o chamado represado. Cada minuto de indisponibilidade acumula demanda que precisa ser atendida depois, com custo de atendimento e com fila que se estende além do incidente.
A segunda frente é o Service Level Agreement, ou SLA, descumprido. O acordo formal de nível de serviço prevê consequência para o rompimento, que pode ser crédito, desconto ou multa conforme o que foi firmado.
A terceira frente é regulatória. Instituições financeiras respondem ao Banco Central e à Lei Geral de Proteção de Dados, ou LGPD, e precisam demonstrar resiliência operacional. Indisponibilidade prolongada pode acionar obrigação de comunicação.
A quarta frente é reputacional, e opera em prazo mais longo. A percepção de instabilidade se acumula entre incidentes, e não se dissolve quando o serviço volta.
A quinta frente distingue o setor público e as cooperativas. Um sistema de saúde indisponível durante uma campanha afeta atendimento em unidades simultâneas, e uma cooperativa com plataforma fora do ar arranha o relacionamento com associados em várias praças ao mesmo tempo.
Nenhuma dessas frentes aparece na conta de horas paradas, e todas aparecem na conta do negócio.
O que muda para cada time
A redução do tempo de inatividade produz quatro efeitos distintos dentro da organização.
Para o CIO, o CTO e o CEO, o efeito é de previsibilidade. A diretoria leva ao conselho a decomposição do tempo e onde o investimento atuou, em vez de apenas a contagem de incidentes do período.
Para o gerente de infraestrutura, o ganho é de precisão. Saber que o gargalo estava no diagnóstico, e não na capacidade, evita expansão de infraestrutura que não reduziria o tempo total.
Para o profissional de DevOps, o efeito está no ciclo de entrega. Entrega gradual com reversão automatizada encurta a correção, e isso permite publicar com mais frequência sem elevar o risco acumulado.
Para o Site Reliability Engineer, ou SRE, a mudança é cotidiana. O plantão deixa de consumir tempo em triagem de alerta redundante, e o esforço migra para a melhoria estrutural que reduz o próximo incidente.
Onde as tentativas de redução costumam falhar
Iniciativas de redução de tempo de inatividade falham por três motivos recorrentes, e todos decorrem de medir o alvo errado.
O primeiro motivo é otimizar a etapa visível. A equipe investe em automatizar a correção, que já era rápida, e mantém intacto o diagnóstico, que consumia a maior parte do tempo.
O segundo motivo é acompanhar apenas o tempo médio de resolução. Um valor médio baixo pode conviver com incidentes longos ocasionais, que são justamente os que produzem consequência contratual e reputacional. A leitura por distribuição revela o que a média esconde.
O terceiro motivo é tratar o indicador de forma isolada. Reduzir o tempo de resolução enquanto a frequência de falhas aumenta produz uma operação que conserta rápido o que quebra sempre, e o total de indisponibilidade não melhora.
A verificação que evita os três é simples de enunciar: medir os quatro intervalos separadamente, por incidente, e observar onde o tempo se concentra antes de decidir onde investir.
Perguntas frequentes
Como reduzir o tempo de inatividade dos sistemas?
Decompondo o incidente em quatro intervalos, detecção, diagnóstico, correção e validação, e atuando no ponto próprio de cada um. Em ambientes distribuídos sem observabilidade adequada, o diagnóstico costuma concentrar a maior parte do tempo total.
Por que o diagnóstico consome tanto tempo?
Porque em uma falha em cascata cada camada instrumentada emite alerta próprio, e a equipe recebe dezenas de notificações que descrevem sintomas verdadeiros do mesmo problema, sem que nenhuma aponte a origem.
Qual a diferença entre correlação temporal e IA causal no diagnóstico?
Correlação temporal observa proximidade no tempo entre eventos, sem distinguir causa de coincidência. A IA causal analisa relações de causalidade com base no mapa de dependências do ambiente, e aponta o evento que gerou a cadeia de falhas.
Devo estabilizar o serviço antes de encontrar a causa?
Em sistema crítico, normalmente sim. Isso exige que exista medida de contorno acionável sem diagnóstico completo e que a telemetria do momento da falha sobreviva à mitigação, para que a investigação posterior ainda seja possível.
Por que acompanhar apenas o tempo médio de resolução é insuficiente?
Porque a média oculta os incidentes longos ocasionais, que são os que geram consequência contratual e reputacional. Um tempo médio baixo com frequência alta de falhas indica operação que conserta rápido o que quebra sempre.
Encurtar o tempo de inatividade em ambiente de alta complexidade começa por medir os quatro intervalos separadamente e descobrir onde o tempo realmente se concentra. A Rike IS conduz esse diagnóstico junto das equipes de operações, sem interromper o que está em produção, e sustenta a instrumentação e a governança de performance sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o histórico de incidentes do seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações