

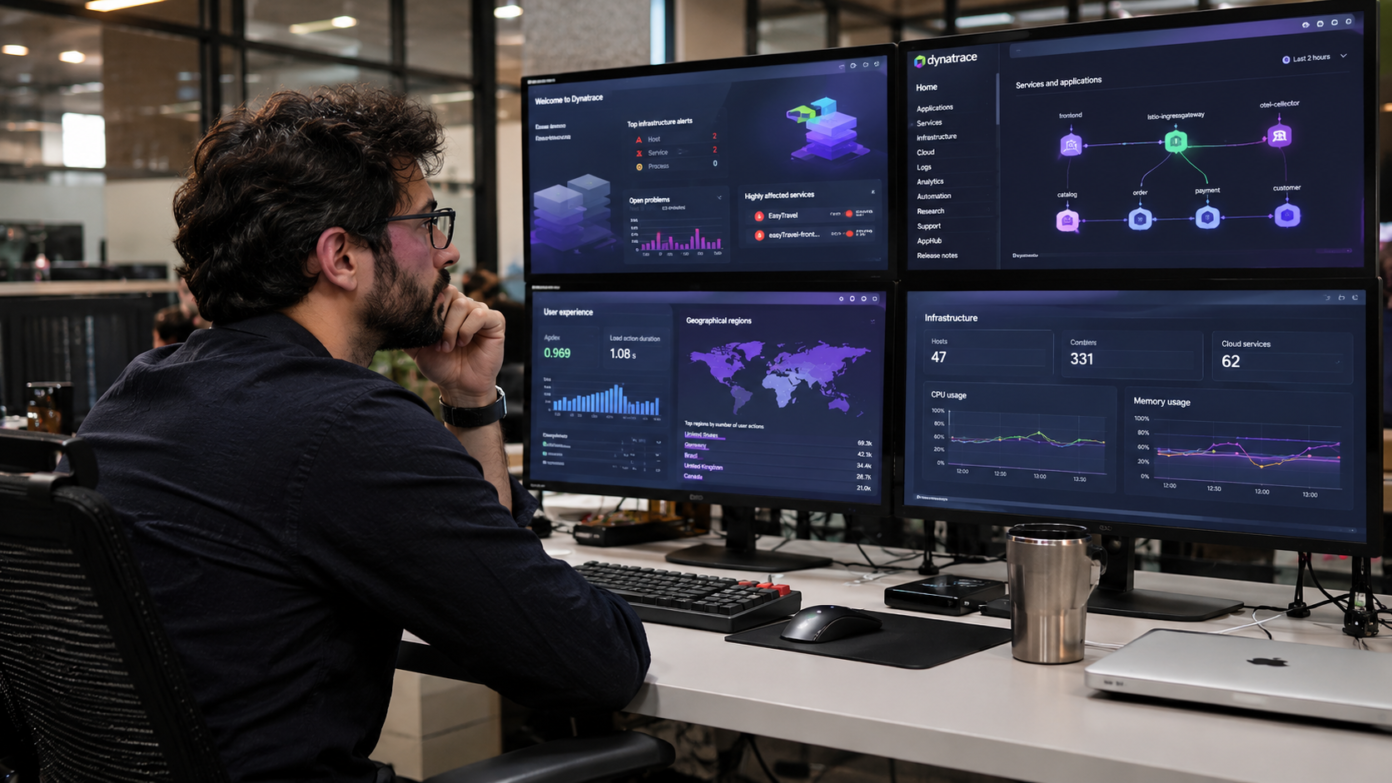
A plataforma Dynatrace é um produto de observabilidade full-stack que instala um agente único por host, o OneAgent, descobre sozinho a stack em execução e correlaciona aplicação, infraestrutura, nuvem e experiência do usuário em um contexto só. O inventário nasce da observação direta do ambiente, e não do que a documentação interna diz existir.
Em um ambiente distribuído, uma reclamação de lentidão pode vir do código de um serviço, de um banco sobrecarregado, de um contêiner sem memória, de uma chamada externa demorada ou da rede do próprio usuário. Cada uma dessas hipóteses vive em uma tela diferente quando as informações estão fragmentadas, e a maior parte do tempo de resolução se gasta procurando onde o defeito está, antes que alguém escreva a primeira linha de correção.
A plataforma Dynatrace acompanha, ao mesmo tempo, as aplicações, a infraestrutura, os ambientes de nuvem e a experiência de quem usa os sistemas de uma organização. A coleta começa com a instalação de um agente único em cada host, e esse agente descobre sozinho o que está rodando ali, sem que ninguém precise cadastrar componente por componente.
Observabilidade é a capacidade de explicar o comportamento interno de um sistema a partir dos sinais que ele emite. Monitoramento tradicional responde perguntas escritas antes do problema aparecer, e observabilidade guarda dado detalhado o suficiente para responder à pergunta que só surgiu durante o problema, quando ninguém tem tempo de instrumentar nada. A plataforma responde ao segundo caso.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
O que é a plataforma Dynatrace
A plataforma reúne em um único produto o que muitas operações mantêm em produtos separados: a medição do desempenho das aplicações, a leitura da saúde da infraestrutura, o acompanhamento da experiência do usuário e a análise automática de causa raiz. Os dados de todas essas camadas chegam ao mesmo lugar e ficam ligados entre si.
A ligação é o que dá sentido ao conjunto. Métrica isolada informa que algo piorou. Métrica ligada ao serviço, ao host e à transação de negócio informa o que piorou e para quem.
A proposta é eliminar a procura que consome o plantão. Como os sinais entram correlacionados e o mapa de dependências do ambiente é mantido atualizado, a equipe percorre o caminho da métrica anômala até o componente responsável sem trocar de ferramenta no meio do incidente.
Para o CIO, o CTO e o CEO, esse ponto se traduz em previsibilidade: a operação passa a relatar causa e impacto, e não apenas quantidade de chamados abertos. Para o Site Reliability Engineer, ou SRE, profissional responsável pela confiabilidade dos sistemas em produção, a tradução é mais direta, porque o tempo médio de resolução encurta quando o diagnóstico chega pronto.
O que a plataforma monitora
A resposta curta é a stack inteira. A resposta útil nomeia quatro camadas principais, com uma quinta leitura que atravessa todas as outras.
A primeira camada é a aplicação, território do Application Performance Monitoring, ou APM. Ele mede latência por transação, taxa de erro, volume de requisições e trecho de código lento, e essa medição é o que permite separar uma lentidão geral do ambiente da degradação de uma operação específica de negócio.
A segunda camada é a infraestrutura. Servidores físicos, máquinas virtuais, contêineres, clusters orquestrados, bancos de dados, filas de mensagem e rede entram nessa leitura, com consumo de processador, memória, disco e saturação de conexão.
A terceira camada é a nuvem. Serviços gerenciados, funções sem servidor e recursos provisionados por automação aparecem com o mesmo nível de leitura dos recursos tradicionais, o que importa em ambiente híbrido, onde parte da operação nunca saiu do datacenter próprio. Uma leitura que cobre a nuvem e ignora o legado deixa cego justamente o trecho mais antigo do fluxo.
A quarta camada é a experiência digital do usuário, coberta pelo Digital Experience Monitoring, ou DEM. Ele captura tempo de carregamento de página, erro de interface, abandono de fluxo e conclusão de operação crítica, separados por região, navegador e dispositivo.
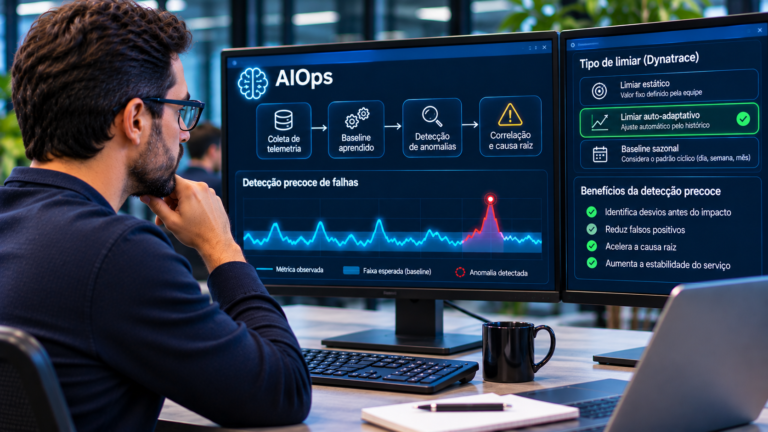
A quinta leitura atravessa as quatro anteriores e se chama Artificial Intelligence for IT Operations, ou AIOps. Ela correlaciona os eventos das outras camadas, aponta causa raiz e reduz uma enxurrada de alertas a um problema priorizado.
A dúvida mais comum de quem chega ao assunto pela primeira vez é se a plataforma observa aplicação ou infraestrutura. A resposta é as duas, e é justamente essa combinação que permite afirmar que a lentidão de uma operação veio do banco de dados, e não do código da aplicação.
Para o gerente de infraestrutura, essa amplitude aparece como previsão de capacidade sustentada por consumo real, em vez de estimativa. Para o profissional de DevOps, aparece como leitura de impacto de cada implantação nas camadas que ela toca, do contêiner recém-publicado até o tempo de resposta sentido pelo usuário. Uma reversão decidida com essa leitura acontece por evidência, e não por suspeita.
Como a instrumentação acontece
Instrumentar um sistema é instalar os pontos de coleta que produzem os dados de observabilidade. Instrumentação são as câmeras instaladas na fábrica: sem câmera não há imagem, e câmera apontada para o lugar errado produz imagem inútil.
Na plataforma Dynatrace, a instrumentação padrão acontece pelo OneAgent, o agente unificado instalado uma vez por host, contêiner ou ambiente de nuvem. Depois de instalado, ele executa a descoberta automática, ou auto-discovery, da stack em execução naquele ponto. O inventário nasce pronto e nasce correto, porque vem da observação direta do ambiente.
A ausência de cadastro manual costuma surpreender quem tem experiência com ferramentas anteriores de monitoramento. Não existe cadastro de cada serviço, nem arquivo de configuração por componente, nem tarefa recorrente de atualizar inventário quando o time sobe um serviço novo. A descoberta é contínua, e isso importa porque infraestrutura efêmera derruba qualquer configuração amarrada ao host.
A configuração manual não desaparece por completo, e prometer isso seria desonesto. Ela deixa de ser tarefa de instalação e passa a ser tarefa de governança: definir convenção de nomes, atributos obrigatórios, política de retenção e critério de amostragem. Essas decisões custam pouco quando tomadas no início do projeto e custam reprocessamento de histórico quando adiadas.
Há também casos em que o agente tradicional não se aplica, como funções sem servidor e linguagens com cobertura automática menor. Nesses casos, a instrumentação entra por OpenTelemetry, padrão aberto e vendor-neutral da CNCF que funciona como o padrão USB-C da telemetria, e a plataforma recebe os dois caminhos dentro do mesmo contexto correlacionado. O desenho híbrido é o mais comum em ambientes complexos.
Entender qual dessas combinações cabe em cada ambiente é conversa de diagnóstico, não de catálogo. A Rike IS começa por um levantamento do que já existe instalado antes de propor qualquer instalação nova.
O que a plataforma faz com os dados coletados
Coletar dado é a parte barata do problema. Um ambiente de porte médio produz volume de métrica, registro de log e rastreamento que nenhuma equipe consegue ler manualmente, e volume sem tratamento vira ruído.
A plataforma trata esse volume em três movimentos, nesta ordem: correlacionar, diagnosticar e priorizar.
O primeiro é a correlação. Cada sinal coletado entra amarrado ao componente que o produziu e às dependências desse componente, de modo que uma métrica de latência já nasce ligada ao rastreamento da transação e aos registros do serviço envolvido.
O segundo é o diagnóstico causal, feito pelo Davis, que dentro do Dynatrace Intelligence é responsável pela análise causal da plataforma. A palavra que carrega o peso técnico ali é causal: análises baseadas apenas em coincidência de horário afirmam que dois eventos ocorreram juntos, e em ambiente distribuído dezenas de anomalias ocorrem juntas sem qualquer relação de causa entre si. O mapa de dependências atualizado em tempo real é o insumo que permite separar causa de coincidência. A IA causal atua na identificação da causa e do contexto do problema, enquanto os dashboards organizam e tornam exploráveis os sinais operacionais.
O terceiro é a priorização. Em vez de uma lista longa de alertas descrevendo sintomas verdadeiros do mesmo defeito, a equipe recebe um problema nomeado, com a causa raiz identificada, o caminho de propagação do impacto e quais operações de usuário foram atingidas.
Para o SRE, esse resultado muda a rotina de plantão, porque o esforço sai da triagem de alerta redundante e vai para a correção. Para o gerente de infraestrutura, muda a conversa de custo, já que consumo real substitui estimativa na hora de dimensionar recurso.
Para que tipo de ambiente a plataforma foi desenhada
A plataforma foi desenhada para ambientes onde a indisponibilidade tem consequência imediata e a diversidade tecnológica é regra, não exceção.
Esse recorte descreve quatro tipos de operação, cada uma com uma exigência própria. Instituições financeiras precisam demonstrar resiliência operacional com trilha auditável que reconstitua o que cada sistema fez em cada momento. Órgãos públicos carregam heterogeneidade tecnológica herdada de décadas, com sistemas antigos e modernos no mesmo fluxo, e custo de indisponibilidade que é social antes de ser financeiro. Cooperativas precisam comparar desempenho entre praças com evidência objetiva, e empresas privadas de grande porte competem pela experiência digital, onde a degradação silenciosa de um fluxo vira receita perdida antes de disparar alerta de infraestrutura.
O denominador comum entre os quatro é sempre o mesmo: a pergunta que precisa ser respondida durante o incidente não foi formulada antes dele.
Existe também o cenário oposto, e reconhecê-lo é sinal de honestidade técnica. Uma aplicação única, em um servidor único, com poucos usuários e sem trilha auditável a prestar, não extrai da plataforma o que ela tem de melhor. O ganho aparece com distribuição, com volume e com criticidade.
O que decidir antes de avançar
Quem terminou esta leitura já sabe o que a plataforma é, o que ela observa e como a coleta começa. O passo seguinte depende de três decisões que nenhuma leitura resolve sozinha, porque todas dependem do que já existe rodando.
A primeira é de escopo de instrumentação: quais aplicações e quais transações de negócio entram na primeira onda. Cobertura total como meta inicial atrasa a entrega e eleva o custo de ingestão sem melhorar a detecção do que importa.
A segunda é de convenção de atributos. Nome de serviço, identificação de ambiente e dono responsável precisam estar acordados antes da primeira coleta, porque corrigir nomenclatura depois implica reprocessar histórico e refazer painel.
A terceira é de retenção. Quanto tempo cada tipo de dado precisa ficar disponível para consulta define a conta mensal e o que a investigação vai encontrar meses depois. Na plataforma Dynatrace, o Grail armazena telemetria em escala, com períodos de retenção definidos conforme o tipo de dado e a configuração adotada, permitindo consultas e análises sobre o histórico armazenado. O Dynatrace Query Language, ou DQL, é a linguagem que interroga esse acervo. O Smartscape, mapa de dependências atualizado em tempo real, é o que alimenta a análise causal descrita acima.
Escopo, convenção e retenção parecem detalhes de implantação e se tornam limites permanentes do que a organização consegue enxergar depois.
Perguntas frequentes
Auto-discovery e instrumentação automática são a mesma coisa?
São etapas distintas e a confusão entre elas atrapalha a conversa de projeto. A descoberta automática é o inventário: o OneAgent varre o host e descobre a stack em execução ali. A instrumentação automática é o passo seguinte, quando o agente injeta os pontos de coleta dentro desses processos e passa a produzir métrica, rastreamento e registro. Um ambiente pode aparecer descoberto no mapa e ainda assim não estar instrumentado em profundidade, e essa diferença explica a maior parte das dúvidas sobre dado faltando na primeira semana.
A instalação do OneAgent exige reiniciar as aplicações?
A instalação do agente no host não derruba nada. O que pede ou não reinício depende da tecnologia de cada aplicação, e essa verificação faz parte do levantamento anterior à implantação. Aplicação que roda em contêiner absorve a mudança no próprio ciclo de publicação, porque cada nova versão sobe em um contêiner novo. Aplicação legada em servidor tradicional costuma pedir janela combinada com o dono do sistema, e vale planejar essa janela antes da implantação, não descobri-la no meio dela.
A plataforma convive com as ferramentas de monitoramento que já existem no ambiente?
Convive, e na prática a convivência é a regra durante a transição. Ferramentas antigas costumam permanecer ligadas enquanto a equipe de operações valida se a nova leitura reproduz o que a anterior mostrava. O ponto de atenção é o alerta duplicado: dois sistemas apontando o mesmo sintoma cansam o plantão e minam a confiança na análise de causa raiz. Definir cedo quem é a fonte de verdade de cada tipo de alerta evita esse desgaste.
Ativar a leitura de experiência digital do usuário exige mexer no código do front-end?
Na maior parte dos casos, não. Quando o OneAgent está instalado no servidor que entrega a aplicação web, a captura da navegação real é habilitada por configuração, sem alteração de código. Restam cenários em que a intervenção manual aparece, e eles se identificam no levantamento do ambiente. Fluxo crítico que a equipe queira acompanhar como operação de negócio nomeada precisa ser declarado.
Quanto tempo depois da implantação a análise de causa raiz fica confiável?
A resposta honesta é que a confiabilidade cresce com histórico, não com a conclusão da instalação. O motor causal precisa observar o comportamento normal do ambiente antes de julgar o que é anomalia. Operações com sazonalidade forte, como fechamento de mês ou pico de campanha, só entram nessa linha de base depois que o ciclo acontece ao menos uma vez sob observação. Nas primeiras semanas, a equipe usa a plataforma sobretudo para navegar dependências e confirmar hipótese, e o diagnóstico automático ganha peso à medida que a linha de base amadurece.
Colocar uma plataforma de observabilidade full-stack em produção em um ambiente crítico exige diagnóstico do que já está instalado, planejamento de implantação, capacitação das equipes e governança de performance depois que o projeto termina. A Rike IS conduz esse percurso sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o inventário do que já roda no seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações