

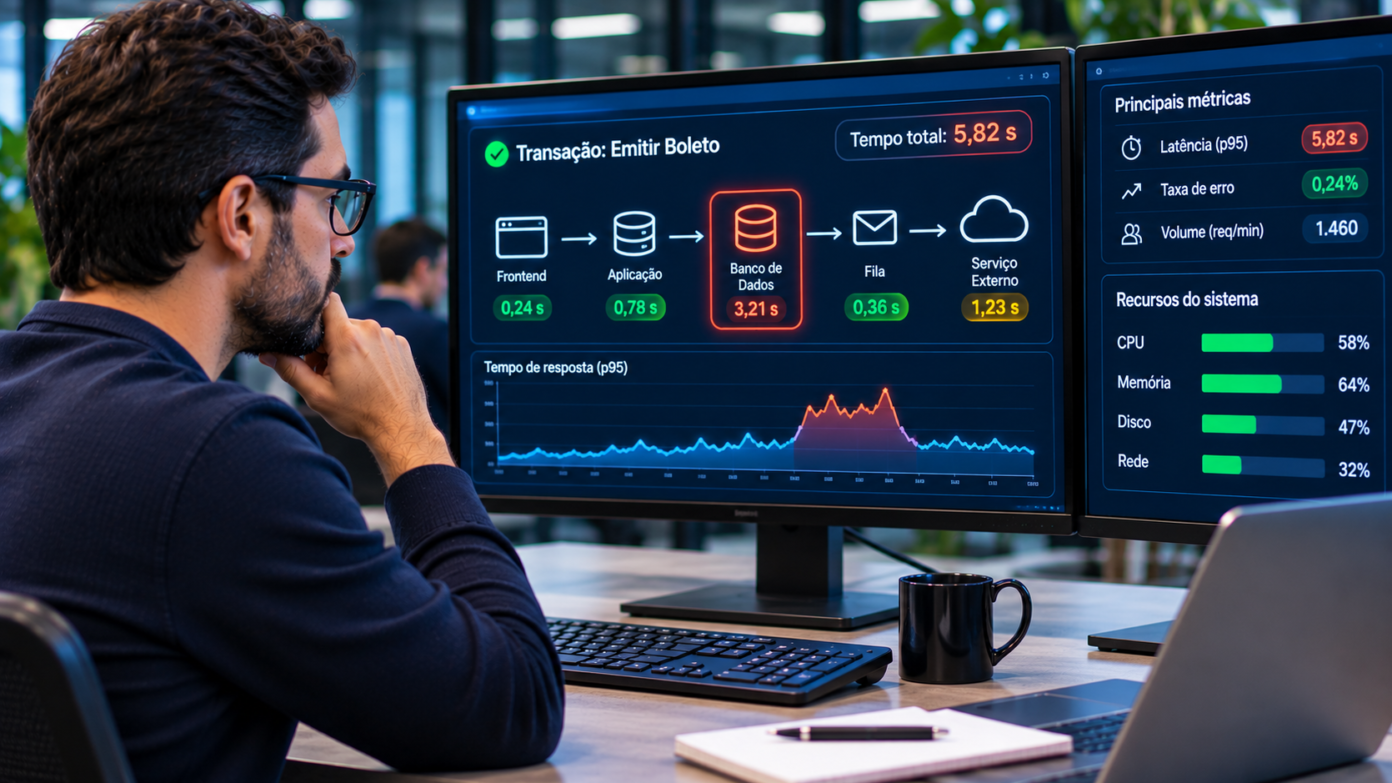
Lentidão no sistema se resolve por eliminação, em três movimentos. O primeiro separa degradação geral de infraestrutura de queda de desempenho em uma transação de negócio, porque as duas têm métodos de investigação distintos. O segundo segue o trace da requisição lenta até o componente que consumiu o tempo, e o terceiro lê os logs desse serviço, onde a causa aparece por escrito.
O usuário consegue trabalhar, o painel de infraestrutura raramente acusa falha, e a operação leva muito mais tempo que o habitual. Nenhum alarme dispara porque nada quebrou.
Lentidão no sistema é a degradação do tempo de resposta de uma operação sem que o sistema fique indisponível, e o diagnóstico começa por uma pergunta de corte: a degradação atinge tudo ou atinge uma transação específica de negócio?
Esse corte economiza horas de investigação. Procurar capacidade de servidor enquanto o tempo se acumula em uma consulta ao banco de dados leva a equipe de operações a percorrer o caminho errado com dedicação. A resposta define qual das duas investigações começa.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte que operam sistemas críticos.
Primeiro corte: lentidão geral ou transação específica
Lentidão geral e lentidão de transação têm sintomas parecidos no relato e origens completamente diferentes no sistema. Confundir as duas é a causa mais comum de investigação longa.
A lentidão geral atinge tudo ao mesmo tempo. Todas as telas demoram, todos os usuários sentem, e a degradação aparece de forma proporcional em operações que não têm nada em comum entre si. A origem costuma estar embaixo da aplicação: memória disponível no limite, disco saturado, contenção de processador no hospedeiro, rede congestionada entre camadas.
A degradação de transação específica é mais silenciosa. Uma operação de negócio, a emissão de um boleto, a consulta de saldo, o envio de um documento, passa a levar mais tempo enquanto o resto do sistema segue normal. Indicadores agregados de infraestrutura continuam saudáveis, porque a maior parte do que eles medem continua saudável de fato.
Três verificações separam os dois casos logo no início do plantão.
A primeira é de abrangência. Se o tempo de resposta subiu em operações que não compartilham código, banco nem dependência externa, o problema está em uma camada comum a todas, e essa camada é infraestrutura ou rede.
A segunda é de forma da curva. Degradação de infraestrutura costuma subir junto com a carga e acompanhar o gráfico de utilização de recurso. Degradação de transação frequentemente aparece em degrau, a partir de um horário determinado, sem relação com o volume de acesso naquele momento.
A terceira é de correlação com mudança. Uma implantação, uma alteração de configuração, uma janela de manutenção do banco de dados ou uma atualização de dependência externa no mesmo horário do degrau transforma suspeita em hipótese testável.
A disciplina que observa a aplicação por dentro, medindo latência por transação de negócio, se chama Application Performance Monitoring, ou APM. É ela que torna o segundo caso visível, porque mede a operação que o negócio reconhece em vez de medir apenas o recurso que a sustenta.
Para o Site Reliability Engineer, ou SRE, esse corte define o rumo do plantão, porque investigar a camada errada consome o tempo de resolução que o orçamento de erro do serviço não tem para gastar. Para o gerente de infraestrutura, o mesmo corte evita uma decisão cara: ampliar capacidade de servidor não corrige consulta lenta, e o custo da ampliação permanece depois que a lentidão volta.
Onde a latência se acumula
Latência é tempo, e tempo se acumula em lugares contáveis. Uma requisição lenta gastou seus milissegundos em algum ponto do percurso, e o percurso tem seis paradas possíveis em uma aplicação distribuída típica.
A primeira parada é o próprio código da aplicação: processamento pesado, laço que percorre coleção grande, serialização de objeto extenso, cálculo repetido a cada requisição em vez de guardado em memória.
A segunda é o banco de dados. Consulta sem índice adequado, varredura completa de tabela que cresceu, bloqueio entre transações concorrentes, pool de conexões esgotado com requisições esperando vaga.
A terceira é a fila. Sistemas que trabalham por mensagem acumulam latência quando a produção supera o consumo, e a fila crescendo é o sintoma mais legível de todo o conjunto, porque tem número e tendência.
A quarta é a dependência externa: serviço de terceiro, gateway de pagamento, provedor de autenticação, integração com órgão regulador. O tempo consumido ali entra inteiro no tempo de resposta da sua operação, e a organização não controla nem o código nem a capacidade do outro lado.
A quinta é a rede, com latência entre zonas de disponibilidade, resolução de nome demorada e negociação de conexão segura repetida a cada chamada em vez de reaproveitada.
A sexta é o navegador ou o aplicativo do usuário, onde o tempo se acumula depois que o servidor já respondeu, no processamento do código de interface e na renderização.
A divisão que orienta tudo o que vem depois está entre a quinta e a sexta parada: as cinco primeiras ficam antes da resposta do servidor, a sexta fica depois dela. Latência acumulada antes da resposta aparece no rastreamento distribuído da requisição. Latência acumulada depois aparece na medição do lado do usuário, disciplina chamada Digital Experience Monitoring, ou DEM.
Para o profissional de DevOps, mapear as seis paradas antes do incidente é o que permite responder rápido durante. Saber de antemão quais dependências externas entram no caminho de cada operação crítica encurta a lista de suspeitos no momento em que o tempo de resposta sobe.
Do sinal anômalo ao trace que explica o gargalo
Trace é o registro do caminho completo de uma requisição pelos serviços que a atenderam, com o tempo gasto em cada etapa, e cada etapa individual é um span. O trace é o GPS de uma viagem, mostrando cada parada do trajeto e quanto tempo o viajante ficou em cada uma.
Sem trace, a investigação de lentidão vira uma sequência de suposições testadas por eliminação. Com o trace disponível, ela vira leitura.
O percurso tem três degraus, e a ordem importa. A métrica anômala indica que existe problema e onde ele se manifesta, sem dizer o que o causou. O trace correspondente àquela anomalia, comparado com requisições da mesma operação em período normal, mostra qual etapa cresceu. Os logs do serviço identificado, no mesmo intervalo, trazem a exceção, a mensagem de tempo esgotado e o detalhe que a métrica não carrega.
A correlação entre esses três tipos de dado é o que separa investigação em minutos de investigação em turnos. Quando métricas, traces e logs vivem em repositórios separados, cada degrau exige troca de tela, exportação e alinhamento manual de horário.
Na plataforma Dynatrace, o OneAgent, agente unificado instalado no hospedeiro, descobre os componentes da stack e instrumenta as transações que passam por eles. O Smartscape mantém o mapa de dependências em tempo real, mostrando quais serviços conversam com quais. O Grail reúne métricas, traces e logs em uma única plataforma, com períodos de retenção definidos conforme o tipo de dado e a configuração adotada, e com consulta rápida. O Dynatrace Query Language, ou DQL, consulta esse conjunto sem precisar reunir as três fontes na mão.
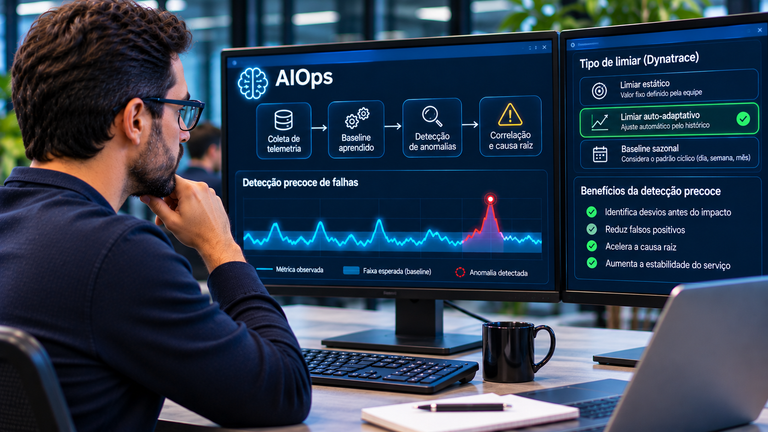
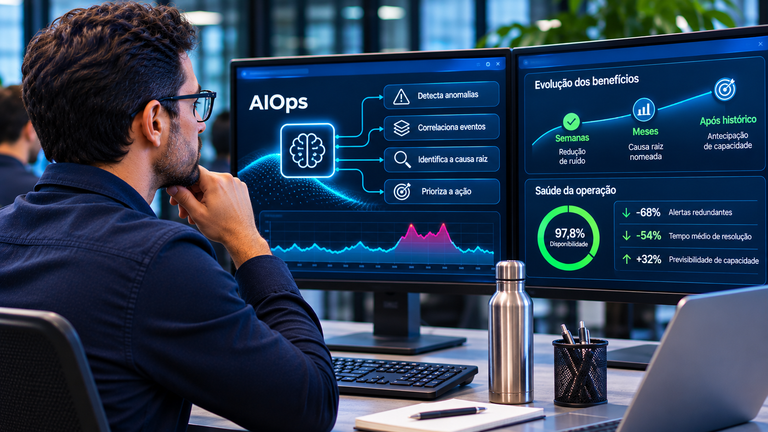
Sobre esse conjunto correlacionado atua o Davis, que dentro do Dynatrace Intelligence é responsável pela análise causal da plataforma e se apoia no mapa de dependências para dizer qual componente originou a degradação. A IA causal atua na identificação da causa e do contexto do problema, enquanto os dashboards organizam e tornam exploráveis os sinais operacionais. A disciplina que aplica esse tipo de inteligência à operação de tecnologia se chama Artificial Intelligence for IT Operations, ou AIOps.
Para o SRE, a correlação comprime o tempo médio de resolução. O plantão deixa de começar pela pergunta sobre onde está o problema e começa pela pergunta sobre por que aquele componente degradou, que é uma pergunta muito mais curta.
Causas frequentes por camada
Algumas causas se repetem tanto que vale conhecê-las pelo sintoma. Quatro delas concentram a maior parte dos casos de lentidão em sistemas corporativos.
A primeira é a consulta lenta no banco de dados. O sintoma clássico é a operação que funcionava bem e degradou aos poucos, ao longo de semanas, sem nenhuma mudança de código no meio. A causa costuma ser crescimento de tabela sem índice correspondente: a consulta que varria uma tabela pequena passou a varrer uma tabela grande, e o plano de execução mudou junto.
Existe uma variação dessa causa que engana muita gente. A consulta individual está rápida, e o problema é o número de consultas: uma tela que dispara uma consulta por item de uma lista multiplica chamadas curtas, cada uma aceitável, somando um tempo total inaceitável. O trace expõe esse padrão de imediato, porque mostra a repetição, enquanto a métrica de tempo médio por consulta continua bonita.
A segunda causa é o esgotamento de pool. Conexões de banco, threads de trabalho, sockets de saída, todos existem em quantidade limitada. Quando o pool esgota, as requisições novas ficam esperando por uma vaga, e o tempo de espera entra no tempo de resposta sem que nenhum recurso do servidor pareça saturado. A assinatura é característica: processador tranquilo, memória tranquila, tempo de resposta péssimo.
A terceira causa é a fila que cresce. O consumo ficou mais lento ou a produção aumentou, e a diferença entre as duas taxas se acumula. A lentidão percebida aqui tem atraso: o usuário envia a solicitação, recebe confirmação rápida, e o resultado só aparece bem depois, quando o consumidor finalmente processa a mensagem.
A quarta causa é a dependência externa degradada. Um serviço de terceiro que responde em tempo maior que o habitual transforma a operação que depende dele em operação lenta, sem nenhuma anomalia interna. O agravante é o efeito em cascata: se a chamada externa segura uma conexão do pool enquanto espera, a dependência lenta vira esgotamento de pool, que vira lentidão geral da aplicação.
Esse encadeamento explica por que a lentidão às vezes aparece primeiro como problema de infraestrutura e só depois se revela como problema de integração. O mapa de dependências resolve a ambiguidade, porque mostra a ordem em que os componentes degradaram.
Nenhum número de latência aceitável serve para todos os casos. O tempo tolerável de uma consulta de saldo em aplicativo de banco e o de um processamento em lote noturno não têm relação entre si, e definir o limite de cada operação é decisão de negócio, não de tecnologia.
Traduzir o repertório de causas frequentes para um ambiente específico exige conhecer o que roda ali: quais operações o negócio considera críticas, quais dependências externas entram no caminho de cada uma, quanto histórico a investigação precisa alcançar. A Rike IS faz esse levantamento antes de qualquer implantação, com profissionais que já operaram plantão em sistemas críticos.
Lentidão que atinge só parte dos usuários
Há um caso que resiste a todo o método anterior: a lentidão que a equipe de operações não reproduz. O relato existe, o chamado existe, e nenhuma métrica do servidor mostra alteração. Isso costuma ter duas origens: a degradação acontece depois da resposta do servidor, ou atinge um recorte da população que a média dilui.
Três recortes explicam a maior parte desses casos.
O primeiro é geográfico. A mesma aplicação, servida da mesma origem, entrega tempos diferentes para quem acessa de uma capital com conexão estável e de uma cidade pequena com rede saturada. Para uma cooperativa com agências dispersas ou para um órgão público de alcance nacional, essa variação tem peso de governança.
O segundo é de dispositivo. Um aparelho antigo leva mais tempo para processar o mesmo código de interface, e a diferença aparece inteira na percepção do usuário. Portais públicos sentem isso com força, porque a base de acesso inclui aparelhos de todas as gerações.
O terceiro é de versão. Uma implantação recente atingiu parte dos usuários, e quem ainda está na versão anterior não sente nada. Esse é o recorte que a equipe descobre por último quando não segmenta por versão.
A leitura por média esconde os três. Se a maior parte das sessões carrega rápido, o subconjunto lento desaparece do indicador, e o painel exibe uma saúde que o atendimento contradiz todos os dias. A leitura por percentil preserva a informação, mostrando o tempo enfrentado pela fatia em pior situação, que é exatamente o grupo que abre chamado e abandona a operação antes de concluí-la.
Para o CIO, o CTO e o CEO, trocar a média pelo percentil muda a conversa sobre risco. Um compromisso de tempo de resposta definido sobre média pode ser cumprido no papel enquanto parte relevante dos usuários enfrenta tempo inaceitável, e a contradição entre número e experiência só fica visível quando o indicador passa a ser o percentil.
Depois de resolver: como impedir a repetição
Incidente de lentidão resolvido sem aprendizado volta. A repetição chega com outro nome, em outro componente, e consome de novo o mesmo tempo de investigação que já foi gasto uma vez.
Quatro medidas transformam o achado de um incidente em prevenção, e todas dependem de o achado ter sido registrado com precisão.
A primeira é transformar o sintoma em indicador acompanhado. Se a lentidão apareceu no crescimento de uma fila, o tamanho dessa fila vira métrica com limite acordado e alerta próprio, em vez de continuar sendo um número que alguém olha quando desconfia.
A segunda é registrar o tempo de resposta esperado por operação de negócio. Sem um valor acordado, não existe critério para dizer que a operação está lenta, e a discussão sobre gravidade acontece sob pressão, no meio do incidente, quando ninguém tem paciência para negociar critério.
A terceira é ligar cada implantação ao comportamento que veio depois dela. Quando o tempo de resposta de uma operação sobe em degrau logo após uma entrega, a correlação precisa estar visível sem investigação manual, e a decisão de reverter passa a ser tomada em minutos.
A quarta é governança de atributos. Traces e logs só permitem segmentar por serviço, versão, região e tipo de cliente se as equipes nomearam esses atributos de forma consistente desde a implantação. Atributo inventado por equipe, sem convenção comum, produz dado que existe e não responde pergunta nenhuma.
As quatro medidas separam a equipe que apaga incêndios da equipe que previne incêndios.
No time DevOps, elas mudam a esteira de entrega, porque a verificação de desempenho passa a ser etapa da entrega e não descoberta do plantão seguinte. Quem gerencia infraestrutura ganha previsão de capacidade com base observada. O SRE colhe a redução de recorrência, que é a única forma de impedir que o mesmo problema consuma o orçamento de erro de novo. Para a diretoria, o resultado é previsibilidade: o tempo médio de resolução deixa de depender de quem está de plantão naquela noite.
Perguntas frequentes
O agente de monitoramento deixa o sistema mais lento?
O OneAgent consome recurso do hospedeiro, como qualquer software instalado, e esse consumo pesa mais em ambiente que já opera sem folga. A prática de campo é implantar em um subconjunto do parque, comparar processador e memória antes e depois, e só então expandir. Ambiente que degrada visivelmente com a instrumentação ligada costuma estar no limite de capacidade, e isso é achado de diagnóstico, não efeito colateral a esconder.
Trace e perfilamento de código servem para a mesma coisa?
Trace e perfilamento respondem a perguntas diferentes. O trace mostra em qual serviço ou chamada o tempo foi consumido, na granularidade da operação. O perfilamento mostra em qual método, dentro daquele serviço, o processador ficou ocupado. A ordem prática usa o trace para escolher o componente e o perfilamento para abrir o componente escolhido. Perfilar tudo desde o começo custa caro e raramente aponta o lugar certo.
E se a operação lenta não tiver trace disponível?
A investigação começa pela instrumentação da operação, não pelo palpite. Enquanto o trace não existe, restam três fontes parciais. O registro de acesso do servidor de aplicação dá o tempo total por requisição. Os indicadores do próprio banco de dados mostram as consultas mais custosas no intervalo, e os logs do serviço suspeito completam o conjunto. Nenhuma das três atribui o tempo a uma etapa do percurso, e é por isso que instrumentar vem antes de investigar em ambiente que já sofreu o problema uma vez.
Latência e tempo de resposta significam a mesma coisa?
Os dois termos nomeiam medidas diferentes, embora o uso cotidiano misture as duas. Latência costuma nomear a espera de um trecho do percurso, como a chamada ao banco de dados ou o salto de rede entre dois serviços. Tempo de resposta nomeia o total percebido pelo usuário, do envio da requisição até a resposta completa. Um tempo de resposta ruim é a soma de várias latências, e a investigação existe para descobrir qual delas cresceu.
Quanto tempo de dado histórico é preciso guardar para investigar lentidão?
O suficiente para comparar o período degradado com um período normal equivalente. Lentidão em degrau se resolve com histórico curto, porque a comparação é imediata e o antes está logo ali. Degradação que cresce devagar, como tabela que incha ao longo de semanas, exige retenção que cubra o intervalo inteiro do crescimento, senão o gráfico começa depois do problema. Definir a retenção por tipo de dado, em vez de aplicar um prazo único a tudo, é o que mantém o custo sob controle.
Diagnosticar lentidão em sistemas críticos exige instrumentação correta, correlação entre métricas, traces e logs, e governança de performance que sobreviva ao incidente que a originou. A Rike IS conduz consultoria, implantação, treinamento e operação contínua sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve um caso concreto de lentidão do seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações