

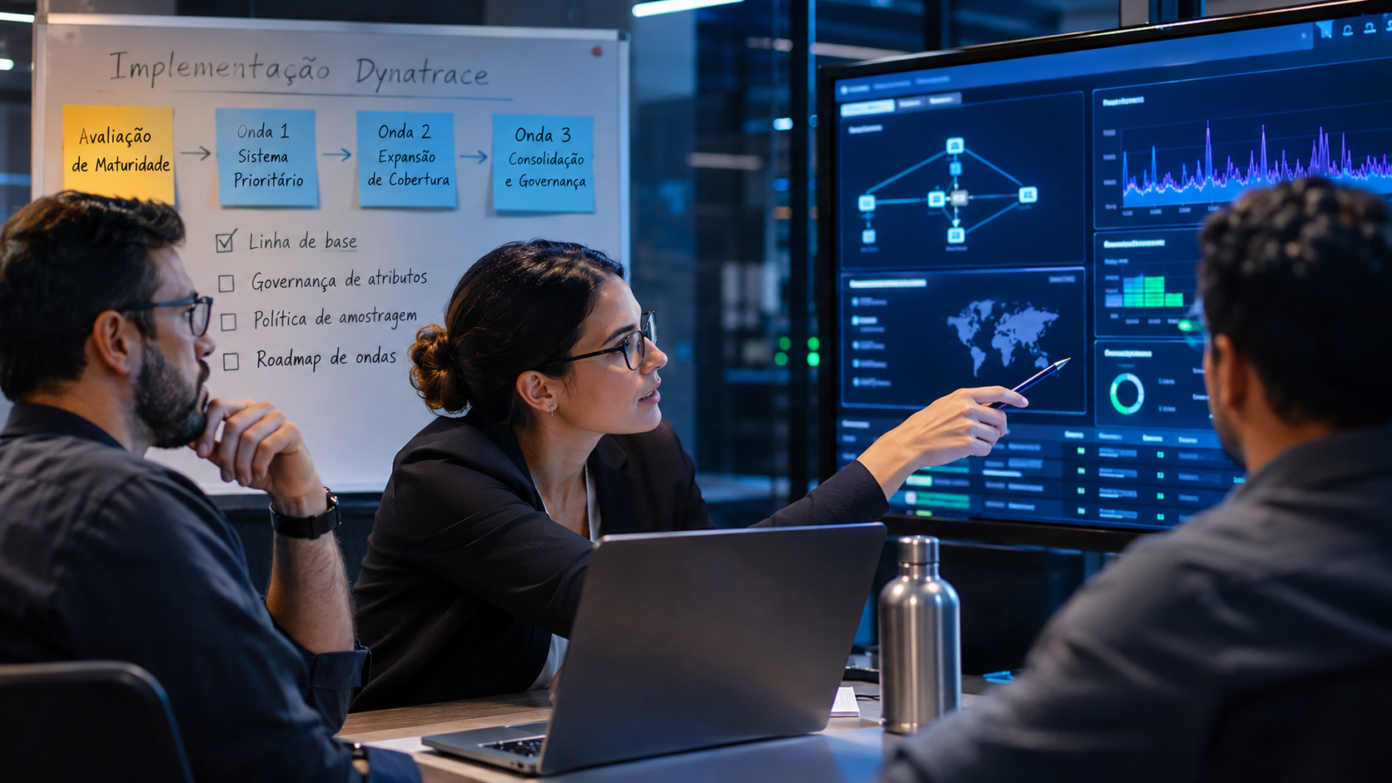
A implementação da plataforma Dynatrace acontece em ondas, e começa por uma avaliação de maturidade que registra a linha de base antes de qualquer instalação. A primeira onda instrumenta o sistema de maior dor operacional, e as seguintes expandem cobertura. Governança de atributos e política de amostragem precedem o código em produção, porque corrigir depois significa reprocessar histórico.
Instalar antes de decidir o que medir produz dado abundante e pouco utilizável. A ordem importa mais do que a velocidade, e é por isso que nenhuma instalação começa antes da avaliação inicial.
A implementação Dynatrace é um projeto de instrumentação conduzido em ondas, em que cada uma tem escopo declarado, critério de sucesso e data de revisão. A primeira cobre o sistema de maior dor operacional e entrega valor visível em poucas semanas, e as seguintes expandem cobertura por domínio, por ambiente ou por unidade de negócio.
O prazo total varia. Tamanho do ambiente, complexidade da arquitetura e maturidade da equipe de operações movem esse número em qualquer direção, e um projeto responsável não crava data antes do diagnóstico.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
Fase 0: a avaliação inicial que antecede a instalação
A avaliação inicial produz três entregas, e cada uma responde a uma pergunta que o projeto vai cobrar mais adiante. Ela é levantamento técnico feito dentro do ambiente do cliente, com acesso a arquitetura, inventário de hosts, topologia de rede e histórico de incidentes.
A primeira entrega é o mapa de maturidade. Ele registra o que já existe de instrumentação, quais times operam quais sistemas, como o alerta chega hoje ao plantão e quanto tempo a equipe leva para localizar a causa raiz de uma falha recorrente.
O tempo de localização de causa raiz medido nessa fase vira a linha de base do projeto. Sem linha de base registrada antes da primeira instalação, qualquer afirmação de melhoria feita ao final é opinião.
A segunda entrega é a dor prioritária. Ambientes grandes têm muitos problemas simultâneos, e tratar todos ao mesmo tempo dilui o resultado da primeira onda. A avaliação escolhe um alvo: o sistema que mais gera indisponibilidade, o fluxo de negócio que mais custa quando degrada ou o ponto cego que mais atrasa o diagnóstico.
A terceira entrega é o roadmap de ondas, que define quantas ondas o projeto terá, o que entra em cada uma e qual critério autoriza a passagem para a seguinte.
Para o CIO, o CTO e o CEO, a avaliação inicial converte um pedido de orçamento em previsão de risco. O executivo passa a saber qual sistema será coberto primeiro, o que muda quando essa cobertura existir e o que continua exposto até a onda seguinte, e é isso que sustenta a aprovação do investimento diante do conselho.
Por que a implantação acontece em ondas
A implantação em ondas divide o projeto em ciclos curtos de escopo fechado, cada um com entrega verificável em produção. Em vez de um projeto longo que só mostra resultado no final, o modelo coloca observabilidade real em operação em poucas semanas e amplia a cobertura nos meses seguintes.
Dois problemas motivam esse desenho, e ambos aparecem em projeto de instrumentação de qualquer porte.
O primeiro é de risco. Instrumentar todo o parque de uma vez concentra mudança em ambiente produtivo, multiplica pontos de falha simultâneos e deixa a equipe sem referência para distinguir efeito do projeto de efeito do sistema.
O segundo é de aprendizado. Convenções de nomenclatura, política de alerta e limites de consumo são decisões que melhoram com a prática, e a primeira onda existe também para calibrar essas decisões antes que se repliquem pelo parque inteiro de serviços.
Uma onda tem quatro marcos: escopo declarado, instrumentação executada, validação com o time dono do sistema e revisão de critério de sucesso. Nenhuma onda é considerada concluída sem o quarto marco.
A onda também tem um custo que costuma passar despercebido no planejamento: o tempo do time dono da aplicação. Instrumentar sem a participação de quem opera o sistema produz cobertura tecnicamente correta e operacionalmente inútil, porque ninguém reconhece o próprio fluxo de negócio nos painéis.
Para o gerente de infraestrutura, o modelo em ondas resolve uma questão de capacidade. O consumo de recursos, o volume de ingestão de dados e o custo mensal crescem de forma observável, onda a onda, o que permite ajustar antes que o número surpreenda. Previsibilidade de custo vem da progressão controlada, e não de estimativa feita antes da primeira coleta.
Onda 1: onde começar
A primeira onda começa pelo sistema que a avaliação inicial elegeu como dor prioritária. Esse recorte concentra atenção onde o resultado será percebido por quem patrocina o projeto e por quem opera o plantão.
A instalação usa o OneAgent, o agente unificado da plataforma. Uma única instalação descobre a stack em execução no host, no contêiner ou no ambiente de nuvem, sem que a equipe precise cadastrar cada componente à mão. Há cargas que o agente não alcança da forma tradicional: funções sem servidor e linguagens com instrumentação automática menos abrangente entram por OpenTelemetry, padrão aberto e vendor-neutral mantido pela CNCF, que funciona como o padrão USB-C da telemetria.
A escolha nunca é entre plataformas. A decisão de arquitetura fica entre OneAgent, OpenTelemetry ou o modelo híbrido, que é o desenho mais comum em ambientes complexos e o adotado pela Rike IS na maior parte dos projetos.
Quando OpenTelemetry entra, entra com destino definido. Os dados trafegam por OpenTelemetry Protocol, ou OTLP, sobre gRPC na porta 4317 ou sobre HTTP com protobuf na porta 4318, e o Collector recebe, processa, filtra e reenvia esse tráfego para a plataforma. O Collector é o ponto onde a equipe aplica regra de filtro, remove atributo sensível e controla volume antes da ingestão, e deixar essa camada para depois costuma custar reprocessamento.
A onda 1 tem quatro resultados esperados.
O primeiro é instrumentação ativa no sistema escolhido, cobrindo a infraestrutura que o sustenta e a camada de Application Performance Monitoring, ou APM, que enxerga o comportamento do código em execução. O segundo é o Smartscape povoado, mostrando em tempo real as dependências reais daquele sistema.
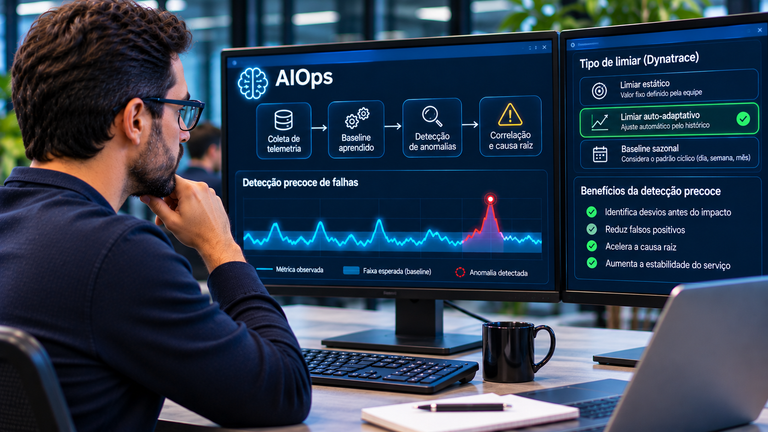
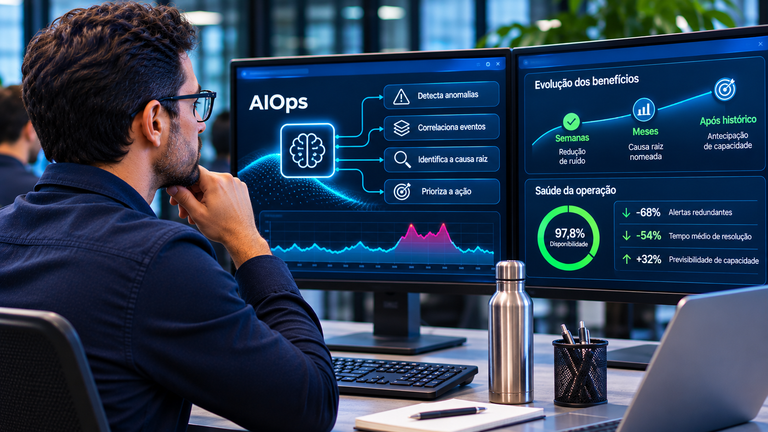
O terceiro é a análise causal do Davis operando sobre esse mapa. Ele entrega ali a capacidade de Artificial Intelligence for IT Operations, ou AIOps, que substitui a lista de anomalias por um problema priorizado, com causa raiz nomeada e caminho de impacto descrito. A IA causal atua na identificação da causa e do contexto do problema, enquanto os dashboards organizam e tornam exploráveis os sinais operacionais.
O quarto é o conjunto inicial de alertas revisado com o time dono da aplicação, para que o plantão receba evento acionável em vez de ruído.
Para o Site Reliability Engineer, ou SRE, a primeira onda muda o trabalho de plantão de imediato. O tempo que antes ia para triagem de alerta redundante passa a ir para o tratamento do problema, e a investigação começa com o caminho de impacto já descrito.
Em ambientes de heterogeneidade tecnológica alta, comuns no setor público, a onda 1 costuma incluir também um componente legado, justamente para provar cobertura onde o ceticismo interno é maior.
Governança de atributos antes do código entrar em produção
Governança de atributos é o conjunto de regras que define como a equipe nomeia e classifica cada sinal de telemetria antes de coletá-lo. Essa definição precisa existir antes do código instrumentado entrar em produção, porque corrigir depois significa reprocessar histórico. A análise causal opera sobre a qualidade da instrumentação, e quando o mesmo serviço aparece com nomes diferentes em contextos diferentes, o motor trabalha com dados fragmentados e o diagnóstico perde precisão.
Três decisões, em ordem, resolvem a maior parte do problema.
A primeira é a convenção de nomenclatura, apoiada nas semantic conventions do OpenTelemetry. Atributos como service.name e cloud.region têm significado padronizado, e adotar o padrão evita que cada equipe invente o próprio vocabulário.
A segunda é a lista de atributos obrigatórios. Time responsável, criticidade do serviço, ambiente e unidade de negócio precisam acompanhar o sinal desde a origem, porque são esses campos que permitem filtrar, cobrar e priorizar depois.
A terceira é a regra de cardinality, que trata dos campos de alta variabilidade. Identificador de usuário, identificador de sessão e parâmetro de URL multiplicam séries temporais sem acrescentar capacidade de diagnóstico, e cada um precisa de decisão explícita sobre entrar, ser agregado ou ficar de fora.
A propagação de contexto completa o quadro. O contexto acompanha a requisição entre serviços como o carimbo no passaporte acompanha o viajante entre fronteiras, e essa continuidade é o que permite reconstituir o trace inteiro em vez de trechos soltos.
Para o profissional de DevOps, a governança de atributos deixa de ser burocracia quando entra na esteira de entrega contínua. A verificação de convenção vira etapa automatizada, o serviço mal nomeado é barrado antes da publicação e cada implantação passa a ser acompanhada por métrica de impacto. A reversão deixa de ser decisão por percepção, porque o time compara o comportamento da versão publicada com a anterior sobre a mesma base de dados.
Política de amostragem e previsibilidade de custo
Sampling, ou amostragem, é a decisão de quanto do tráfego instrumentado a plataforma retém para análise. Funciona como a pesquisa eleitoral, que observa parte para inferir o todo, com uma diferença operacional relevante: em sistema crítico, os eventos que interessam são justamente os raros.
Reter tudo eleva custo sem elevar capacidade de diagnóstico na mesma proporção. Reter pouco economiza até o dia em que a investigação precisa do trace que foi descartado.
O projeto desenha a política por tipo de carga. Transação financeira, fluxo de autenticação e operação sujeita a obrigação regulatória pedem cobertura completa, enquanto tráfego de rotina, verificação de saúde e requisição estática aceitam redução agressiva sem prejuízo de análise. Em sistemas críticos, o sampling tail-based é geralmente preferido, porque decide o que preservar depois de conhecer o resultado da transação e mantém erro e latência elevada na amostra.
O Grail sustenta a outra ponta dessa conta, retendo logs, métricas, traces e eventos em volume massivo, com períodos de retenção que variam conforme o tipo de dado e a configuração adotada, com consulta rápida sobre todo o histórico. Organizações que precisam reconstituir um incidente meses depois tratam essa retenção como política de governança do próprio dado, decidida no projeto, e não como configuração deixada para o fim.
O Dynatrace Query Language, ou DQL, é a linguagem que permite fazer perguntas exploratórias a esses dados. A consulta não precisa ter sido prevista no momento da coleta, e essa propriedade é o que separa observabilidade de monitoramento.
A equipe revisa a política de amostragem em ciclos definidos, e essa revisão faz parte do projeto. Volume de tráfego muda, sistemas novos entram e regras que faziam sentido na onda 1 deixam de fazer na onda 4.
Para o gerente de infraestrutura e para o CIO, essa revisão é o instrumento de controle de custo. O consumo passa a ser resultado de decisão declarada, com dono e data, em vez de consequência silenciosa do crescimento do ambiente.
Desenhar essa política exige conhecer o comportamento real do tráfego, e poucos ambientes têm esse retrato pronto antes da primeira onda. A Rike IS acompanha essa decisão junto com a equipe de operações do cliente, no ritmo em que os dados aparecem.
Capacitação da equipe em paralelo à implantação
A curva de aprendizagem da equipe é o item mais subestimado de um projeto de implantação. Plataforma instalada e equipe sem prática produz painel bonito e operação inalterada.
A capacitação acontece em paralelo às ondas, e não depois delas. O time que acompanha a instrumentação do próprio sistema aprende sobre o ambiente que já conhece, o que encurta o caminho entre treinamento e uso real.
Cada perfil precisa de um recorte diferente do produto. A equipe de operações precisa dominar a leitura do problema priorizado e o caminho até a causa raiz. O time de aplicação precisa entender instrumentação, atributos e o efeito de cada implantação sobre a própria métrica. A área de dados e a de segurança precisam de consulta em DQL para responder às próprias perguntas sem depender de terceiros.
Instrumentação são as câmeras instaladas na fábrica. Instalar o equipamento é a parte simples, e o valor aparece quando existe alguém treinado para olhar a imagem e agir sobre o que ela mostra.
O que pertence a este projeto é a decisão de quem participa de cada onda. Envolver o time dono do sistema desde a instrumentação transfere conhecimento por prática, e reduz a dependência externa que costuma aparecer no terceiro mês de operação.
A escolha de quem conduz o projeto pesa aqui. Um parceiro que executa a instrumentação sem transferir método deixa a equipe interna dependente, e essa dependência aparece exatamente quando o contrato de projeto termina.
Como medir o sucesso do projeto
Sucesso de projeto de implantação se mede com indicadores definidos antes da primeira instalação. A avaliação inicial registra a linha de base, e cada onda compara o estado atual com aquele ponto de partida. Cinco indicadores sustentam essa avaliação, e cada um responde a um público diferente.
O primeiro é o tempo médio de resolução, ou MTTR, medido sobre incidentes comparáveis. A queda desse número é o efeito mais direto da análise causal aplicada sobre o mapa de dependências.
O segundo é a cobertura de instrumentação, expressa como proporção dos sistemas críticos com telemetria ativa e conforme a convenção de atributos. Cobertura parcial com convenção quebrada conta menos do que parece, e a cobertura também tem profundidade: sistema instrumentado por dentro, sem Digital Experience Monitoring, ou DEM, que mede o que o usuário final percebe na tela, deixa um lado do fluxo sem medição.
O terceiro é a razão entre alertas recebidos e problemas reais. Plantão que recebe uma enxurrada de eventos para um único incidente ainda opera no modelo antigo, mesmo com a plataforma instalada.
O quarto é o cumprimento dos Service Level Objectives, ou SLOs, medidos pelos Service Level Indicators, ou SLIs, que a equipe definiu para cada sistema crítico. O consumo do orçamento de erro passa a ser dado observável, e não estimativa de fim de trimestre.
O quinto é a previsibilidade de custo de ingestão, comparando o consumo projetado no roadmap com o realizado a cada onda.
Esses cinco indicadores conversam com os quatro públicos do projeto. O executivo lê risco e retorno, o gerente de infraestrutura lê custo e capacidade, o time de DevOps lê efeito de implantação e o SRE lê causa raiz e orçamento de erro. Um projeto que melhora apenas um desses indicadores cobriu uma dimensão e deixou as outras onde estavam.
Há ainda um critério qualitativo que nenhum painel mostra. A equipe deixou de descobrir indisponibilidade pelo canal de atendimento ao cliente, e passou a descobrir pelo próprio sistema de detecção, antes que o usuário perceba. Essa diferença separa equipes que apagam incêndios das que previnem incêndios.
Perguntas frequentes
É preciso parar o sistema para instrumentar na onda 1?
A resposta muda por sistema, e o plano da onda precisa trazê-la antes da janela. O time dono da aplicação conhece o ciclo de publicação e sabe qual janela absorve reinício de processo sem impacto para o negócio. Projeto que trata esse ponto como detalhe de execução costuma descobrir a restrição no dia da instalação, com o escopo já comprometido.
Quando o modelo híbrido entre OneAgent e OpenTelemetry não compensa?
O híbrido é o desenho mais comum, e não é obrigatório. Ambiente homogêneo, inteiramente alcançado pelo OneAgent, não ganha nada em manter também um Collector para operar, atualizar e monitorar. O híbrido compensa quando existe carga fora do alcance do agente, ou quando a organização já mantém instrumentação em OpenTelemetry e não quer descartá-la. O critério é a lacuna real de cobertura, em vez da preferência por padrão aberto.
Governança de atributos e política de amostragem são a mesma decisão?
São decisões vizinhas e distintas. Governança de atributos define o que cada sinal significa: como o serviço se chama, que campos acompanham o dado e o que fica de fora por alta variabilidade. Política de amostragem define quanto desse sinal chega à plataforma. Confundir as duas produz um erro caro no início do projeto: apertar a amostragem para conter custo quando o problema real é atributo mal nomeado, que multiplica série temporal sem acrescentar diagnóstico.
O que fazer quando o time dono do sistema não consegue participar da onda?
Adiar a onda é preferível a executá-la sem o time. Cobertura instalada sem quem opera o sistema produz painel que ninguém reconhece e alerta que ninguém confia, e o retrabalho aparece na primeira madrugada de plantão. Quando a agenda não abre, a saída é reduzir o escopo da onda ao que aquele time consegue validar, em vez de manter o escopo e dispensar a validação.
O que acontece com o histórico anterior à primeira instrumentação?
A plataforma não recupera o histórico anterior à instrumentação. A visibilidade começa no momento em que o agente passa a reportar. A linha de base do projeto se apoia no registro feito na avaliação inicial, com o que a operação já tinha em mãos. Organizações que contam com comparação retroativa perdem a primeira janela de medição e só conseguem demonstrar efeito a partir da onda seguinte.
A parte difícil de um projeto de implantação está nas decisões que precedem o comando de instalação, e quem precisa tomá-las quase nunca tem, naquele momento, o retrato do próprio ambiente. A Rike IS começa pelo diagnóstico, sustenta cada onda até a validação com o time dono do sistema e transfere o método antes de sair, com consultoria, implantação, treinamento e governança de performance continuada sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o ambiente real do seu projeto para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações