

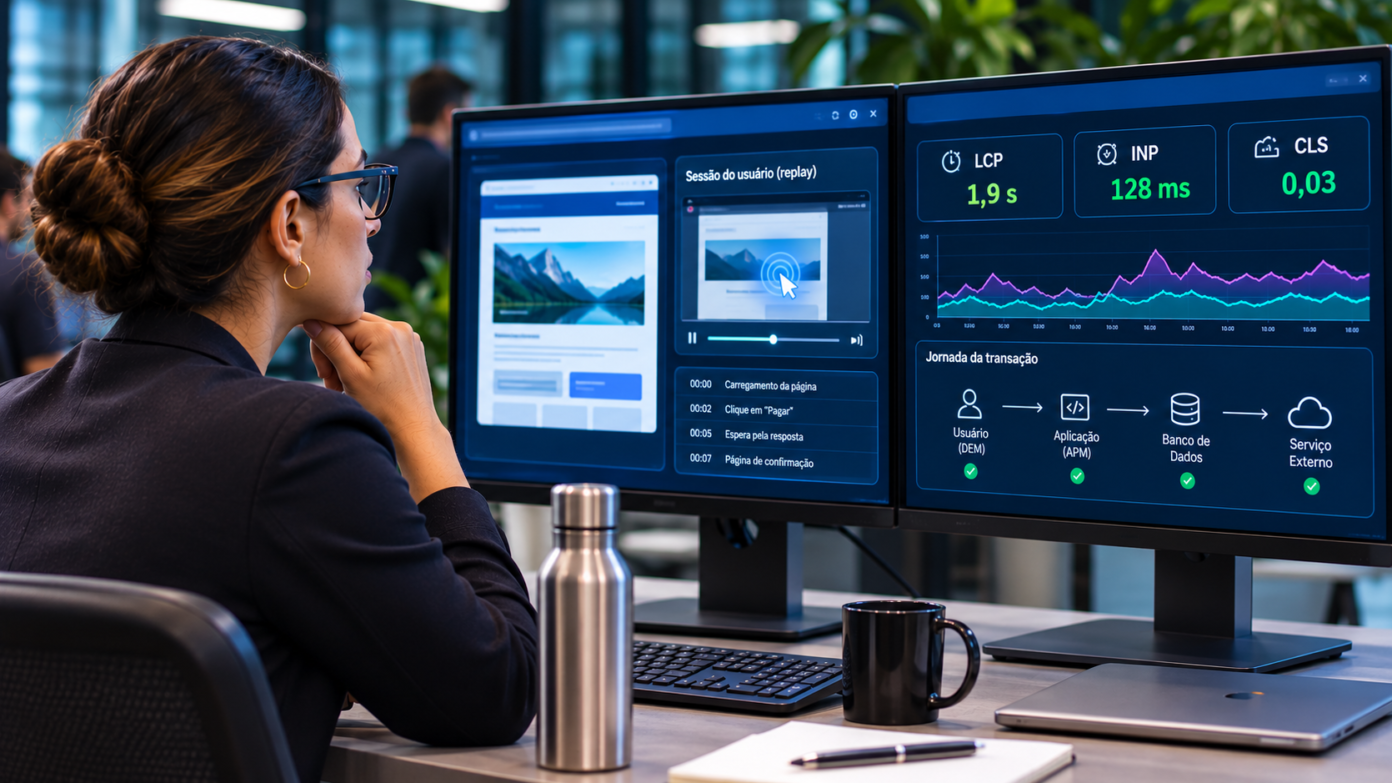
Digital Experience Monitoring, ou DEM, mede o comportamento de aplicações a partir do dispositivo do usuário, capturando tempo vivido, erro no lado do cliente e contexto de acesso. A disciplina combina monitoramento de usuário real e monitoramento sintético, e a implantação segue quatro etapas em ordem: mapear fluxos críticos, definir sucesso, instrumentar as duas vias juntas e acordar a governança de atributos.
O servidor responde dentro do previsto e o usuário reclama assim mesmo. A causa é o tempo que separa a resposta da tela utilizável, acumulado em camadas que a organização não controla, e sem medição na ponta ela sequer enxerga essas camadas.
Digital Experience Monitoring, ou DEM, é a disciplina de observabilidade que mede o desempenho e a confiabilidade de um sistema no ponto em que ele é efetivamente usado: o navegador, o aplicativo móvel, a rede e o dispositivo do usuário final. DEM trata a percepção de quem usa como dado de operação, com o mesmo rigor aplicado a indicadores de servidor.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte que operam sistemas críticos.
O que é Digital Experience Monitoring
DEM se define pelo ponto de coleta, não pelo tipo de gráfico que produz. O dado nasce no dispositivo de quem usa o sistema e viaja até a plataforma de observabilidade, que o correlaciona com o que aconteceu do lado do servidor no mesmo instante. Essa correlação transforma uma reclamação vaga em evidência técnica.
A disciplina captura três famílias de sinal, e cada uma responde a uma pergunta diferente.
A primeira família é de tempo: quanto demorou até o conteúdo aparecer, até a interface aceitar interação e até a operação ser concluída do começo ao fim. São medidas de espera vivida, contadas no relógio do usuário.
A segunda é de erro no lado do cliente. Exceção de código de interface, requisição rejeitada, recurso que não carregou, sessão interrompida no meio de um preenchimento. Boa parte desses eventos nunca chega ao registro do servidor, porque a chamada não chegou a sair do dispositivo.
A terceira é de contexto: região, operadora, tipo de conexão, sistema operacional, versão do aplicativo e modelo de aparelho. Sem contexto, um tempo médio alto é um número solto. Com contexto, ele vira a informação de que uma versão específica do aplicativo degradou em uma região específica depois de uma implantação específica.
Existe ainda um recurso que atravessa as três famílias: o session replay, gravação da sequência de eventos de uma sessão real, que permite reconstituir o que a pessoa viu e tentou fazer antes do erro. Ele não substitui a métrica, e sim a explica quando o número sozinho não diz o que houve.
Para o CIO e o CTO, medir tempo, erro de cliente e contexto muda a natureza da conversa. A área deixa de reportar disponibilidade de componente e passa a reportar operações concluídas por usuários reais, que é a unidade que o conselho entende e que se converte em risco e em receita.
DEM e Application Performance Monitoring: o que cada um responde
A confusão mais frequente na adoção de DEM é tratá-lo como sinônimo de Application Performance Monitoring, o APM. As duas disciplinas observam o mesmo sistema de posições opostas, e nenhuma cobre o território da outra.
APM olha a aplicação por dentro. Mede latência de transação, consumo de recurso, comportamento de dependência externa e o caminho da requisição entre serviços, e a pergunta que responde é onde o tempo foi consumido dentro do que a organização controla.
DEM olha a aplicação por fora. A disciplina mede o que a pessoa enfrentou até obter, ou não obter, o resultado que buscava, e a pergunta que responde é se a operação funcionou para quem dependia dela.
Em vez de escolher entre as duas, operações maduras encadeiam uma na outra. O sinal de DEM aponta uma mudança: a conclusão de um pagamento passou a demorar para usuários de uma região. O trace de APM mostra que a demora está em uma consulta de banco acionada por um serviço de autorização. Um dado sem o outro produz diagnóstico incompleto ou investigação longa demais.
Na plataforma Dynatrace, esse encadeamento não depende de exportar dados de um lugar para outro. O OneAgent, agente unificado que descobre os componentes da stack sem cadastro manual, instrumenta aplicação e infraestrutura, enquanto a captura de experiência do usuário alimenta o mesmo repositório. Esse repositório é o Grail, que retém dados por períodos que variam conforme o tipo de dado e a configuração adotada, com consulta rápida sobre todo o histórico, e o Dynatrace Query Language, ou DQL, é a linguagem que a equipe de operações usa para interrogá-lo.
O Davis, que dentro do Dynatrace Intelligence é responsável pela análise causal, usa o mapa de dependências em tempo real do Smartscape para ligar o sintoma percebido ao componente que o originou. Essa inferência automática é a aplicação prática de Artificial Intelligence for IT Operations, ou AIOps. IA causal opera como o médico que diagnostica, enquanto o dashboard é apenas o termômetro.
Para o Site Reliability Engineer, ou SRE, essa ligação encurta o passo mais caro do plantão. O tempo médio de resolução costuma ser consumido não na correção, mas na etapa anterior, quando a equipe ainda discute qual das dezenas de anomalias simultâneas é a causa raiz.
Monitoramento de usuário real
O Real User Monitoring, ou RUM, o monitoramento de usuário real, coleta dados de sessões que aconteceram de fato. Um trecho de código injetado na aplicação registra tempos, erros e contexto de cada acesso e envia esses eventos para a plataforma de observabilidade.
A fidelidade é a vantagem central. Nada é simulado: o tempo registrado é o tempo que uma pessoa esperou, no aparelho que ela tem, na conexão que ela usa, no horário em que ela precisou do sistema. Nenhuma estimativa de laboratório reproduz essa combinação com precisão suficiente para servir de base de decisão.
A limitação é de cobertura, e ela é estrutural. O RUM só enxerga o que alguém percorreu, e um fluxo pouco usado pode ficar quebrado por semanas sem gerar um único evento. Em horário de baixo tráfego, a ausência de dados se confunde com ausência de problema.
Há também uma decisão de leitura que muda o significado de qualquer indicador de RUM: média ou percentil. A média dilui a cauda lenta e produz painel saudável enquanto uma fatia relevante da população enfrenta tempo inaceitável. O percentil preserva justamente esse grupo, que é o que abre chamado e abandona a operação.
Para o gerente de infraestrutura, o RUM tem efeito direto sobre decisão de capacidade. Descobrir que a degradação atinge uma região e não a totalidade da base evita expansão de infraestrutura central que não resolveria o problema e ainda elevaria o custo recorrente.
Monitoramento sintético
O monitoramento sintético executa, em intervalos regulares e a partir de localidades definidas, um roteiro que percorre um fluxo crítico do começo ao fim. O roteiro autentica, navega, preenche e confirma, como faria uma pessoa, e registra o resultado de cada etapa.
Ele cobre exatamente a lacuna que o RUM deixa: verifica o fluxo sem depender de alguém estar acessando, detecta indisponibilidade de madrugada e testa de várias praças mesmo que naquele momento não haja usuário em nenhuma delas. A linha de base que produz é estável, porque as condições do teste são controladas e repetidas.
Dois usos tornam o sintético a escolha correta.
O primeiro é vigilância de fluxo crítico de baixa frequência. Uma operação de fechamento contábil, um serviço público sazonal ou um canal de contingência precisam funcionar no dia em que forem acionados, e o sintético é o único jeito de saber disso antes da hora.
O segundo é validação de mudança. Um roteiro executado logo após uma implantação confirma, em minutos, que os fluxos principais continuam íntegros, e a reversão acontece antes de a reclamação chegar ao atendimento.
Para o profissional de DevOps, esse segundo uso é o mais imediato. O roteiro sintético vira critério de bloqueio na esteira de entrega: a mudança só avança para a etapa seguinte se o fluxo de negócio continuar concluindo dentro do tempo acordado.
A regra prática de combinação é simples de enunciar. O sintético dá o alarme e a linha de base, e o monitoramento de usuário real explica o que a população enfrentou e permite segmentar por região, dispositivo e versão. Operações que adotam apenas um dos dois acabam descobrindo a falta do outro durante um incidente, que é o pior momento possível para essa descoberta.
Definir quais fluxos merecem roteiro sintético, com qual frequência e a partir de quais localidades, é uma decisão de arquitetura, não uma configuração de tela. A Rike IS conduz esse desenho junto com a equipe de operações do cliente, partindo dos fluxos que sustentam o negócio e não do que é mais fácil instrumentar.
Como implantar DEM
A implantação de DEM falha por excesso de ambição com muito mais frequência do que por limitação técnica. A tentação é instrumentar tudo de uma vez, gerar volume enorme de dados e descobrir depois que ninguém consegue extrair decisão daquele conjunto. Existem quatro etapas em ordem, e a ordem importa tanto quanto o conteúdo de cada uma.
A primeira etapa é mapear os fluxos que sustentam o negócio. Não a lista de aplicações, e sim a lista de operações cuja falha tem consequência imediata: emitir a guia, aprovar o crédito, concluir o pagamento, registrar a solicitação. Uma organização de grande porte costuma ter um punhado dessas operações, mesmo quando mantém um parque de sistemas muito maior. O recorte por operação de negócio impede o projeto de virar coleta indiscriminada.
A segunda etapa é definir o que significa sucesso em cada fluxo, antes de coletar qualquer dado. Tempo aceitável para concluir, taxa de erro tolerada, população mínima que precisa estar coberta. Sem esse acordo prévio, o painel vira exercício de interpretação e cada área lê o mesmo número de um jeito.
A terceira etapa é instrumentar, com o monitoramento de usuário real e o sintético entrando juntos, não em sequência. O RUM cobre a percepção da população, o sintético cobre a vigilância do fluxo, e instrumentar apenas um deles na primeira onda cria um ponto cego que só aparece meses depois.
A quarta etapa é governança de atributos. Cada evento capturado carrega dimensões como região, versão, canal e tipo de usuário, e essas dimensões precisam de nomenclatura acordada desde o início. Atributo criado ao acaso por cada time gera cardinality alta, custo de armazenamento crescente e consulta que ninguém consegue reproduzir.
O atributo que mais falta no primeiro desenho não é técnico: é o identificador do canal de atendimento. Sem ele, a área de negócio não consegue separar o que aconteceu no aplicativo do que aconteceu no portal. Corrigir nomenclatura depois de meses de coleta é caro e costuma exigir reprocessamento.
Uma advertência sobre sequência, porque ela custa retrabalho. Cobertura total não é o objetivo da primeira fase, e sim consequência da segunda. Instrumentar os fluxos críticos, estabelecer a linha de base e só então expandir produz um projeto que entrega decisão logo na primeira onda, em vez de só depois de o parque inteiro estar coberto.
Para o SRE, essa ordem tem efeito direto sobre o orçamento de erro, que define quanto de degradação um serviço pode acumular antes de a equipe congelar as mudanças. Um orçamento definido sobre indicador de servidor mede a saúde do componente. Definido sobre conclusão de fluxo medido na ponta, mede o que o usuário efetivamente perdeu.
Nenhuma dessas quatro etapas é decisão de tela, e nenhuma delas sobrevive a um desenho feito longe de quem opera o plantão. Por isso a Rike IS começa pelo inventário do que a organização já mede hoje, antes de propor qualquer coleta nova.
O que o DEM entrega por setor
A ênfase do DEM muda conforme o setor, e a diferença aparece em qual das duas vias de medição carrega o peso da prova.
Em instituições financeiras, o monitoramento sintético a partir de várias localidades produz a evidência de disponibilidade do canal, e o monitoramento de usuário real produz a evidência do que a população enfrentou. Um comprova o compromisso assumido, o outro comprova o resultado entregue. Em cooperativas, a mesma combinação sustenta a comparação objetiva entre praças que a governança cooperativa exige.
Em órgãos públicos, o peso migra para a segmentação do RUM por dispositivo e por tipo de conexão. Uma página que carrega bem em aparelho recente e trava em modelo popular exclui exatamente a população que mais depende do canal digital, e nenhum roteiro sintético executado em equipamento padronizado revela isso. Em empresas privadas de grande porte, o foco recai sobre a taxa de conclusão por etapa, porque a degradação silenciosa de uma etapa de compra se converte em receita perdida sem gerar alerta de infraestrutura.
O que os quatro setores têm em comum é a exigência de ligar o sintoma percebido à causa técnica sem troca de ferramenta e sem reunião de correlação manual. Essa ligação é o que separa medir experiência de governar experiência.
Perguntas frequentes
O que fazer quando o sintético indica normalidade e os usuários continuam reclamando?
Divergência entre roteiro sintético verde e reclamação real quase sempre aponta para uma condição que o roteiro não reproduz. O roteiro roda de uma localidade escolhida, com credencial de teste, aparelho padronizado e cache limpo, e nenhuma dessas condições descreve a população. O caminho é segmentar o dado de usuário real por região, operadora, versão e modelo até isolar o grupo afetado, e só então ajustar o roteiro para cobrir aquela condição. Enquanto o roteiro não reproduzir o cenário do grupo afetado, ele continuará dando verde sobre um problema existente.
Monitoramento sintético é a mesma coisa que teste de carga?
Não, e confundir os dois leva a dimensionar errado as duas coisas. O teste de carga verifica se o sistema aguenta um volume, roda em janela combinada e costuma acontecer antes da entrada em produção. O monitoramento sintético verifica se o fluxo conclui, roda de forma contínua em produção e trabalha com volume baixo justamente para não perturbar o ambiente. Um responde quanto o sistema suporta, o outro responde se o sistema está entregando agora.
Session replay pode ser ligado em aplicação que trata dado pessoal?
Pode, desde que o mascaramento aconteça na origem, antes de o evento sair do dispositivo. Campo de senha, documento, dado de cartão e conteúdo de formulário aberto precisam de regra explícita de supressão, definida junto com a área de privacidade e não herdada do padrão de instalação. A decisão também é de escopo: gravar todas as sessões de todos os fluxos amplia a superfície de risco sem ampliar na mesma proporção a capacidade de diagnóstico. Em ambiente crítico, a prática mais defensável é habilitar a gravação apenas nos fluxos que já demonstraram erro difícil de reproduzir.
DEM serve para integração entre sistemas, sem interface gráfica?
Não da forma como serve para canal digital, e esse limite precisa ficar claro antes do desenho. O ponto de coleta do DEM é o dispositivo do usuário final, e integração entre parceiros por interface de programação não tem esse ponto. O que cobre esse caso é o monitoramento sintético de chamada de serviço, que executa a requisição em intervalos regulares e verifica resposta e conteúdo. Do lado de quem expõe a interface, o APM completa a leitura. A pergunta que orienta a escolha continua sendo quem espera pela resposta: se do outro lado há uma pessoa, o DEM se aplica.
Quanto tempo de histórico de dado de experiência vale manter?
A resposta depende do uso, e separar os usos evita pagar retenção longa para dado que ninguém volta a consultar. Investigação de incidente consome janela curta e detalhe máximo, incluindo sessão individual e contexto de dispositivo. Comparação de linha de base entre versões e demonstração de compromisso de nível de serviço consomem janela longa, porém em dado agregado por fluxo, região e canal. Definir as duas janelas antes da primeira coleta é mais barato que descobrir, meses depois, que o detalhe necessário já expirou ou que o agregado nunca foi calculado.
Implantar Digital Experience Monitoring em sistemas críticos exige diagnóstico, desenho de fluxos, instrumentação correta e operação contínua depois que o projeto sai do ar de novidade. A Rike IS conduz essa implantação sobre a plataforma Dynatrace, com consultoria, treinamento e governança de performance continuada, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve os fluxos críticos do seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações