

Garantir disponibilidade de sistema em ambiente crítico começa por declarar o SLO e o orçamento de erro que dele deriva. Sobre esse alvo se encadeiam cinco práticas: redundância com failover testado, capacidade validada sob carga, detecção de desvio antes do impacto, resposta com procedimento escrito e governança contínua do desenho.
Garantir disponibilidade em ambiente crítico não é resultado de uma decisão de compra. É consequência de práticas encadeadas, cada uma cobrindo uma falha que as outras não cobrem, e todas medidas contra um alvo declarado antes da primeira instalação.
O erro de sequência mais comum é começar pela ferramenta antes de definir o compromisso que ela deve sustentar. Sem esse compromisso, não existe critério para dizer se a redundância implantada é suficiente ou se o alerta configurado chega cedo o bastante.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
Antes das práticas: definir o número
Nenhuma prática de disponibilidade pode ser avaliada sem um alvo declarado. Isso parece óbvio e é ignorado com regularidade. Equipes implantam redundância, ajustam alertas e escrevem procedimentos sem que exista um número acordado sobre o que se considera aceitável, e nesse cenário toda discussão sobre suficiência se torna subjetiva.
O instrumento que resolve isso é o Service Level Objective, ou SLO, o objetivo interno de disponibilidade, normalmente mais rígido que o compromisso externo assumido em contrato.
Do SLO deriva o orçamento de erro, a margem de indisponibilidade tolerada no período. Se o objetivo mensal é 99,9%, a equipe dispõe de cerca de 43,8 minutos de indisponibilidade tolerada no mês. Enquanto esse orçamento não se esgota, a entrega de novas funcionalidades segue em ritmo normal.
Quando se esgota, a prioridade muda sem negociação. Esse mecanismo substitui a discussão recorrente entre velocidade de entrega e estabilidade por um número compartilhado, e é o que torna as práticas seguintes mensuráveis. Para o CIO, o CTO e o CEO, é também o que permite levar disponibilidade ao conselho como compromisso, e não como impressão sobre o último trimestre.
O Service Level Indicator, ou SLI, é o dado efetivamente medido, e a escolha dele muda o resultado. Medir disponibilidade pela resposta do servidor produz número diferente de medir pela conclusão da transação de negócio, e apenas o segundo corresponde ao que o usuário obteve.
Redundância e failover
A primeira prática ataca o ponto único de falha, aquele componente cuja indisponibilidade derruba o serviço inteiro.
Redundância significa manter mais de uma instância capaz de atender. Failover é o mecanismo que desloca a carga para a instância sadia quando uma delas para de responder.
Há uma distinção prática entre os dois que costuma custar caro. Redundância sem failover testado é redundância no papel: existe uma segunda instância, e ninguém verificou se a transferência de carga acontece sem intervenção manual.
O escopo da redundância precisa cobrir todas as camadas, e não apenas a aplicação. Banco de dados, fila, cache, balanceador, autenticação e resolução de nomes são candidatos a ponto único, e cada um exige tratamento próprio.
Existe um limite a registrar. Redundância eleva custo de forma proporcional, e nem todo sistema justifica duplicar toda a infraestrutura. A decisão sobre onde investir decorre do SLO definido na etapa anterior, e não de uma aspiração genérica de alta disponibilidade.
Redundância mal desenhada introduz problemas próprios. Duas instâncias que compartilham o mesmo banco continuam com ponto único, e a percepção de segurança que a duplicação transmite pode atrasar a correção do gargalo real.
Capacidade e teste de carga
A segunda prática trata do limite do sistema, e da escolha entre descobri-lo em teste ou em produção.
Capacidade não se avalia pelo consumo médio. O que importa é o comportamento no pico, e o pico costuma ser concentrado: prazo de tributo, campanha promocional, período de matrícula, fechamento contábil.
Teste de carga é o instrumento que antecipa esse cenário. Ele submete o ambiente a volume superior ao esperado e revela qual componente cede primeiro, informação que nenhum indicador de operação normal fornece.
O resultado útil de um teste de carga não é apenas o número máximo suportado. É a identificação da sequência de saturação: qual recurso satura antes, o que ele arrasta consigo, e em que ponto a degradação deixa de ser gradual.
Em ambientes com autoescala, o teste precisa validar também o tempo de reação. Um mecanismo que adiciona capacidade em minutos não protege contra um pico que se forma em segundos, e essa defasagem só aparece sob carga controlada.
Previsão de capacidade complementa o teste. Observar a tendência real de consumo ao longo de meses permite antecipar quando o limite será alcançado, e trocar decisão emergencial por planejamento. Para o gerente de infraestrutura, essa série histórica é o que transforma pedido de expansão em argumento com data projetada de saturação.
Detecção precoce de desvio
A terceira prática é a que mais afeta o indicador de disponibilidade, porque atua no intervalo entre a falha começar e alguém perceber.
O modelo tradicional configura alerta por limiar fixo. Estabelece-se um valor de processador, de memória ou de tempo de resposta, e o alarme dispara quando o valor é rompido.
Esse arranjo tem duas limitações em ambiente moderno. A primeira é que o comportamento normal varia ao longo do dia, e um limiar que evita alarme falso no horário de pico ignora anomalia real na madrugada. A segunda é que o alerta por limiar só cobre a falha prevista, e quando surge uma degradação de tipo novo, o dado necessário para entendê-la pode não ter sido coletado.
Observabilidade inverte essa lógica. A plataforma aprende o comportamento típico de cada componente e sinaliza desvio em relação a esse comportamento, em vez de aguardar um valor absoluto ser atingido.
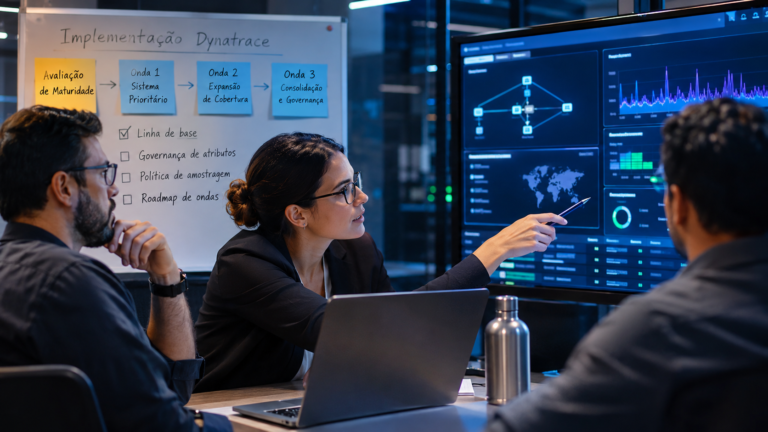
Na plataforma Dynatrace, o OneAgent descobre a stack em execução sem configuração manual por componente e alimenta o Smartscape, o mapa de dependências em tempo real. Sobre esse mapa opera o Davis, que dentro do Dynatrace Intelligence é responsável pela análise causal, identificando o evento gerador de uma cadeia de falhas e apresentando um problema priorizado, em vez de dezenas de alertas que descrevem sintomas do mesmo incidente.
Dashboards organizam e tornam exploráveis os sinais operacionais, enquanto a Dynatrace Intelligence complementa essa análise com detecção de anomalias, correlação e investigação causal para reduzir a triagem e orientar a resposta.
Para o Site Reliability Engineer, ou SRE, a diferença aparece no início do plantão. Receber a causa raiz nomeada, e não uma fila de sintomas, é o que impede que o orçamento de erro do mês seja consumido pela fase de investigação.
Resposta estruturada a incidente
A quarta prática reconhece que a falha vai acontecer, e trata do que se faz quando ela acontece.
Resposta estruturada significa que existe um procedimento escrito, e que ele foi escrito antes do incidente. Improvisação sob pressão produz tempo de resolução variável, e variabilidade é o oposto do que um compromisso de disponibilidade exige.
O procedimento precisa cobrir quatro pontos. Quem é acionado e em quanto tempo. Qual a ordem entre estabilizar e diagnosticar. Quem comunica e para quem. E qual o critério para escalar.
A ordem entre estabilizar e diagnosticar merece atenção. Em sistema crítico, restaurar o serviço costuma preceder entender a causa, e isso exige que a mitigação esteja disponível sem depender do diagnóstico completo.
Existe uma consequência que times aprendem depois de alguns incidentes: mitigar antes de diagnosticar pode destruir a evidência. Reiniciar um componente resolve o sintoma e apaga o estado que explicaria a causa. É por isso que a retenção de telemetria é parte do procedimento, e não detalhe de arquitetura. O Grail retém logs, métricas, traces e eventos em volume massivo, com períodos de retenção que variam conforme o tipo de dado e a configuração adotada, mantendo consulta rápida sobre todo o histórico, e o Dynatrace Query Language, ou DQL, é a linguagem que reconstrói o incidente depois que o componente já foi reiniciado.
O procedimento termina em análise posterior sem atribuição de culpa. O objetivo é extrair a correção estrutural, e um processo que busca responsável produz relato incompleto na próxima ocorrência. Para o profissional de DevOps, essa análise é o que liga a degradação à versão que subiu, tornando a reversão uma operação de esteira e não de emergência.
Governança contínua
A quinta prática é a que sustenta as quatro anteriores ao longo do tempo, e é também a mais negligenciada.
Ambientes mudam. Serviços são adicionados, dependências são trocadas, volumes crescem, equipes se renovam. Um desenho de disponibilidade adequado no primeiro trimestre pode estar defasado no terceiro sem que nada tenha falhado ainda.
Governança de performance significa revisar periodicamente três coisas. Se o SLO continua adequado ao que o negócio precisa. Se o SLI continua medindo o que importa. E se as práticas implantadas continuam cobrindo o ambiente que existe hoje.
Existe uma dimensão de dado nessa governança que costuma ser subestimada. Convenção de nomes e de atributos se degrada quando muitas equipes instrumentam sem padrão comum, e a análise causal opera sobre a consistência desse dado.
Quando o mesmo serviço aparece com identificações diferentes em contextos diferentes, os painéis fragmentam e o diagnóstico perde precisão. Corrigir isso depois de o dado estar em produção custa reprocessamento, e é por isso que a governança de atributos entra no início e não no fim.
O que costuma faltar nos planos de disponibilidade
Planos bem escritos falham por omissões recorrentes, e três delas aparecem com frequência suficiente para merecer verificação explícita.
A primeira omissão é a dependência externa. O plano cobre a infraestrutura própria e ignora que um serviço de terceiro pode degradar sem ficar indisponível. Dependência lenta consome conexões e threads do lado que chama, e uma degradação moderada no fornecedor pode esgotar recurso interno e produzir indisponibilidade ampla.
A segunda omissão é a experiência do usuário. Indicadores de infraestrutura podem permanecer saudáveis enquanto uma operação específica falha para parte da população, por região, por dispositivo ou por versão de aplicativo. Disponibilidade medida apenas no servidor não captura esse recorte.
A terceira omissão é o teste do próprio mecanismo de recuperação. Failover configurado e nunca exercitado costuma revelar problema justamente no momento em que precisa funcionar, e a verificação periódica dessa transferência é parte da prática, não zelo excessivo.
Há um padrão comum às três. Todas decorrem de tratar disponibilidade como propriedade da infraestrutura, quando ela é propriedade do serviço que o usuário tenta usar.
Como validar que o desenho funciona
Todas as práticas descritas até aqui compartilham um risco: existir na configuração e não funcionar no momento necessário. Validação periódica é o que separa desenho documentado de desenho operante, e ela se aplica a quatro pontos, cada um com um tipo de exercício diferente.
O primeiro ponto é a transferência de carga. Interromper deliberadamente uma instância, em janela controlada, e verificar se o failover ocorre sem intervenção manual e dentro do tempo esperado.
O segundo ponto é a restauração de dados. Backup cuja restauração nunca foi exercitada tem valor incerto, e o tempo real de recuperação costuma ser maior que o estimado.
O terceiro ponto é o procedimento de incidente. Conduzir um exercício com a equipe de plantão revela lacunas de contato, de permissão e de acesso que o documento não expõe.
O quarto ponto é a própria detecção. Injetar uma degradação conhecida e verificar se o alerta chega, em quanto tempo e com que informação, valida a cadeia inteira de observabilidade.
Existe um ganho secundário nesses exercícios. Eles produzem a linha de base de tempo de recuperação que o compromisso de disponibilidade pressupõe, substituindo estimativa por medição.
A ordem importa: exercitar em ambiente de homologação antes de exercitar em produção, e nunca durante período de pico previsto.
Exercitar tudo de uma vez costuma ser inviável em operação real. A prática sustentável é rotacionar os quatro pontos ao longo do ano, de modo que cada um seja validado ao menos uma vez e nenhum exercício concentre risco excessivo em uma única janela.
Perguntas frequentes
Como garantir disponibilidade de sistema em ambiente crítico?
Declarando primeiro o SLO e o orçamento de erro que dele deriva, e encadeando cinco práticas sobre esse alvo: redundância com failover testado, capacidade validada por teste de carga, detecção de desvio de comportamento antes do impacto, resposta com procedimento escrito previamente e governança contínua do desenho.
Por que definir o SLO antes de implantar as práticas?
Porque sem alvo declarado não há como avaliar se uma prática é suficiente. O SLO também origina o orçamento de erro, que governa objetivamente a prioridade entre entregar novidade e estabilizar o serviço.
Redundância garante alta disponibilidade?
Não por si só. Redundância sem failover exercitado é duplicação no papel, e duas instâncias que compartilham o mesmo banco de dados mantêm o ponto único de falha que a duplicação pretendia eliminar.
Qual a diferença entre alerta por limiar e detecção de desvio?
Alerta por limiar dispara quando um valor absoluto é rompido, e falha em ambiente com sazonalidade e autoescala. Detecção de desvio compara o comportamento atual com o comportamento aprendido do componente, e alcança também a falha que ninguém previu.
Com que frequência revisar o plano de disponibilidade?
Periodicamente e sempre que o ambiente mudar de forma relevante. Serviço novo, troca de dependência ou crescimento significativo de volume alteram as premissas do desenho original, mesmo que nenhuma falha tenha ocorrido.
Sustentar disponibilidade em ambiente de alta complexidade exige SLO acordado com a área de negócio, práticas exercitadas em janela controlada e operação continuada depois da entrega. A Rike IS conduz esse trabalho do diagnóstico inicial à governança de performance continuada sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o desenho de disponibilidade do seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações