

Observabilidade no setor financeiro entrega dois resultados sob regulação: latência consistente em cada transação de negócio e trilha auditável capaz de reconstituir qualquer ação de qualquer sistema em qualquer momento retido. Banco Central e LGPD são as duas origens de obrigação, e nenhuma delas se atende com visão fragmentada por ferramenta.
Bancos, cooperativas de crédito, adquirentes e instituições de pagamento operam sob escrutínio permanente de reguladores, de auditoria interna e do próprio correntista, que percebe a degradação antes de qualquer relatório chegar à mesa do gestor.
Observabilidade no setor financeiro é a disciplina que dá a uma instituição visibilidade completa sobre aplicações, infraestrutura, cloud e experiência do usuário em sistemas distribuídos. No ambiente regulado, essa visibilidade precisa entregar dois resultados concretos: latência consistente em cada transação de negócio e trilha auditável completa.
O Banco Central é a referência quando o assunto é resiliência operacional. A Lei Geral de Proteção de Dados, ou LGPD, é a referência quando o assunto é dado pessoal, em qualquer lugar por onde ele circule, inclusive dentro da telemetria.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
O que torna o sistema financeiro crítico
O sistema financeiro concentra três características que, somadas, elevam o custo de qualquer indisponibilidade. Reconhecer as três em ordem ajuda a dimensionar o projeto antes de escolher qualquer componente técnico.
A primeira é a natureza da transação. Uma transferência instantânea, uma autorização de cartão ou uma consulta de saldo não admite reprocessamento silencioso. Cada operação tem contraparte, horário registrado e efeito financeiro imediato, e uma falha parcial deixa rastro contábil que alguém terá de conciliar depois.
A segunda é a distribuição do fluxo digital. Uma única compra aprovada atravessa aplicativo, gateway de pagamento, antifraude, autorizador, núcleo bancário e sistema de liquidação, com trechos em nuvem pública e trechos em plataforma legada. A latência que o cliente sente é a soma de todos os trechos, e o gargalo raramente está onde a equipe de operações olha primeiro.
A terceira é o escrutínio constante. Auditoria interna, auditoria externa e reguladores pedem evidência, não impressão.
Para o CIO e o CTO, essas três características traduzem risco em linguagem de conselho: indisponibilidade em horário de pico vira receita perdida, exposição regulatória e desgaste de marca no mesmo dia. Para o gerente de infraestrutura, viram exigência de previsão de capacidade em datas conhecidas, como fechamento de folha, vencimento concentrado de boleto e picos sazonais de compra. Os dois perfis pedem o mesmo insumo, em formatos diferentes.
Resultado 1: latência consistente em transação de negócio
Latência consistente significa que a mesma operação de negócio responde dentro do mesmo intervalo, sempre, inclusive no pior momento do dia. A média não descreve essa propriedade.
Uma latência média saudável convive com uma cauda longa que atinge parte relevante dos clientes. Quando a autorização de cartão responde rápido na maioria das tentativas e trava em uma fração delas, a reclamação nasce na fração, e o painel agregado continua verde durante todo o episódio.
Medir por transação de negócio, e não por servidor, é o que revela a cauda.
Application Performance Monitoring, ou APM, mede latência, taxa de erro e volume por operação nomeada, em vez de medir por recurso de infraestrutura. Essa medição separa a lentidão geral do ambiente da degradação específica de autorizar um pagamento ou consultar um extrato. O nome da operação é o vocabulário que negócio e tecnologia compartilham, e é por ele que a conversa sobre prioridade fica objetiva.
Digital Experience Monitoring, ou DEM, cobre a outra ponta da mesma medida. O tempo que o correntista sente inclui rede, aparelho e renderização no aplicativo, trechos que nenhum servidor da instituição registra. Instituição financeira que mede só o lado do servidor costuma descobrir a degradação pelo canal de atendimento, e não pelo painel.
O trace distribuído completa a medida. Ele é o GPS de uma viagem, mostrando cada parada do trajeto, o tempo gasto em cada uma e o ponto exato onde a operação perdeu tempo. Sem ele, a equipe de operações investiga por eliminação, componente a componente, enquanto o relógio do incidente corre.
Definir Service Level Objective, ou SLO, por transação de negócio é o passo seguinte. O SLO fixa o alvo interno, e o Service Level Indicator, ou SLI, é a medida que comprova o alvo. Acima dos dois fica o Service Level Agreement, ou SLA, o compromisso formal assumido com quem consome o serviço. Uma instituição madura mantém alvos distintos para autorização, consulta e transferência, porque o custo de cada segundo perdido é diferente em cada uma delas.
Para o Site Reliability Engineer, ou SRE, o alvo por operação define o orçamento de erro e a prioridade de plantão. Para o profissional de DevOps, define o critério objetivo de aceite de cada implantação: quando a nova versão degrada a operação medida, a reversão tem gatilho e não depende de discussão em reunião.
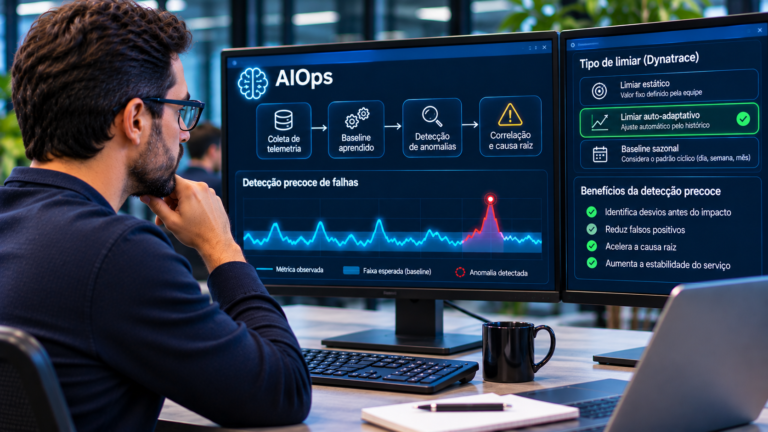
Artificial Intelligence for IT Operations, ou AIOps, fecha o percurso. O Davis, que dentro do Dynatrace Intelligence é responsável pela análise causal da plataforma Dynatrace, correlaciona os sinais sobre o Smartscape, o mapa de dependências em tempo real do ambiente, e nomeia a causa raiz em vez de listar sintomas. A IA causal atua na identificação da causa e do contexto do problema, enquanto os dashboards organizam e tornam exploráveis os sinais operacionais.
Em uma falha em cascata dentro do fluxo de pagamento, nomear a causa raiz encurta de forma expressiva o tempo médio de resolução, ou Mean Time To Repair, MTTR. O ganho vem da triagem que deixa de existir, aquela dos muitos alertas que descrevem sintomas verdadeiros de um único problema. O indicador vizinho é o Mean Time Between Failures, ou MTBF, que mede frequência em vez de duração, e os dois compõem o par que a diretoria de tecnologia acompanha, com a evidência de ambos saindo da mesma telemetria.
Resultado 2: trilha auditável completa
Trilha auditável completa é o registro contínuo que permite reconstituir qualquer ação de qualquer sistema em qualquer momento do período retido. A definição é literal, e cada parte dela carrega uma exigência técnica própria.
Qualquer ação exige granularidade. O registro precisa cobrir requisição, resposta, identificador de correlação, componente que executou e resultado obtido, não apenas o evento agregado que alimentou um painel.
Qualquer sistema exige cobertura sem ponto cego. Um trecho instrumentado ao lado de um trecho sem instrumentação produz trilha com buraco, e o buraco costuma estar exatamente onde a auditoria vai perguntar.
Qualquer momento exige retenção com consulta viável, assunto da próxima seção.
A propagação de contexto é o mecanismo que costura os três requisitos. O identificador de correlação funciona como o carimbo no passaporte: acompanha a transação enquanto ela atravessa serviços, filas e limites entre times, e o mesmo identificador permite reunir depois, em uma consulta única, tudo o que aconteceu com aquela operação específica.
Quando o identificador se perde em um trecho, a trilha se parte em duas metades que ninguém religa.
Instrumentação consistente é a condição para o carimbo sobreviver ao percurso. O OneAgent, agente unificado da plataforma Dynatrace, descobre automaticamente a stack em execução no host, no contêiner ou no ambiente de nuvem, e propaga contexto sem exigir configuração manual por componente. Para cargas onde o agente não se aplica, como funções sem servidor e linguagens de instrumentação automática limitada, o OpenTelemetry, padrão aberto e vendor-neutral da CNCF, entra como caminho complementar dentro do mesmo contexto. OpenTelemetry funciona como o padrão USB-C da telemetria.
O desenho híbrido, com OneAgent onde ele alcança e OpenTelemetry onde não alcança, é o mais comum em instituição financeira, pela própria diversidade do parque tecnológico do setor.
Para o gerente de infraestrutura, a trilha completa substitui estimativa por histórico na conversa de capacidade. Para o CIO, é o que transforma uma frase como “o sistema ficou lento ontem” em relato reconstituível diante de um auditor, com horário, componente e efeito nomeados.
Retenção de longo prazo com consulta
Retenção sem consulta viável produz arquivo morto. O dado existe, a instituição cumpre a obrigação formal de guardá-lo, e recuperá-lo custa dias que uma auditoria ou uma investigação de incidente não têm.
Reter registros por longos períodos é prática consolidada de governança no setor financeiro. A dificuldade está em manter volume, prazo e velocidade de consulta ao mesmo tempo, não no ato de guardar.
O Grail, motor de armazenamento e consulta da plataforma Dynatrace, sustenta essa combinação: retém logs, métricas, traces e eventos em volume massivo, com períodos de retenção que variam conforme o tipo de dado e a configuração adotada, e permite consulta rápida sobre o histórico disponível.
O Dynatrace Query Language, ou DQL, é a linguagem que faz as perguntas. A palavra que carrega o peso aqui é exploratória: a consulta não precisa ter sido prevista no momento em que o dado foi coletado, e auditoria e investigação de incidente vivem justamente da pergunta que ninguém formulou antes.
Essa propriedade separa monitoramento de observabilidade. Monitoramento responde ao que foi perguntado antes do evento, e observabilidade mantém dado rico o suficiente para responder ao que surgiu durante ele.
Responder a uma auditoria com dado de sistema exige três elementos juntos: o registro granular, o identificador que costura a transação inteira e a consulta que atravessa o período inteiro sem restauração de backup. Faltando qualquer um, a resposta vira reconstrução manual, com prazo incerto e margem de erro que ninguém consegue defender.
Estruturar retenção, consulta e evidência em ambiente regulado é decisão de arquitetura, tomada antes da primeira instalação. A Rike IS conduz esse diagnóstico junto das equipes de tecnologia e de risco operacional.
Dados sensíveis e controle de acesso
Telemetria carrega dado pessoal com mais frequência do que as equipes esperam. Um parâmetro de consulta, um cabeçalho de requisição ou uma mensagem de erro capturada por engano coloca número de documento, dado de conta ou identificador de cliente dentro do registro de observabilidade. A LGPD alcança esse dado onde quer que ele esteja, inclusive dentro da plataforma.
Três controles resolvem a maior parte do problema, e os três são decisão de projeto, nunca ajuste posterior. O primeiro é o mascaramento na origem, para que o dado sensível não chegue a ser transmitido. O segundo é o controle de acesso por perfil, que separa quem investiga incidente de quem consulta dado de negócio. O terceiro é a política de retenção diferenciada, que trata registro técnico e registro com dado pessoal em prazos distintos.
Governança de atributos sustenta os três. Convenção de nomenclatura, lista de atributos obrigatórios e regra explícita para campos de alta variabilidade custam pouco quando definidas antes de o código entrar em produção, e custam reprocessamento de histórico quando definidas depois.
Ela produz também um efeito colateral bem-vindo: o mesmo cuidado que mantém dado pessoal fora da telemetria mantém o custo de ingestão previsível, porque campo de alta variabilidade é também o que mais infla volume armazenado.
Para a área de risco operacional, esses controles permitem responder a um questionamento de conformidade sem abrir exceção. Para o SRE, garantem que o acesso rápido ao dado de incidente continue existindo durante o plantão, sem depender de aprovação manual a cada consulta.
Como estruturar o projeto em instituição financeira
A implantação em instituição financeira segue três decisões, e a ordem entre elas pesa mais do que a velocidade de cada uma.
A primeira é a separação de ambientes. Desenvolvimento, homologação e produção precisam de contas, credenciais e escopos de acesso próprios, sem reaproveitamento entre eles. Mistura de contas compromete auditoria, porque apaga o limite entre o que foi apenas testado e o que foi executado sobre dado real de cliente, e corrigir isso depois inclui revisar todo o histórico coletado no período afetado.
A segunda é a ordem de cobertura. Começar pelas transações de negócio de maior impacto, em vez de começar pelo maior número de hosts, entrega evidência utilizável já nas primeiras semanas do projeto. Autorização de pagamento antes de servidor de relatório.
A terceira é a governança contínua. Instrumentação envelhece, atributo novo aparece a cada entrega, e sem revisão periódica a trilha volta a ter buraco, dessa vez sem ninguém perceber. Uma rotina de revisão de atributos, alvos e política de amostragem mantém a plataforma alinhada ao que o ambiente virou, e não ao que ele era no dia da implantação.
A amostragem merece critério próprio no setor financeiro. Sampling, ou amostragem, é a pesquisa eleitoral do dado operacional: observa parte para inferir o todo, e serve bem para tráfego de rotina. Em sistemas críticos, o sampling tail-based é geralmente preferido, porque decide o que preservar depois de conhecer o resultado da transação, mantendo fora da amostra justamente o que a investigação e a auditoria vão procurar depois: erro, latência elevada e transação de negócio sensível.
Para o profissional de DevOps, essas três decisões chegam como critério de aceite dentro da esteira de entrega contínua. O gerente de infraestrutura as lê como previsibilidade de custo de ingestão. Para o CTO, chegam como redução de risco regulatório sem freio na cadência de entrega, que é a única formulação que costuma sobreviver a uma reunião de orçamento.
Perguntas frequentes
Qual a diferença entre trilha auditável de observabilidade e log de auditoria do sistema transacional?
O log de auditoria do sistema transacional guarda o fato de negócio: quem movimentou, quanto, em qual conta e sob qual autorização. A trilha de observabilidade guarda o percurso técnico da mesma operação: por quais componentes ela passou, quanto tempo gastou em cada um e com qual resultado. Um registro não substitui o outro, e a auditoria costuma pedir os dois, porque o primeiro prova o que aconteceu e o segundo explica por que aconteceu daquele jeito.
Como incluir na trilha os trechos que rodam em sistemas de terceiros?
Instrumentando os pontos de entrada e de saída do perímetro da instituição. A requisição enviada, a resposta recebida e o tempo consumido ficam registrados do lado de cá, com o identificador de correlação propagado no cabeçalho quando o parceiro aceita o padrão. Quando o parceiro não aceita, o trecho externo entra na trilha como caixa preta cronometrada, com início, fim e resultado. Evidência do que ocorreu dentro do terceiro é assunto de contrato, não de instrumentação.
Plataforma legada e mainframe entram no mesmo projeto de observabilidade?
Entram, e normalmente por caminho diferente do resto do parque. O trecho legado costuma não aceitar o mesmo agente das cargas modernas, e a cobertura acontece por métricas e eventos exportados pela própria plataforma, integrados ao mesmo contexto. O objetivo ali é fechar o buraco na trilha, não igualar a profundidade de instrumentação. Sem esse trecho, a soma da latência fica incompleta justamente onde a liquidação acontece.
De quem é a responsabilidade pela trilha auditável dentro do banco?
A responsabilidade pelo dado é da área de tecnologia, e a responsabilidade pela suficiência da evidência é de risco operacional e de compliance. Quando a definição de prazos, atributos e perfis de acesso fica só com tecnologia, o critério vira técnico, e a auditoria acaba pedindo aquilo que ninguém guardou. Nomear os dois donos antes da implantação evita reprocessamento de histórico depois.
Observabilidade substitui o SIEM e as ferramentas de segurança?
Não substitui. Security Information and Event Management, ou SIEM, existe para correlacionar evento de segurança, detectar ameaça e sustentar resposta a incidente de segurança. Observabilidade existe para explicar comportamento e desempenho de aplicações e infraestrutura. As duas disciplinas consomem frequentemente a mesma fonte de registro, e ainda assim respondem a perguntas diferentes, com públicos e prazos de retenção próprios.
Operar observabilidade em instituição financeira exige diagnóstico, desenho de governança, implantação em ondas e revisão contínua, com o Banco Central e a LGPD como referências permanentes. A Rike IS conduz esse percurso sobre a plataforma Dynatrace, com consultoria, implantação, treinamento e governança de performance continuada, do primeiro inventário de transações críticas até a rotina de revisão, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o mapa das suas transações críticas para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações