

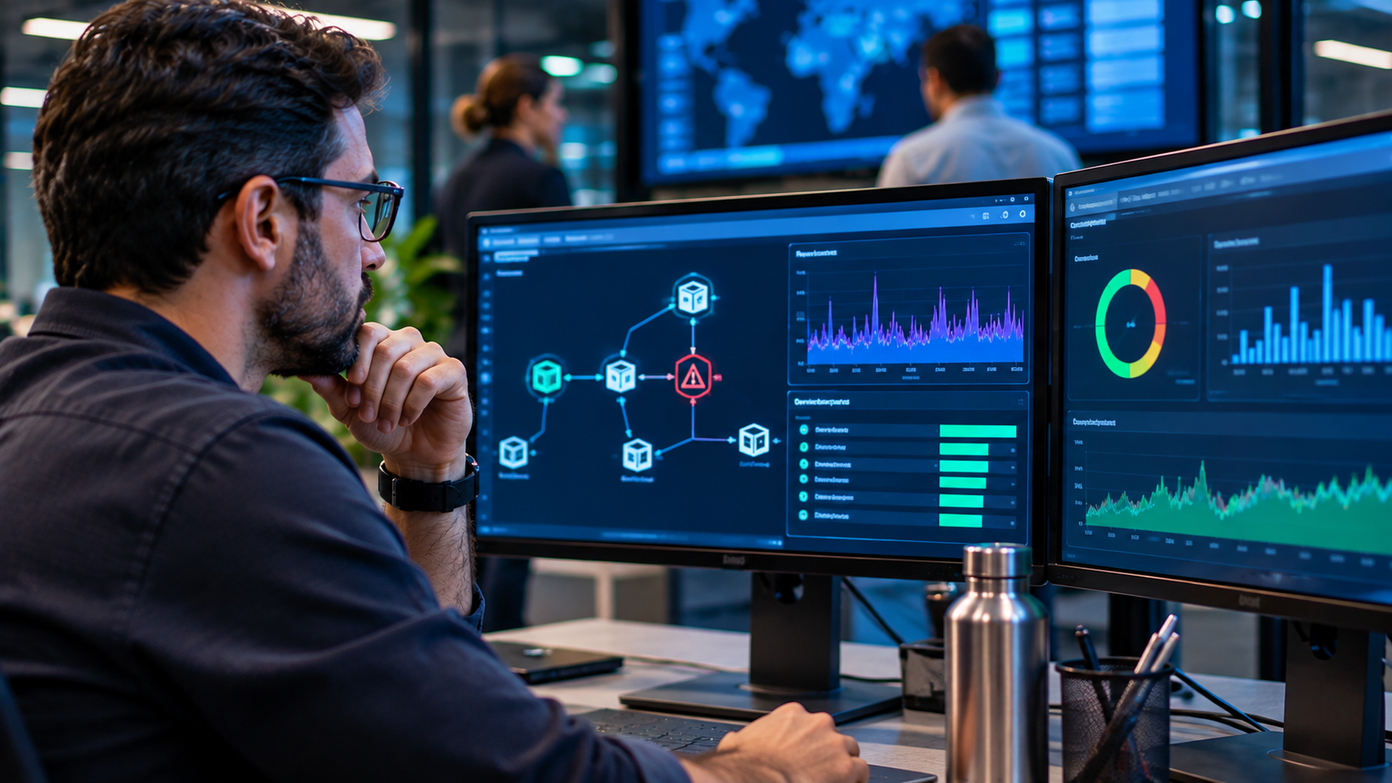
Os benefícios da observabilidade aparecem em quatro campos: operação, custo, conformidade e decisão executiva. A correlação entre métricas, logs e traces sobre um mapa de dependências encurta o tempo entre a falha existir e a equipe entender a causa. Visibilidade chega em semanas, ganho de custo depende de decisão organizacional e maturidade de conformidade leva mais tempo.
O intervalo entre o instante em que uma falha existe e o instante em que a equipe de operações entende por que ela existe determina o custo de indisponibilidade, o cumprimento do acordo de nível de serviço e a exposição a risco regulatório. Encurtar esse intervalo é o que os benefícios da observabilidade têm em comum.
Observabilidade é a capacidade de explicar o estado interno de um sistema a partir dos dados que ele emite, sem precisar instrumentar de novo a cada pergunta nova. Monitoramento responde perguntas previstas na configuração. Observabilidade responde a pergunta que ninguém formulou antes do incidente acontecer, e a diferença aparece no primeiro incidente sem precedente.
Quem defende esse investimento diante da diretoria precisa sustentar três argumentos ao mesmo tempo: tempo de operação recuperado, dinheiro que deixa de ser gasto e risco que sai do relatório de auditoria. Nenhum deles se converte em percentual universal de melhoria.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
O que a observabilidade resolve, na origem
O problema que antecede qualquer benefício tem nome operacional: o tempo gasto entre detectar o sintoma e localizar a causa raiz. Uma organização com muitos sistemas integrados registra o sintoma rápido, porque o usuário reclama e o painel acende. A causa raiz é outra história.
Numa arquitetura distribuída, o sintoma aparece longe da origem. Uma transação lenta no portal do cidadão pode nascer de uma fila congestionada alguns serviços atrás, de um banco sem índice adequado ou de uma chamada a órgão externo que passou a responder devagar. Cada hipótese pertence a uma equipe diferente, e cada equipe olha o próprio painel, que costuma estar verde.
A investigação por comitê é a consequência dessa dispersão de painéis. Várias pessoas de várias áreas entram na chamada, cada uma provando que o problema não está no seu domínio. O tempo passa e a indisponibilidade continua.
A observabilidade ataca esse ponto com dados correlacionados sobre um mapa de dependências, em vez de painéis isolados por camada. Métricas, logs e traces deixam de ser acervos separados e passam a descrever o mesmo evento sob ângulos complementares. Métricas funcionam como o painel do carro, que avisa que algo mudou. Logs são o diário de bordo, que registra o que cada componente fez naquele instante. O trace é o GPS da viagem, mostrando cada parada do trajeto.
Para a diretoria, a correlação sobre mapa de dependências tem uma tradução direta. O tempo médio de detecção e o tempo médio de resolução deixam de depender de quem está de plantão naquela noite. A operação passa a ter processo, não sorte.
Benefícios para a operação
Três ganhos operacionais aparecem com regularidade em ambientes que saíram do monitoramento por camada. Cada um resolve uma dor distinta da equipe de operações.
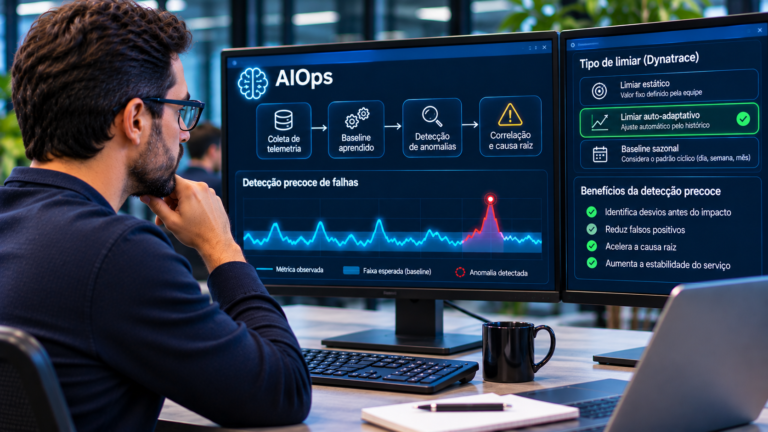
O primeiro ganho é a detecção precoce. Sem correlação, o usuário descobre a falha antes da equipe, e o chamado chega depois que o prejuízo começou. Com dados de todas as camadas sobre a mesma linha do tempo, a degradação aparece enquanto ainda é degradação, antes de virar indisponibilidade completa.
O segundo ganho é a redução expressiva do tempo médio de resolução. Quando o mapa de dependências mostra qual serviço iniciou a cadeia de falhas, a fase de investigação encolhe, e a equipe passa direto para a correção.
O terceiro ganho é o fim do ruído de alerta. Uma falha em componente compartilhado dispara uma enxurrada de notificações em sistemas que apenas sofreram o efeito, e a equipe precisa descobrir sozinha qual delas é a origem. Depois de meses convivendo com alertas que não significam nada, o plantonista aprende a ignorá-los, e o alerta legítimo se perde no meio.
Na plataforma Dynatrace, o motor Davis trata o ruído de alerta por inteligência artificial causal. Essa técnica sustenta a disciplina de Artificial Intelligence for IT Operations, ou AIOps. Davis apoia a análise no Smartscape, o mapa de dependências em tempo real, e identifica o evento gerador. Os efeitos derivados entram em um único problema, com descrição de impacto no negócio. O plantão recebe um alerta, não uma avalanche.
O OneAgent, agente unificado que descobre a stack em execução sem inventário manual, alimenta esse mapa. A IA causal atua na identificação da causa e do contexto do problema, enquanto os dashboards organizam e tornam exploráveis os sinais operacionais.
Existe um ganho menos visível e igualmente relevante. A análise posterior ao incidente passa a trabalhar com evidência registrada, não com reconstrução de memória, e a mesma falha para de voltar a cada trimestre.
Benefícios de custo e previsibilidade orçamentária
O argumento de custo é o que sustenta a aprovação na maioria das organizações, e tem quatro componentes que merecem detalhamento separado. Comitê de orçamento pede número, não convicção.
O primeiro componente é o custo de indisponibilidade evitado. Uma instituição financeira que deixa de processar transações absorve impacto direto de receita e perde confiança de correntistas. Em uma cooperativa de crédito, a mesma parada atinge cooperados que dependem daquele acesso para operar o próprio negócio.
O segundo componente é o recurso superdimensionado. Sem visibilidade de consumo real por serviço, a decisão prudente é sempre a mesma: contratar capacidade acima do necessário, porque ninguém quer explicar uma indisponibilidade causada por economia. Esse excedente entra no orçamento todo ano e nunca é questionado, porque falta o dado que permitiria questioná-lo.
O terceiro componente é o oposto do segundo, e convive com ele no mesmo ambiente: recurso subutilizado que ninguém desliga. Máquinas de projeto encerrado, ambientes de teste esquecidos e réplicas criadas para uma migração já concluída. O inventário automático que o OneAgent produz expõe esses itens sem inspeção manual. Recurso esquecido não gera alerta.
O quarto componente é a previsibilidade orçamentária. Com histórico de consumo correlacionado a volume de transações, a projeção de capacidade deixa de ser estimativa por experiência e passa a ser cálculo sobre série real, e o gerente de infraestrutura chega ao ciclo de planejamento com número defensável.
Há também o custo evitado de investimento errado. Quando a lentidão vem de uma consulta mal escrita, ampliar o parque de servidores gasta orçamento sem resolver nada, e a organização descobre o engano depois da fatura. O Application Performance Monitoring, ou APM, separa degradação de aplicação de saturação de infraestrutura antes que a organização assine a ordem de compra.
Nenhum desses ganhos se converte em percentual universal. Qualquer fornecedor que apresente um número fechado de economia está apresentando o resultado de outra empresa, com outra arquitetura e outro perfil de incidente.
Benefícios de conformidade e risco regulatório
Setores regulados carregam uma exigência que não aparece no discurso comercial de performance: provar o que aconteceu, para quem pergunta depois. Órgãos públicos respondem a controle interno e externo. Instituições financeiras tratam dado pessoal de correntistas sob a Lei Geral de Proteção de Dados, ou LGPD, e respondem ao Banco Central.
A observabilidade entrega três ativos de conformidade que a operação sem instrumentação não consegue produzir.
O primeiro ativo é a trilha auditável. Registro contínuo de quem acessou qual sistema, quando, com qual resultado e qual dado foi tocado no percurso. Reconstruir isso a posteriori, quando o pedido do auditor já chegou, custa semanas de trabalho e ainda assim produz resposta incompleta. Auditoria não aceita memória.
O segundo ativo é a evidência de acordo de nível de serviço, ou SLA. Contratos de disponibilidade preveem multa e obrigação de reporte, e a discussão sobre cumprimento costuma girar em torno de planilhas construídas por lados opostos. Com dados de disponibilidade medidos de forma contínua e independente, a conversa passa a ter fonte única.
O terceiro ativo é a resposta ao período de auditoria sem parada operacional. O Grail retém logs, métricas, traces e eventos em volume massivo, com períodos de retenção que variam conforme o tipo de dado e a configuração adotada, mantendo consulta rápida sobre todo o histórico, e o Dynatrace Query Language, ou DQL, é a linguagem que extrai o recorte pedido. A alternativa é a força-tarefa que retira a equipe de operações do trabalho corrente por semanas.
Para o CIO de um órgão público, esses três ativos mudam a natureza da prestação de contas. Em vez de defender uma posição com argumento, a área apresenta registro. Para o CTO de uma instituição financeira, a mesma trilha reduz o tempo de resposta a demanda regulatória, que costuma chegar com prazo curto e escopo amplo.
Definir quais dados sustentam a trilha auditável, por quanto tempo mantê-los e sob qual convenção de nomenclatura é decisão de arquitetura, tomada antes da instrumentação. A Rike IS conduz esse desenho com tecnologia, risco e auditoria na mesma conversa, desde o diagnóstico do ambiente.
O que cada perfil ganha
Os quatro perfis que convivem com a operação pedem justificativas diferentes, e a mesma capacidade se traduz em ganho distinto para cada um.
Para o CIO, o CTO e o CEO, o ganho central é redução de risco com previsibilidade. Indisponibilidade em sistema crítico atinge receita, reputação e relação com regulador ao mesmo tempo, e a diretoria responde pelos três. O retorno do investimento aparece na soma de indisponibilidade evitada, capacidade não desperdiçada e horas de equipe recuperadas, calculada sobre a série histórica da própria organização.
Para o gerente de infraestrutura, o ganho é controle. Saber o consumo real de cada serviço, projetar capacidade sobre dado observado e provar que a lentidão do mês passado veio da aplicação, não do parque de servidores sob sua responsabilidade.
Para o profissional de DevOps, o ganho está no ciclo de entrega. A equipe passa a avaliar cada implantação por impacto medido em latência e taxa de erro, e a regressão aparece enquanto a reversão ainda é barata. O Digital Experience Monitoring, ou DEM, mostra o efeito da versão nova do lado de quem usa o sistema, não apenas no servidor, e a comparação entre a versão anterior e a nova encurta uma decisão que costuma sair por percepção.
Para o Site Reliability Engineer, ou SRE, o ganho é a causa raiz em minutos, não em turnos. O orçamento de erro deixa de ser um conceito de apresentação e passa a ser indicador consultável, com consequência definida para o próximo ciclo de entregas. O agrupamento por causa raiz devolve o plantão à condição de plantão, em vez de triagem manual de notificações.
Esses quatro ganhos correspondem às cinco capacidades essenciais de uma plataforma de observabilidade operando juntas: APM, monitoramento de infraestrutura e cloud, DEM, AIOps e compliance e governança de performance. Nenhum dos quatro perfis é atendido por uma capacidade isolada.
Existe um efeito que atravessa os quatro perfis e raramente entra na justificativa escrita: a conversa entre as áreas muda de natureza. Com fonte única de dados, a discussão sobre de quem é a culpa dá lugar à discussão sobre qual é a correção.
O que aparece primeiro e o que leva meses
Os benefícios da observabilidade não chegam todos juntos, e a ordem em que aparecem é razoavelmente previsível. Prometer a ordem errada é o que derruba projetos no segundo trimestre.
Nas primeiras semanas depois da implantação inicial, o ganho é de visibilidade. O inventário automático da stack revela componentes que ninguém sabia que existiam, dependências não documentadas e recursos ociosos. Muitas equipes descobrem nesse ponto que o diagrama oficial de arquitetura estava desatualizado há anos.
O agrupamento de alertas por causa raiz aparece logo em seguida, assim que há histórico suficiente para o motor de inteligência artificial causal aprender o comportamento normal do ambiente. O plantão sente a diferença antes de qualquer relatório mostrá-la.
A redução do tempo médio de detecção e do tempo médio de resolução se consolida ao longo dos primeiros meses, conforme a instrumentação cobre os fluxos de negócio realmente críticos. Cobertura uniforme de tudo, com a mesma profundidade, gera volume que ninguém consulta e custo de ingestão sem retorno proporcional.
O ganho de custo demora mais, porque depende de decisão organizacional além do dado. Identificar recurso ocioso leva semanas, e desligá-lo passa por aprovação, janela de mudança e responsável disposto a assinar. A previsibilidade orçamentária só se comprova no ciclo de planejamento seguinte, quando existe série completa para projetar.
A maturidade de conformidade é a que leva mais tempo, e a razão é estrutural: trilha auditável exige governança de atributos consistente desde a origem. O erro mais caro em ambiente já instrumentado costuma ser de convenção, não de tecnologia. Dois times nomeiam o mesmo serviço de formas diferentes, e a consulta que deveria cruzar os dois vira reconciliação manual. Corrigir nomenclatura depois custa reprocessamento.
Projetos que tratam observabilidade como instalação de agente entregam a primeira onda e param ali. Os ganhos de custo e de conformidade dependem de decisões de arquitetura tomadas antes da instrumentação, e corrigi-las depois implica reprocessar dado e refazer painel.
Perguntas frequentes
Observabilidade funciona em ambiente com sistema legado?
Funciona onde a instrumentação alcança o ponto de integração. Sistemas antigos que não aceitam agente ainda entram pelo tráfego que trocam com o resto do ambiente, pelos logs que emitem e pelas transações que atravessam. A profundidade é menor que a de uma aplicação moderna instrumentada, e o ganho aparece na correlação: o legado deixa de ser a caixa que ninguém consegue descartar como hipótese durante um incidente.
Quanto esforço da equipe a operação contínua exige depois da implantação?
O esforço muda de natureza mais do que de tamanho. Alguém precisa manter a convenção de atributos, revisar o que entra em ingestão, ajustar o escopo de alerta quando o ambiente muda e aposentar painel que ninguém consulta. Organizações que não nomeiam esse responsável veem a qualidade do dado cair em poucos ciclos, e os ganhos de custo e de conformidade regridem junto.
Observabilidade ajuda quando a causa raiz está em fornecedor externo?
Ajuda, e esse é um dos usos menos previstos na aprovação do projeto. Quando a lentidão vem de um serviço de terceiro, a correlação mostra onde o tempo foi gasto e separa a responsabilidade contratual da responsabilidade interna. A organização deixa de discutir percepção com o fornecedor e passa a apresentar medição própria, feita do lado de quem consome o serviço.
Quem deve patrocinar um projeto de observabilidade na organização?
O patrocínio funciona melhor quando vem de quem responde pela indisponibilidade diante do conselho, em geral o CIO ou o CTO, com o gerente de infraestrutura como dono operacional. Projetos patrocinados apenas por uma equipe técnica costumam parar quando a instrumentação encosta em outra área, por falta de autoridade para pedir mudança de nomenclatura ou de processo fora do próprio time.
Vale começar por um ambiente piloto ou pelo ambiente crítico?
Começar pelo ambiente crítico dá argumento mais rápido, porque é ali que a indisponibilidade custa e que a diretoria já conhece o histórico de incidentes. Piloto em ambiente secundário atrasa a prova de valor e costuma gerar conclusão que não se repete sob carga real. O caminho intermediário é escolher um fluxo de negócio crítico inteiro, ponta a ponta, em vez de um ambiente inteiro.
Transformar benefício em resultado depende de diagnóstico do ambiente, escolha criteriosa do que instrumentar, governança de atributos e operação contínua ao longo do tempo. A Rike IS conduz esse trabalho sobre a plataforma Dynatrace, com consultoria, implantação, treinamento e governança de performance continuada, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o histórico de incidentes do seu ambiente para uma conversa técnica com os especialistas da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações