

Observabilidade cloud instrumenta recursos efêmeros, autoescala e serviços gerenciados, correlacionando aplicação, contêineres, serviços de nuvem, rede e custo em um modelo único de dados. A descoberta automática substitui o inventário por host, e a convenção de atributos definida antes da coleta é o que sustenta a correlação em ambiente híbrido e multi-cloud.
Enxergar o que a nuvem esconde exige observar recursos que nascem, crescem e desaparecem por decisão automática, sem que ninguém os tenha cadastrado. Máquina virtual de vida curta, contêiner, orquestrador, serviço gerenciado de banco e de mensageria e o custo que cada um gera na fatura compõem o escopo da observabilidade cloud.
A diferença em relação ao monitoramento tradicional está na unidade observada. Monitoramento por host pressupõe que o servidor existe hoje, existirá amanhã e terá o mesmo nome nos dois dias. Nuvem pública quebra as três premissas ao mesmo tempo.
Um grupo de autoescala cria instâncias no pico da manhã e destrói boa parte delas antes do fim do expediente. Ninguém cadastrou essas instâncias, nenhuma delas aparece em planilha de inventário e todas produziram telemetria que precisa continuar disponível depois que o recurso deixou de existir.
A Rike IS conduz consultoria, implantação, treinamento e governança contínua em observabilidade sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte.
O que muda quando a infraestrutura é efêmera
Elasticidade é o mecanismo que a nuvem oferece e é também o que ela esconde.
Em ambiente de datacenter próprio, a equipe de operações conhecia cada servidor pelo nome. A equipe instalava o agente uma vez, montava o painel uma vez e via o inventário mudar em ritmo de compra de hardware. Uma máquina nova entrava em produção depois de semanas de processo, e esse ritmo permitia configuração manual sem prejuízo operacional.
Em nuvem pública, o mesmo inventário muda de minuto a minuto. Um contêiner reiniciado recebe identificador novo. Uma instância substituída por implantação automática apaga o histórico local junto com o disco temporário. Um serviço gerenciado sequer expõe o host onde executa, porque o provedor administra essa camada e entrega apenas um ponto de conexão.
Três consequências práticas aparecem em sequência quando o monitoramento continua ancorado no host.
A primeira é o alerta órfão. O painel dispara indisponibilidade de um recurso que foi encerrado de propósito pela autoescala, e a equipe de operações gasta atenção com um evento que representa comportamento correto do ambiente.
A segunda é o ponto cego temporal. Quando o recurso desaparece, a telemetria armazenada nele desaparece junto, e a investigação de causa raiz perde justamente o intervalo em que o problema aconteceu.
A terceira é a perda de relação entre recurso e negócio. Uma instância identificada por um código gerado pelo provedor não diz qual aplicação executava, qual equipe respondia por ela nem qual transação de negócio dependia daquele processamento.
As três consequências somadas produzem o pior cenário de plantão: alerta em volume alto, dado incompleto e nenhuma pista sobre impacto. No relatório de incidente que chega à diretoria, o efeito visível é o tempo médio de resolução que não cai, mesmo com investimento crescente em nuvem.
As camadas que precisam ser observadas em cloud
Um ambiente em nuvem pública produz sinal em cinco camadas distintas, e cada camada responde a uma pergunta que as demais não respondem. As cinco precisam estar no mesmo modelo de dados.
A primeira é a aplicação. Application Performance Monitoring, ou APM, mede latência por transação, taxa de erro e gargalo dentro do código em execução, sem depender de qual instância atendeu a requisição.
A segunda é a camada de contêineres e orquestração. O orquestrador decide sozinho onde cada carga executa e quando ela reinicia, e essas decisões precisam entrar no mesmo modelo de dados da aplicação, sob pena de a reinicialização de um contêiner aparecer como falha de aplicação.
A terceira é a dos serviços gerenciados. Banco de dados administrado pelo provedor, fila, cache e função sem servidor não aceitam agente instalado. A telemetria vem da interface de métricas do próprio provedor, em AWS, Azure ou Google Cloud, e da instrumentação aberta aplicada no código que consome esses serviços.
A quarta é a rede e a borda. Latência entre zonas de disponibilidade, resolução de nome, balanceamento e política de segurança afetam tempo de resposta sem produzir qualquer sintoma dentro do código da aplicação.
A quinta é o custo. Consumo por recurso, por conta e por etiqueta de identificação é telemetria como qualquer outra, e ganha significado quando fica ao lado das demais em vez de morar em um relatório separado de faturamento.
Correlacionar as cinco é o que diferencia observabilidade de coleta. Métricas isoladas funcionam como o painel do carro: mostram que um indicador saiu da faixa normal, sem dizer qual trecho do trajeto levou até ali. Monitoramento responde se um componente está no ar, e observabilidade responde por que o sistema se comportou daquele jeito.
Em nuvem pública, a exigência de correlação é maior do que em ambiente estático, porque a quantidade de objetos observados cresce com a elasticidade. Um ambiente que multiplica contêineres no pico e os reduz de madrugada não pode depender de painel montado à mão para cada objeto.
Descoberta automática como requisito de operação
Descoberta automática, ou auto-discovery, é a capacidade de detectar sozinho o que entrou em execução, sem cadastro prévio e sem configuração por componente. Em nuvem pública, ela deixa de ser conveniência e passa a ser condição para que o dado exista.
O motivo é aritmético.
Se cada novo contêiner exige uma ação humana de instrumentação, o número de ações cresce junto com a elasticidade do ambiente, e o trabalho manual passa a competir com a própria automação que a nuvem oferece. Instrumentação manual em ambiente elástico produz cobertura desigual: o que subiu durante o expediente é instrumentado, o que subiu na madrugada não é.
Na plataforma Dynatrace, o OneAgent resolve essa condição com uma instalação única por nó ou por imagem base. A partir daí, o agente descobre a stack em execução e passa a instrumentar processos novos assim que eles nascem, sem intervenção por componente.
Smartscape, o mapa de dependências em tempo real da plataforma, mantém a relação entre esses objetos atualizada conforme o ambiente muda. Quando um contêiner é substituído, a relação com a transação de negócio permanece, porque o vínculo está no serviço observado e não no identificador da instância encerrada.
Existe uma segunda via para o que o agente não alcança. OpenTelemetry, padrão aberto e vendor-neutral da CNCF para gerar telemetria, funciona como o padrão USB-C da telemetria. Serviços gerenciados e funções sem servidor entram no modelo por esse caminho, com atributos padronizados que preservam a correlação.
A escolha entre as duas vias segue o tipo de carga. OneAgent cobre o que executa em host, contêiner ou nó de orquestrador. OpenTelemetry cobre o que executa fora do alcance do agente. O modelo híbrido combina as duas vias, e é o arranjo mais comum em nuvem pública.
Observabilidade e custo de cloud
Custo de nuvem é a dor mais frequente do gerente de infraestrutura e também a menos explicada pelos painéis convencionais. A fatura chega consolidada por serviço e por conta, e essa consolidação esconde a informação que interessa: qual aplicação consumiu, em qual horário e com qual retorno.
Dois padrões de desperdício aparecem com regularidade em ambientes elásticos.
O primeiro é o recurso superdimensionado. Uma instância provisionada para o pico de um lançamento permanece no mesmo tamanho meses depois, porque ninguém revisou a decisão e porque nenhum indicador tornou visível a diferença entre capacidade contratada e capacidade usada.
O segundo é o recurso subutilizado por engano de arquitetura. Um cluster mantém nós ociosos porque os limites declarados de memória e processador reservam mais do que a aplicação consome, e o orquestrador respeita a reserva mesmo quando o consumo real fica muito abaixo dela.
Os dois padrões têm a mesma origem: decisão de capacidade tomada sem série histórica de consumo real.
Observabilidade resolve isso quando trata custo como telemetria correlacionada. Consumo de processador e de memória por serviço, ao lado de latência e taxa de erro, permite responder se um recurso pode encolher sem prejudicar a transação que ele sustenta. A pergunta deixa de ser quanto custa o ambiente e passa a ser quanto custa cada transação de negócio.
Grail, a camada de armazenamento e consulta da plataforma Dynatrace, retém logs, métricas, traces e eventos em volume massivo, com períodos de retenção que variam conforme o tipo de dado e a configuração adotada, mantendo consulta rápida sobre todo o histórico. Essa retenção é o que atende setores com obrigação regulatória de guarda. O Dynatrace Query Language, ou DQL, expressa a consulta. Série de meses é o que revela sazonalidade, e sazonalidade é o que separa um pico legítimo de um recurso esquecido ligado.
Há um efeito secundário que costuma passar despercebido. O próprio volume de telemetria coletado em nuvem tem custo, e coletar tudo com a mesma profundidade produz ingestão que ninguém consulta. Governança de atributos e critério de amostragem, definidos antes da implantação, evitam que o instrumento de controle de custo vire uma linha nova de custo.
Dimensionar ambiente elástico com evidência exige série histórica confiável e correlação entre consumo e transação de negócio. A Rike IS conduz esse diagnóstico junto com a equipe de operações do cliente, antes de qualquer decisão de redimensionamento.
Ambiente híbrido e multi-cloud
A maioria das organizações que operam sistemas críticos não migrou tudo, e não pretende migrar. Sistema de registro em datacenter próprio, aplicação nova em nuvem pública e cargas distribuídas entre mais de um provedor convivem no mesmo fluxo de negócio.
Esse arranjo cria um problema de leitura, não de tecnologia.
Quando cada ambiente tem seu próprio painel, a mesma transação aparece fatiada em três lugares, com três relógios, três convenções de nome e nenhuma relação declarada entre as partes. A equipe de operações reconstrói mentalmente o percurso da requisição a cada incidente, e essa reconstrução consome o tempo mais caro do plantão.
Correlação entre ambientes depende de duas decisões tomadas cedo. A primeira é propagação de contexto, o carimbo no passaporte que acompanha a requisição quando ela cruza de um ambiente para outro, mantendo o mesmo identificador de rastreamento do início ao fim. A segunda é convenção semântica de atributos, que garante que provedor, região, conta, aplicação e equipe responsável sejam nomeados do mesmo jeito em toda parte.
Sem essas duas decisões, multi-cloud entrega o pior dos dois mundos: a complexidade de vários provedores e a visibilidade de nenhum.
Com as duas decisões, o provedor vira um atributo entre outros. A pergunta operacional deixa de ser em qual nuvem o problema aconteceu e passa a ser qual serviço degradou e qual transação de negócio sentiu, com a nuvem aparecendo apenas como contexto adicional da análise.
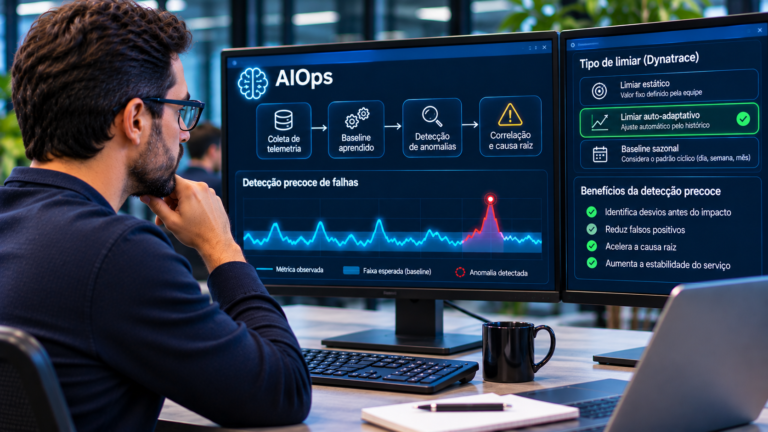
Artificial Intelligence for IT Operations, ou AIOps, opera sobre esse conjunto correlacionado. Davis, que dentro do Dynatrace Intelligence é responsável pela análise causal da plataforma Dynatrace, usa o mapa de dependências para apontar o evento gerador da cadeia de falhas, em vez de listar anomalias por horário. Dashboards organizam e tornam exploráveis os sinais operacionais, enquanto a Dynatrace Intelligence complementa essa análise com detecção de anomalias, correlação e investigação causal para reduzir a triagem e orientar a resposta.
O que muda para cada time
Observabilidade cloud produz quatro efeitos distintos dentro da organização, e cada efeito justifica o investimento por um caminho próprio.
Para o CIO, o CTO e o CEO, o ganho aparece em previsibilidade. Consumo explicado por aplicação transforma a discussão de nuvem em decisão de investimento comparável a qualquer outra, com risco de indisponibilidade e custo de operação medidos na mesma base.
O gerente de infraestrutura ganha a série histórica que faltava para prever capacidade. Redimensionar um recurso deixa de ser aposta e passa a ser consequência de consumo observado, com evidência de que a transação de negócio suportada por aquele recurso não sofreu.
No trabalho de DevOps, a mudança está no ciclo de retorno. Cada implantação em ambiente elástico passa a ter impacto medido em latência, erro e consumo, e a comparação entre a versão anterior e a nova acontece com dado, não com percepção. A regressão aparece enquanto a reversão ainda é barata, em vez de aparecer no chamado do dia seguinte.
Para o Site Reliability Engineer, ou SRE, profissional responsável pela confiabilidade em produção, a mudança é o caminho até a causa raiz. O percurso parte do sintoma percebido pelo usuário, desce ao rastreamento da requisição e chega ao contêiner específico. Ver o estado da infraestrutura naquele instante encurta a fase mais cara do incidente, mesmo quando o contêiner já não existe.
Digital Experience Monitoring, ou DEM, fecha o conjunto ao registrar o que o usuário sentiu, e essa leitura é a única que confirma se a elasticidade cumpriu o papel dela durante o pico.
Por onde começar em ambiente já em produção
Poucas equipes observam ambiente em nuvem a partir do zero. Existe painel montado, existe alerta configurado e existe uma equipe de operações acostumada ao arranjo atual, o que faz de qualquer mudança um trabalho de substituição, não de instalação.
Três decisões precedem a implantação, nesta ordem.
A primeira é definir a convenção de atributos antes de coletar qualquer dado. Nome de aplicação, equipe responsável, ambiente, provedor e conta precisam de valor padronizado, porque atributo corrigido depois obriga a reprocessar dado e a refazer painel.
A segunda é escolher a via de instrumentação por tipo de carga, entre OneAgent, OpenTelemetry e modelo híbrido, com o critério declarado por escrito. Ambiente que mistura máquina virtual, contêiner e função sem servidor costuma terminar no modelo híbrido, e essa escolha fica mais barata quando é deliberada em vez de descoberta no meio da implantação.
A terceira é definir profundidade por criticidade. Transação crítica recebe instrumentação detalhada e retenção longa, enquanto carga secundária recebe cobertura suficiente para diagnóstico, sem gerar volume que ninguém consulta.
Uma quarta ação fecha o trabalho e costuma ser adiada: desligar o que ficou para trás. Painel antigo mantido em paralelo produz duas versões da verdade, e a equipe de operações continua consultando a versão em que confia, que é a antiga.
Perguntas frequentes
Observabilidade em cloud substitui o monitoramento nativo do provedor?
As métricas nativas do provedor continuam úteis como fonte, principalmente para serviços gerenciados que não aceitam agente. O que elas não fazem é ligar aquele número à transação de negócio. A plataforma Dynatrace ingere essas métricas e as coloca no mesmo modelo de dados das demais camadas, em vez de manter mais um painel isolado.
Precisa observar ambiente de homologação ou só produção?
Homologação instrumentada com a mesma convenção de atributos antecipa regressão que só apareceria no cliente final. A profundidade, porém, não precisa ser igual à de produção. Retenção curta e amostragem mais agressiva em ambiente não produtivo entregam o sinal de comparação entre versões sem gerar volume de ingestão que ninguém consulta.
Como observar quando a política de segurança impede instalar agente no nó?
Ambientes com restrição de agente em nó, comuns em órgãos públicos e instituições financeiras, resolvem a coleta por instrumentação dentro da própria aplicação, com OpenTelemetry, e pelas métricas expostas pelo provedor. A cobertura fica menor do que a do OneAgent, e a decisão precisa registrar por escrito o que deixou de ser observado.
Observabilidade de custo de cloud é a mesma coisa que FinOps?
FinOps, a disciplina de gestão financeira de nuvem, decide alocação de orçamento, contrato e responsabilidade por conta. Observabilidade fornece a evidência técnica que sustenta essas decisões: consumo por serviço, ao lado de latência e taxa de erro. Uma disciplina alimenta a outra, e nenhuma das duas substitui a outra.
Quem define a convenção de atributos em observabilidade cloud?
A convenção precisa de um dono nomeado, em geral arquitetura ou a equipe de operações, com poder de recusar implantação fora do padrão. Quando cada time escolhe o próprio nome de aplicação e de ambiente, a correlação quebra na primeira consulta e a correção obriga a reprocessar dado já coletado.
Observar nuvem pública com recursos efêmeros, autoescala e serviços gerenciados exige diagnóstico do ambiente, convenção de atributos definida antes da coleta e governança de performance depois que o dado começa a fluir. A Rike IS conduz esse trabalho do diagnóstico à operação contínua, com consultoria, implantação, treinamento e governança sobre a plataforma Dynatrace, em órgãos públicos, instituições financeiras, cooperativas e empresas privadas de grande porte. Leve o seu ambiente em nuvem para uma conversa técnica com a equipe da Rike IS.
Compartilhe esse conteúdo


RIKE IS Comunicação
Time de comunicação da RIKE IS. Publicamos análises técnicas sobre observabilidade, performance de aplicações e conformidade em ambientes críticos, a partir da experiência em projetos com órgãos públicos e empresas privadas.
Todas as publicações